Привет!
В этой статье я — сисадмин со стажем более 10 лет — расскажу всё, что вам нужно знать про серверы для баз данных. Будет и теория, и практика, и советы из моего опыта.
Если вы собираете развёртывать собственную IT-инфраструктуру и развивать её в будущем, то рано или поздно вам (или вашему техническому специалисту) придётся начать работу с серверами, базами данных (БД) и системами управления базами данных (СУБД).
Ремарка! Современные серверные технологии позволяют работать с базами данных в облачных сервисах по различным подписным сценариям, но это абсолютно другая бизнес-модель как по деньгам (иногда дешевле, иногда дороже), так и по надёжности, так как часто критична не только сохранность, но и конфиденциальность данных. Причём облачные серверы в дата-центрах и физические у вас в серверной можно совмещать в так называемых гибридных инфраструктурах — одно другому не противоречит, и даже напротив — отлично дополняет.
Облачные хранилища, БД и СУБД заслуживают отдельной статьи (а то и нескольких), поэтому здесь я расскажу только про старые добрые физические серверы.
Важно, что БД и СУБД — понятия неразделимые, а вместе они образуют системы баз данных. Не пугайтесь количества терминов — всё запоминать не надо. Но чтобы мы понимали друг друга, я объясню эту терминологию на пальцах простых аналогиях.
Если вы не хотите разбираться в тонкостях админского дела, и (или) уже знаете, что такое и зачем нужны системы баз данных, то сразу переходите к разделу статьи, где я рассказываю, как выбрать сервер для баз данных.
А остальные — заваривайте чего покрепче и присаживайтесь поудобней :)


от 160 356 ₽
5 572 ₽/мес в лизинг
от 131 439 ₽
+ 28 917 НДС

от 27 633 732 ₽
960 272 ₽/мес в лизинг
от 22 650 600 ₽
+ 4 983 132 НДС

от 7 014 756 ₽
243 763 ₽/мес в лизинг
от 5 749 800 ₽
+ 1 264 956 НДС

Продажи прекращены
Продажи прекращены
Что такое база данных
Информационные технологии во многом базируются на точных науках, а потому большинство терминов имеет единую трактовку. Но как бы мне ни хотелось дать универсальное общепризнанное определение БД, его нет. А это значит, что самое время обратиться к глоссарию. В нашем случае — к экспертам из корпорации Oracle. Это крупнейший в мире разработчик корпоративного софта, который с 1977 года развивает свою флагманскую СУБД. По данным авторитетного рейтинга DB-Engines, решения от Oracle стабильно удерживают глобальное лидерство по популярности. В общем, они точно разбираются.
«База данных — это упорядоченный набор структурированной информации или данных, которые обычно хранятся в электронном виде в компьютерной системе. База данных обычно управляется системой управления базами данных (СУБД).
Данные в наиболее распространенных типах современных баз данных обычно хранятся в виде строк и столбцов, формирующих таблицу. Этими данными можно легко управлять, изменять, обновлять, контролировать и упорядочивать».
— Oracle.com
Самая наглядная аналогия реляционным (табличным) базам данных — это крупная классическая библиотека с бумажными книгами.
-
Книжные стойки — это таблицы базы данных.
-
Книжные полки — это столбцы (атрибуты).
-
Конкретные книги — это отдельные записи (строки).
Всё это имеет строгую логику, структуру и связано между собой. Все литературные произведения поделены по эпохам, странам, жанрам и авторам. При этом в соседней секции хранение книг может быть организовано иначе (это аналог другой базы данных — например, NoSQL или векторной, «заточенной» под ИИ-модели).

Хранение информации в базах данных всегда логично, структурировано и решает конкретные бизнес-задачи.
А теперь вспомните какой-нибудь книжный стеллаж в кафе или у дедушки с бабушкой. Книг немного, какие-то авторы стоят по определённой логике, но в целом — хаос. Кто угодно может взять книгу с полки, а полистав, поставить её в рандомное место. Кому-то дали почитать, но кому конкретно — забыли. В этих нюансах и состоит основное отличие БД от обычного хранения данных на жестком диске.

— А где у вас труды Фрейда? — В какой-то из коробок на полу, там ещё 50 оттенков серого и Гарри Поттер сверху.
Получается, что база данных (БД) — это большой объем упорядоченной информации, работать с которой приложение или пользователь должны строго по определённым правилам (протоколам и политикам). А вот за соблюдением этих правил как раз и следит СУБД.
Ремарка! Сегодня базы данных используют не только в обычных офисных/корпоративных приложениях. На них основаны облачные платформы, банковские сервисы, маркетплейсы, телекоммуникационные системы, системы мониторинга, аналитики и искусственного интеллекта. Поэтому требования к скорости работы, масштабируемости и надёжности постоянно растут.
Теперь давайте разберёмся с другим важнейшим понятием — с системой управления базами данных.
Что такое СУБД

Мне нужна твоя книга, кожаный ***.
Начнём с глоссария, а следом к простой аналогии.
«Для базы данных обычно требуется комплексное программное обеспечение, которое называется системой управления базами данных (СУБД). СУБД служит интерфейсом между базой данных и пользователями или программами, предоставляя пользователям возможность получать и обновлять информацию, а также управлять ее упорядочением и оптимизацией. СУБД обеспечивает контроль и управление данными, позволяя выполнять различные административные операции, такие как мониторинг производительности, настройка, а также резервное копирование и восстановление».
— Oracle.com
Продолжим нашу аналогию с библиотекой. Если базы данных — это структурированные книжные секции, то СУБД — это штат высококлассных библиотекарей, работающих днем и ночью, без которых аккуратная библиотека превратится в свалку из тысяч книг.
Поэтому и базам данных нужна система управления базами данных. Ниже в таблице будет сравнение СУБД и реальной библиотеки для наглядности:
Обязанности СУБД | Аналогия с библиотекой | Что это значит на самом деле? |
Предоставление доступа | Открытие дверей, проверка читательских билетов, выдача книг строго по возрасту/прописке. | СУБД проверяет логины/пароли приложений и выдает права по работе с данными. |
Защита и безопасность | Сигнализация, поддержание тишины, закрытие зала на ночь, охрана. | Шифрование данных на лету, антивирусы, фаерволы, защита от хакерских инъекций и изоляция пользователей друг от друга. |
Заполнение и сортировка | Закупка новинок, каталогизация, наведение порядка, уход за книгами и книжными полками. | СУБД сама решает, на какой физический накопитель положить данные, чтобы потом получить к ним доступ как можно быстрее после запроса пользователя или приложения (на основе частоты и количества этих запросов). |
Отказоустойчивость (24/7) | Круглосуточная библиотека, где популярные книги лежат в нескольких экземплярах на разных полках, чтобы к ним всегда был доступ. Редкие фолианты спрятаны в огнеупорном сейфе, а читателям выдают их точные копии. Если в одном из залов прорвет трубу, ремонтная бригада быстро устранит аварию, а читателей переведут в соседнее крыло. | В отличие от простых программ, СУБД защищена от сбоев и потери данных. Она автоматически дублирует данные между несколькими серверами, а при отказе одного из них быстро переключается на резервный. Все изменения предварительно записываются в специальный журнал, поэтому даже после внезапного сбоя систему можно восстановить без потери данных. Одновременно СУБД контролирует параллельные операции, не позволяя нескольким пользователям одновременно изменить одну и ту же запись или дважды купить последний товар. |
Умный поиск (Векторный/ИИ) | Библиотекарь со стажем 50 лет, который знает всё: где, что и как лежит + учитывает вкусы постоянных читателей и может подобрать книгу по запросу, вроде «у вас есть что-то про космос и пришельцев, но реалистичное?». | Современные СУБД тоже умеют искать данные не только по ключевым словам, но и по смыслу с помощью векторных представлений (эмбеддингов, embedding). Это позволяет создавать интеллектуальный поиск, рекомендательные системы, RAG-приложения (Retrieval Augmented Generation) и хранить данные для работы с большими языковыми моделями прямо внутри базы данных. |
Когда большое приложение работает с данными, ему необходимы инструкции, логика и API. Да, можно хранить данные просто в памяти, как на вашем ПК. Можно даже использовать обычный текстовый файл — например, CSV, JSON или XML. По сути, это тоже хранилище данных, а в простейших сценариях его можно считать примитивной базой данных. Для небольших объёмов информации и однопользовательских приложений этого часто достаточно. Но как только появляются постоянные чтение, запись, обновление данных, несколько пользователей или большие объёмы информации, работать с такими файлами становится неудобно и медленно. СУБД как раз решает эти проблемы, предоставляя быстрый поиск, механизмы параллельного доступа, транзакции и множество других возможностей, например, умеют распределять нагрузку между несколькими серверами, выполнять репликацию, автоматически переключаться на резервные узлы при отказах, работать с десятками терабайт данных и обслуживать сотни тысяч одновременных пользователей.
Многие современные СУБД поддерживают контейнеризацию, работу в облачных средах и автоматизированное масштабирование, но для высоконагруженных корпоративных систем старая добрая классика из виртуальных машин с гарантированными вычислительными ресурсами лучше, а то и даже из выделенных физических серверов, чтоб не терять ни капли производительности на эти все гипервизоры и прочую контейнеризацию. Поэтому очевидно, что требования к серверам зависят от выбранной СУБД.
Итого:
База данных (БД) — это само структурированное хранилище (информация).
СУБД — это программная платформа, которая этой информацией управляет, обеспечивает безопасность данных, согласованность, производительность и предоставляет администраторами и приложениям удобный интерфейс для работы с БД.
СУБД + База данных = Система баз данных.
И теперь кратко про систему баз данных.
Что такое система баз данных

Чтобы БД и СУБД работали, нужны ресурсы и инфраструктура: помещение, сервер(ы), сисадмины, софт и другое оборудование. Некоторые непрофессионалы объединяют всё это в одно слово — БД.
Не надо так ¯\_(ツ)_/¯
Когда мы говорим о совокупности всех составляющих, включая инфраструктуру, нужно использовать термин “система баз данных”. В более узком смысле система баз данных — это БД, СУБД и связанные с ними приложения.
Подытожу:
БД — это секции в библиотеке с книгами;
СУБД — это библиотекари;
Система баз данных — это библиотека в целом.
Зачем нужна база данных, СУБД и система баз данных

Когда компания развивается, растёт штат сотрудников и объём данных. Если в классической схеме хранения данных файл лежит там, куда его “положат” до востребования, то в базах данных дополнительно решаются вопросы с структурированием, обработкой, анализом, одновременным доступом и безопасностью информации. Многие процессы автоматизируют, а пользователь даже не знает, как всё устроено.
В целом, на системах баз данных сейчас работает чуть менее чем всё:
-
Интернет-магазины и маркетплейсы;
-
Блоги и социальные сети;
-
Облачные сервисы, ИИ-сервисы и рекомендательные системы;
-
Банки;
-
ERP, CRM и HRM-системы;
-
Системы мониторинга и аналитики;
-
Корпоративные мессенджеры и другие платформы;
-
Мобильные приложения, операционные системы и платформы виртуализации;
-
Любые сервисы, сайты и приложения, где нужно регистрировать личный кабинет (так как эти данные нужно хранить в безопасности изолированно друг от друга).
Даже эта статья хранится в корпоративной базе данных Сервер Молл (на защищенных серверах в наших дата-центрах), откуда вы её и загружаете через сеть, чтобы почитать на обеденном перерыве или у себя на диване. А когда я её писал, она хранилась в базе данных моего компьютера. Такие дела.
Представим ситуацию:Дюжина архитекторов начала одновременно работать над проектом здания объемом 5 ГБ. Им нужно отредактировать проект, и чтобы изменения отображались в реальном времени у всех сразу, не вызывая противоречий (консолидированная модель здания).
Тут нужна система баз данных с клиент-серверной СУБД. У разработчиков (и не только) есть метод управления ресурсами, который хорошо проиллюстрирует, что получится без использования системы баз данных. Называется он бурёнка COW (Copy-on-Write) — при чтении данных используется оригинал (копия не нужна), но при изменениях создаётся новый экземпляр (snapshot), который не влияет на исходные данные:

Одновременное редактирование по принципу COW.
На практике в работе архитекторов это будет выглядеть так:
-
Архитектор открывает файл проекта с локального диска — теперь его коллеги могут просматривать оригинал, но не изменять его;
-
Архитектор редактирует проект — коллеги не видят изменений в реальном времени, а только изначальную версию файла;
-
Один из коллег также начал вносить изменения в проект — API создаёт новый экземпляр файла, не связанный с оригиналом. Все изменения будут сохраняться в новом файле;
-
Архитектор сохраняет изменения в исходном файле и закрывает его;
-
Теперь, если коллеги заново откроют проект, они увидят последние изменения;
-
Тот, кто первый откроет файл — будет работать с оригиналом.
Если в программировании метод COW в некоторых сценариях может оптимизировать ресурсы, то в примере выше такая логика неудобна: работа архитекторов замедляется; можно запутаться в версиях файлов; тяжело синхронизировать изменения, что, вероятно, приведёт к фатальным несоответствиям (коллизиям) при проектировании зданий и т.д.
Более функциональной альтернативой ПК и проекту на локальном диске можно назвать клиент-серверную систему баз данных. Рассмотрим на примере BIM-системы.

В центре у нас сервер (Server), который связывает пользователей, BIM-систему и все данные, создаёт бэкапы, предоставляет и (или) ограничивает доступ к клиентским приложениям и многое другое.
Все 10 архитекторов смогут работать одновременно, не мешая друг другу. Файл проекта один в актуальной версии (на считая бэкапов). Централизованная BIM-модель здания не даст проектировщикам допустить коллизии.
По этому же принципу сегодня работают не только BIM-системы, но и большинство корпоративных приложений: ERP, CRM, банковские системы, интернет-магазины, облачные сервисы и платформы искусственного интеллекта. Пользователь видит только интерфейс приложения, а все операции с данными выполняет система баз данных.
Чем выше нагрузка на систему баз данных, тем выше требования к серверу. Быстрые накопители, большой объём оперативной памяти, производительные процессоры и надёжная сеть — без этого никуда в 2026 году. А потому пора переходить к выбору сервера БД под конкретные задачи.
Как выбрать тип СУБД?

Основные игроки и их продукты.
Нельзя просто купить сервер, а потом решать, что на нём делать. Для начала нужно определиться, как вы будете использовать данные. Типов БД не меньше полусотни, конкретных решений – ещё больше. Тема настолько обширная, что можно пару жизней ей посвятить :) Для желающих изучить поподробнее оставлю ссылку — материал тоже не исчерпывающий, но много нового оттуда точно узнаете.
А я затрону лишь два самых распространённых класса СУБД:

Реляционные, SQL — Structured Query Language.

Все данные связаны между собой и распределены по заранее созданным таблицам (книжная стойка). У всех таблиц есть столбцы (книжные полки) и строки (книги). В общем, всё буквально разложено по полочкам. Поэтому такие БД часто называют табличными.
-
Плюсы: целостность, сохранность (соответствие требованиям ACID) и структурированность данных, богатый бэкграунд SQL даёт огромные функциональные возможности, не зависит от конкретной СУБД;
-
Минусы: сложность, плохая оптимизация в работе с разреженными данными, проблемы с многократными выполнением одинаковых запросов (N+1);
-
Примеры: SQLite, PostgreSQL, MySQL, MariaDB, Microsoft SQL Server, Oracle Database, Postgres Pro, Ред База Данных, Jatoba, Pangolin, Квант-Р.
Нереляционные, NoSQL — not only SQL.

Как вы уже догадались из названия, здесь нет таблиц, строк и столбцов. В NoSQL данные оптимизируются более тонко, под конкретную задачу, а внутри имеют гибкую нетипизированную схему. Понадобилось добавить в документ или поле рандомные данные? Пожалуйста. Такой подход позволяет эффективнее работать с разреженными данными. Нереляционные БД можно поделить на два типа: сетевые и иерархические.
-
Плюсы: большая скорость обработки данных, работа с неструктурированными данными (какие угодно), децентрализация систем, легче и дешевле масштабироваться, чем при SQL, преимущества в шаринге и репликации;
-
Минусы: привязка к конкретной СУБД, ограниченность языков запросов и API, в процессе разработки базы данных могут случаться непредвиденные ошибки (так как схема БД не требуется изначально), миграция с одной БД NoSQL на другую БД NoSQL может стать квестом с препятствиями, понадобятся проприетарные инструменты для работы с БД;
-
Примеры: MongoDB, Cassandra, Redis, Couchbase, ScyllaDB, Tarantool, YDB (Yandex Database), Arenadata Grid (ADG), Picodata.
Подытожу: Приставка No в NoSQL, а также фундаментальные различия с SQL могут навести вас на мысль, что системные архитекторы терзают себя муками выбора. Но на самом деле эти типы БД решают разные задачи.

NewSQL — лучшее из двух миров
NewSQL — относительно новый класс систем управления базами данных, который сочетает преимущества классических реляционных СУБД и современных распределённых NoSQL-решений. Такие системы поддерживают язык SQL и ACID-транзакции (atomicity, consistency, isolation, durability — набор требований к транзакционной системе), но при этом умеют горизонтально масштабироваться сразу на несколько серверов без серьёзной переработки приложений и архитектуры.
Большинство реляционных СУБД изначально проектировали для работы на одном сервере — когда нагрузка возрастала, приходилось увеличивать производительность оборудования (вертикальное масштабирование) или самостоятельно организовывать репликацию, балансировку и шардирование (метод горизонтального масштабирования баз данных, при котором единая таблица или база разбивается на независимые фрагменты aka шарды, размещаемые на разных физических или виртуальных серверах). NewSQL же сразу проектировали для работы с распределёнными архитектурами, а потому многие механизмы (перечисленные выше) сразу встроены в СУБД.
-
Плюсы: поддержка полноценного SQL и ACID-транзакций, автоматическое горизонтальное масштабирование, высокая отказоустойчивость благодаря распределённой архитектуре, совместимость со многими существующими SQL-инструментами, возможность работать одновременно с очень высокой нагрузкой и большими объёмами данных.
-
Минусы: более сложное администрирование по сравнению с традиционными SQL-СУБД, относительно небольшая экосистема по сравнению с теми же PostgreSQL или MySQL, миграция существующих приложений не всегда проходит без доработок, для небольших проектов преимущества часто оказываются избыточными.
-
Примеры: CockroachDB, TiDB, YugabyteDB, SingleStore.
SQL — подходит работы со структурированными данными и для большинства корпоративных приложений, ERP, CRM, финансовых систем и любых задач, где важны целостность данных и сложные запросы.
NoSQL — лучше справляется с большими объёмами слабоструктурированных или неструктурированных данных, высокой скоростью записи и горизонтальным масштабированием.
NewSQL — сочетает преимущества обоих подходов. Такие СУБД выбирают, когда нужны SQL, ACID-транзакции и возможность горизонтального масштабирования.
Выбор конфигурации сервера баз данных

Для большинства компаний сегмента SMB по-прежнему достаточно одного сервера под систему баз данных. Такой вариант проще развёртывать, обслуживать и модернизировать. А раз сервер один, то и эффективность будет полностью зависеть от него. Неправильная конфигурация повлияет на весь бизнес бизнес.
Ремарка! Даже если сейчас вам хватит одного сервера, то не факт, что его хватит через год или несколько. Когда растёт бизнес — растут нагрузки, требования к производительности и отказоустойчивости оборудования.
На этапе проекта и выбора конфигурации сервера нужно закладывать запас ресурсов и возможность вертикального и(или) горизонтального масштабирования.
Сервер(ы) для любых сценариев, будь то БД или аналитика нужно подбираться, исходя из бизнес-задач. К сожалению, ваших задач я не знаю, а потому советы будут конкретными настолько, насколько это возможно. Но вы всегда можете написать в чат на сайте Сервер Молл или позвонить нам — опытные менеджеры изучат ваш проект и подберут решения конкретно под него, учитывая бюджет и другие нюансы.
Итак, когда с задачами, который будет решать сервер, разобрались, можно приступить к конфигурированию. Я очень советую придерживаться принципа «больше — лучше», но без фанатизма (дальше расскажу, как это).
Излишне производительный сервер новейшего поколения может и проблем доставить, вроде огромного энергопотребления и несовместимости с другим оборудованием. Даже лучший админ не сможет сделать идеальный прогноз на 3–5 лет (угадать — да, но без 100% гарантий), так как бизнес по определению должен непрерывно меняться и подстраиваться под конъюнктуру меняющегося рынка — слишком много переменных.
Ну что, переходим к конкретике по конфигурированию сервера:
1) Дисковая подсистема
Мы начинаем с дисковой подсистемы, а не с процессоров или других компонентов, потому что даже мощнейшие CPU или GPU за миллионы рублей (да, такие есть) не смогут компенсировать медленные накопители или неправильно спроектированную систему хранения данных (СХД — по сути специализированный сервер-хранилище, у которого более мощная дисковая подсистема, а не вычислительная часть).
Дисковая подсистема — это все элементы сервера, СХД или любого другого компьютера, которые нужны для долговременного хранения, записи и чтения данных.
На плечах архитектуре дисковой подсистемы сервера лежит скорость, надёжность и эффективность хранения информации. Нагрузка на нее (у развивающегося бизнеса) будет расти перманентно, иногда линейно, а, например, в IT-стартапах — по экспоненте. Поэтому, если мы выбираем сервер для баз данных (БД), дисковая подсистема требует самой жёсткой и тщательной проработки. База данных — это постоянное чтение и запись, а дисковая подсистема — главное узкое горлышко.
Из чего состоит дисковая подсистема классического сервера (основные компоненты):
-
Накопители (HDD и SSD) — устройства, на которых физически хранятся данные. Для сервера БД консьюмерские накопители — например, из вашего домашнего ПК — не подойдут (собрать-то можно, и под некоторые задачи такой франкенштейн даже подойдет, но нужно осознавать все минусы, риски и компромиссы такого решения).
От выбора накопителя зависит не только объем, но и скорость обработки транзакций (IOPS), а также выносливость диска на износ (параметр DWPD). В современные серверы баз данных чаще всего устанавливают корпоративные NVMe SSD — у них минимальные задержки и высочайшая производительность в любых сценариях.
| Тип накопителя | Интерфейс | Форм-фактор (корзина) | Случайные IOPS (R/W) | Средняя задержка | Пропускная способность (послед.) | Рекомендуемые сценарии |
|---|---|---|---|---|---|---|
| HDD SATA | SATA 6 Гбит/с | LFF (3.5") или SFF (2.5") | ~100–200 IOPS | ~5–10 мс | ~150–250 МБ/с | Архивы, бэкапы, холодное хранилище |
| HDD SAS (10K/15K) | SAS 12 Гбит/с (двойной порт) | LFF/SFF (чаще 2.5") | ~200–300 IOPS | ~3–5 мс | ~200–300 МБ/с | Смешанные нагрузки, небольшие БД, замена HDD |
| SSD SATA | SATA 6 Гбит/с | SFF (2.5") | ~50–80 тыс. IOPS | ~100–200 мкс | ~550 МБ/с | Легкие БД, виртуализация, кэширование |
| SSD SAS | SAS 12 Гбит/с (dual-port) | SFF (2.5") | ~100–150 тыс. IOPS | ~100–150 мкс | ~800–1200 МБ/с | Высоконагруженные OLTP, критичные к задержкам |
| NVMe SSD | PCIe 4.0/5.0/6.0 (x4 или x8) | SFF (U.2/U.3) или EDSFF (E1.S/E3.S) | >1 млн IOPS (чтение), ~500k+ (запись) | ~20–50 мкс (средняя) | до 7–14 ГБ/с (Gen4), до 14+ (Gen5) | OLTP высокой интенсивности, аналитика в реальном времени, журналы транзакций |
| NVMe SSD (EDSFF) | PCIe 4.0/5.0/6.0 (x4/x8) | E1.S, E3.S (реже E1.L) | Аналогично NVMe SSD | Аналогично NVMe SSD | Аналогично NVMe SSD | Максимальная плотность и производительность в 1U/2U, AI/ML, высоконагруженные БД |
Какие накопители выбрать для сервера баз данных?
Для максимальной производительности СУБД (будь то PostgreSQL, MS SQL или Oracle) сегодня используют исключительно NVMe SSD на шине PCIe Gen4/Gen5. Их объединяют в RAID-массивы через специализированные контроллеры или используют программный RAID, чтобы получить миллионы IOPS и минимальный отклик вместе с отказоустойчивостью — чтобы при сбое диска продолжать работу без простоев.
Старые добрые HDD (жесткие диски) из-за их низких цен и предсказуемости всё ещё в строю, но теперь их удел в серверах БД — это скорее хранение архивных копий (бэкапов), холодных логов или тяжёлых исторических данных, к которым обращаются раз в месяц.
-
Интерфейсы накопителей — определяют, как накопитель общается с контроллером и процессором. От него зависят максимальная пропускная способность, задержки при работе с данными и количество операций ввода-вывода, которые сможет обработать сервер. Сегодня в корпоративных серверах используют три основных интерфейса в разных поколениях: SATA, SAS и NVMe.
SATA создавался для домашних компьютеров и недорогих систем хранения. Даже последняя версия SATA III ограничена пропускной способностью 6 Гбит/с (около 550 МБ/с), а протокол AHCI не рассчитан на современные SSD с высокой интенсивностью случайных операций. Поэтому SATA сегодня подходит в основном для архивов, резервных копий и других задач, где производительность не критична.
SAS — корпоративный интерфейс, который обеспечивает более высокую производительность, надёжность и поддерживает подключение большого количества накопителей. Он остаётся востребованным в существующей инфраструктуре и системах хранения с десятками или сотнями HDD, однако по скорости и задержкам уже заметно уступает NVMe.
NVMe — современный стандарт для высокопроизводительных серверов баз данных. В отличие от SATA и SAS, он работает напрямую через шину PCI Express, обеспечивая значительно более высокую пропускную способность, минимальные задержки и эффективную обработку большого количества параллельных запросов. Именно поэтому NVMe SSD сегодня стали стандартом для большинства новых проектов, связанных с высоконагруженными СУБД.
Какие интерфейсы выбрать для сервера баз данных:
| Интерфейс | Версия | Полезная пропускная способность | Средняя латентность (SSD) | Рекомендуемые сценарии |
|---|---|---|---|---|
| SATA III | 6 Гбит/с | ~550 МБ/с | 100–200 мкс | Архивы, бэкапы, холодное хранилище |
| SAS-3 | 12 Гбит/с | 1,2 ГБ/с (дуплекс 2,4 ГБ/с) | 100–150 мкс | Смешанные нагрузки, виртуализация, легаси |
| SAS-4 | 22,5 Гбит/с | 2,4 ГБ/с (дуплекс 4,8 ГБ/с) | 80–120 мкс | Переходные системы, где ещё есть SAS-инфраструктура |
| NVMe Gen4 | PCIe 4.0 x4 | До 8 ГБ/с | 20–50 мкс | OLTP, аналитика в реальном времени, журналы |
| NVMe Gen5 | PCIe 5.0 x4 | До 16 ГБ/с | 15–30 мкс | AI/ML, высокочастотная торговля, экстремальная БД |
Рынок на месте не стоит. PCIe 6.0 уже утверждён и даёт 64 ГБ/с — этого хватит даже для самых требовательных СУБД и ИИ-приложений. Интересно, что хоть и SAS чувствует себя не важно, но продолжает развитие — SAS-4.1 вышел в 2023 году, и активно ведётся работа над SAS-5.
Параллельно развивается CXL (Compute Express Link) — это стандарт интерконнекта, появившийся в 2019 году. Он позволяет: эффективнее работать с памятью и вычислениями более эффективно за счёт поддержки когерентного кэша и трафика между процессорами и ускорителями; собирать IT-инфраструктуру как конструктор, гибко распределяя ресурсы; объединять память в общий пул, доступный всем компонентам системы (Memory Pooling); дезагрегировать ресурсы, делая их доступными в масштабах ЦОДа (Disaggregation); обеспечивать когерентность памяти и трафика, что позволяет устройствам работать с одной и той же областью памяти без противоречий в данных.
CXL использует физическую и электрическую основу PCIe, но предлагает свои протоколы (CXL.io, CXL.cache, CXL.mem) и работает, начиная с PCIe 5.0. Технология важна для бизнеса, так как повышает утилизацию оборудования и снижает расходы на инфраструктуру.
При выборе сервера учитывайте, что поддержка NVMe зависит не только от самих накопителей, но и от дисковых корзин и контроллеров. Переделать сервер с SAS-корзиной под NVMe после покупки невозможно.
-
Дисковая корзина — физическое посадочное место в корпусе сервера. Что-то вроде гаражного кооператива для накопителей. Производители делают одни и те же серверы с разными корзинами (выбирается на этапе поставки и не меняется при эксплуатации): под LFF (3.5-дюймовые, обычно для емких HDD), под SFF (2.5-дюймовые, чаще под скоростные SSD, но и HDD такие есть) или под U.2 / U.3 (2,5-дюймовые корпоративные SSD с интерфейсом PCIe или SAS, поддерживающие горячую замену и высокую производительность, но требующие специального backplane*), а также есть комбинированные корзины для одновременной работы накопителей разных типов (например, несколько SFF и несколько LFF, SATA/SAS и NVMe).
*Backplane (в дословном переводе — задняя панель) — это, грубо говоря, плоская плата с разъёмами, которая работает как распределительный щиток или удлинитель для накопителей.
Например, вы вставляете жёсткий диск или SSD в корзину (отсек) сервера. Сзади этой корзины как раз и стоит backplane. Когда диск задвигается до конца, его разъём (SATA/SAS/NVMe) втыкается прямо в разъём на backplane. Диск не подключается отдельными кабелями или к материнской плате — вместо этого все диски подключаются к одной общей плате. По дорожкам этой платы передаются данные от каждого диска к RAID-контроллеру или напрямую к процессору (через PCIe). По тем же дорожкам подаётся питание на все диски (обычно от блока питания сервера). То есть вместо кучи шлейфов от каждого диска к материнской плате — одна аккуратная плата внутри корпуса. Именно благодаря backplane вы можете вытащить неисправный диск и вставить новый, не выключая и не разбирая сервер (замена на горячую).
У некоторых backplane есть возможность переключать режимы работы между SATA, SAS и NVMe. Также дисковые корзины различаются по количеству отсеков (от 4 до 24 и более в стандартных 1U/2U шасси), по глубине (для поддержки длинных карт расширения или дополнительного охлаждения) и по типу салазок (винтовые, безвинтовые, с быстрым креплением).
Последнее время набирают популярность корзины под относительно свежий форм-фактор SSF — EDSFF, с вариантами E1.S, E1.L, E3.S и т. д., которые отличаются длиной, шириной и способом подключения. Это может быть небольшая корзина сзади корпуса — например, в Dell PowerEdge R670 так можно разместить до 2 x EDSFF E3.S NVMe накопителей — помимо основной корзины, а на серверах формата 2U (вроде Dell R760/R770) сзади можно развернуть отдельный модуль под 4 x E3.S Gen5. Но это может быть и обычная корзина спереди, для высокоплотной нагрузки c поддержкой PCIe 5.0. В том же R760 вольготно себя чувствуют 16 E3.S SSD, а в более свежем R770 уже можно напихать 40 (!) SSD, и это только спереди.
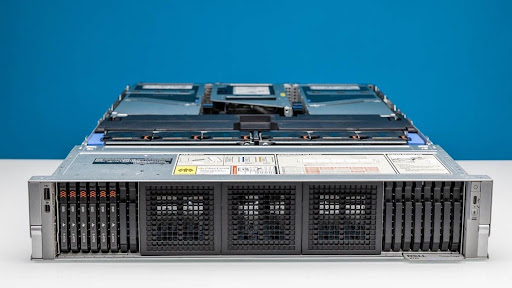
Обратите внимание, что диски тоньше, чем 2,5 (SFF) — это и есть EDSFF
Какую дисковую корзину выбрать для сервера баз данных?
| Характеристика | Для максимальной производительности | Для баланса цены и скорости | Для максимального объема |
|---|---|---|---|
| Форм-фактор накопителей | EDSFF (E3.S) или SFF (U.2/U.3) | SFF (2.5") | LFF (3.5") |
| Тип накопителей | NVMe SSD | SAS/SATA SSD | HDD (SAS или SATA) |
| Количество накопителей (можно и больше под задачу) | 8–16 | 4–8 | 6–24 |
| Для каких задач БД | Высоконагруженные OLTP, аналитика, AI/ML | Средние БД, виртуализация, смешанные нагрузки | Архивы, бэкапы, холодные данные |
| Ключевое преимущество | Экстремальная скорость и низкие задержки | Отличная производительность за разумные деньги | Максимальная емкость при минимальной стоимости |
| Ключевое ограничение | Самая высокая стоимость, требует дорогого сервера | Уступает в скорости NVMe | Очень низкая скорость при случайных операциях (IOPS) |
| Поддержка Hot-Swap | Да | Да | Да |

от 33 484 464 ₽
1 163 585 ₽/мес в лизинг
от 27 446 282 ₽
+ 6 038 182 НДС

от 17 333 272 ₽
602 331 ₽/мес в лизинг
от 14 207 600 ₽
+ 3 125 672 НДС

от 181 776 ₽
6 317 ₽/мес в лизинг
от 148 997 ₽
+ 32 779 НДС

от 19 600 032 ₽
681 101 ₽/мес в лизинг
от 16 065 600 ₽
+ 3 534 432 НДС
-
Дисковые контроллеры (RAID-контроллеры) и массивы — это специализированные аппаратные устройства или программы, отвечающие за взаимодействие между сервером и накопителями. Они объединяют физические диски в логические RAID-массивы (Redundant Array of Independent Disks) разных уровней или работают в режиме JBOD (Just a Bunch Of Disks), чтобы повысить производительность, обеспечить отказоустойчивость или увеличить полезную ёмкость. Контроллеры также постоянно мониторят состояние каждого накопителя (через SMART, ошибки чтения/записи) и управляют восстановлением данных при сбоях.
Уровни RAID — компромисс на компромиссе
-
RAID 0 — максимальная производительность и ёмкость, но нулевая отказоустойчивость (отказ любого диска убивает массив).
-
RAID 1 — зеркало из двух дисков, надёжно, но дорого (половина ёмкости теряется).
-
RAID 5 — экономит место (один диск под контрольные суммы), но запись медленная из-за вычислений XOR, а время восстановления на больших HDD может растягиваться на сутки — в это время вероятность отказа второго диска высока, а скорость работы в режиме деградации оставляет желать лучшего. Никому не советую.
-
RAID 6 — терпит два отказа, ещё медленнее запись, но безопаснее на больших массивах.
-
RAID 10 (1+0) — сочетает зеркалирование и чередование, даёт отличную производительность и надёжность, но съедает половину ёмкости.
Для NVMe-массивов поддержку аппаратного RAID на контроллере или на процессоре подвезли относительно недавно, и исторически его редко используют, отказываясь в пользу распределённых систем хранения (Ceph, MinIO, HDFS), где избыточность обеспечивается на уровне узлов, а контроллер работает как обычный HBA.
Сегодня RAID-контроллеры используют повсеместно в серверах, а в 2026 набирают популярность трехрежимные контроллеры (Tri-Mode RAID) — они поддерживают одновременную работу с дисками SAS, SATA и NVMe в одних и тех же портах (обычно через разъём SFF-8639 или U.2), но с нюансами: большинство таких контроллеров работают в едином режиме для всех подключённых дисков (либо все NVMe, либо все SAS/SATA) — смешивание типов в одном массиве редко поддерживается.
| Аппаратный vs программный RAID |
|---|
| Аппаратный RAID — имеет собственный процессор и кэш, не нагружает центральный процессор сервера, предлагает высокую производительность и независимость от ОС. Однако он дорогой и привязан к конкретному вендору. |
| Программный RAID (mdadm в Linux, Storage Spaces в Windows, ZFS) использует вычислительные ресурсы CPU, но по сути бесплатен, гибок и не зависит от контроллеров. Современные многоядерные процессоры легко справляются с расчётами контрольных сумм, поэтому программные решения всё чаще выбирают даже для относительно больших распределённых систем. |
От выбранной архитектуры хранения напрямую зависят производительность, доступность данных и возможность продолжить работу при отказе одного или нескольких накопителей.
Современные аппаратные RAID-контроллеры имеют свою оперативную память (кэш) — от 512 МБ до нескольких гигабайт — для временного хранения данных при операциях записи и чтения. Чтобы защитить данные в кэше при сбоях, используют либо литий-ионные батарейные модули (BBU), либо более современные суперконденсаторы + флеш-память (они не требуют периодической замены батарей, но тоже требуют мониторинга). Без такой защиты включение высокопроизводительного режима Write-Back (данные пишутся сначала в кэш, а потом на диски) крайне рискованно — при сбое питания можно потерять ещё не сброшенные данные. Альтернативный режим Write-Through (запись сразу на диски) безопаснее, но и медленнее.
Не путайте RAID-контроллер и HBA (Host Bus Adapter) — последний лишь простой адаптер, который подключает диски к системе в режиме прямой передачи (passthrough/JBOD). Многие современные RAID-контроллеры умеют переключаться в режим HBA — это полезно при использовании ПО, вроде ZFS, Ceph или mdadm, где всю логику избыточности берёт на себя операционная система. В тоже время важно обратить внимание — не все контроллеры умеют переключаться, и если вам нужен именно режим HBA — это то, на что стоит обратить внимание при выборе сервера.
2) Сетевые адаптеры и интерфейсы
Дисковая подсистема (со всеми её накопителями, интерфейсами и т.д.) важна во внутренней логике работы сервера. Но так как системы баз данных — это целый комплекс устройств и ПО, важно поговорить про сетевые адаптеры и интерфейсы.
Для малого бизнеса эта часть не столь полезна, так как стандартных плат на 2–4 порта по 1–10 Гбит/с хватает с головой для большинства задач. Если же сервер работает с быстрыми NVMe-массивами, участвует в репликации, резервном копировании больших объёмов данных или входит в кластер, лучше сразу начинать с сетевого адаптера на 25 Гбит/c (на сервер) и 40–100 Гбит/с на аплинк к ядру. Стоит 25 Гбит/c не сильно дороже 10 Гбит/c, а запас какой-никакой будет.
Но вот у среднего и крупного запросы пожирнее — кластеры СУБД, тяжёлые AI/ML-вычисления, GPU-фермы, HPC или в системах хранения с NVMe over Fabrics. Там уже ставят 25–100 Гбит/с и выше (на сервер) и 100 Гбит/с на агрегацию.
Неподготовленный читатель может начать зевать на этом моменте, поэтому предлагаю вам два стула пути: простой — листайте до таблицы с рекомендациями чуть ниже; сложный — почитайте про сетевые технологии в другой моей статье на Хабре: «Искал медь, а нашёл оптику — экономика апгрейда до 1,6 Тбит/с».
Итак, при построении отказоустойчивых кластеров, использовании SAN или NVMe-oF смотрите на поддержку RDMA (RoCEv2) — эта технология уменьшает задержки передачи данных и снижает нагрузку на процессор.
ВАЖНО! Если вы выбираете 25 Гбит/c для кластера БД (MSSQL Always On, Oracle RAC или PostgreSQL с Patroni) — наличие RDMA обязательно. Без RDMA вы получите высокую скорость, но у процессора уйдёт 30–40% ядер/потоков на обработку сетевых прерываний, что съест производительность всей базы.
Какие сетевые интерфейсы выбрать для сервера баз данных?
| Сценарий | Что выбрать |
|---|---|
| Небольшая БД, файловый сервер, до нескольких десятков пользователей. Если это виртуальная машина на гипервизоре, где одна физическая 10 Гбит/с сеть делится на 10 виртуалок, то для небольшой БД лучше выделить отдельный 1 Гбит/c порт (или SR-IOV), чем шарить 10 Гбит/c со всеми. | 1–10 Гбит/c (можно 25 Гбит/с c прицелом на будущем) |
| Корпоративная современная БД, виртуализация, резервное копирование, репликация | 10–25 Гбит/c |
| Высоконагруженная БД, кластер, NVMe-массивы | 25–100 Гбит/c |
| Распределённые СХД, NVMe-oF, крупные ЦОДы | 100–200 Гбит/c и выше |
Совет! Планируйте в сервере свободные PCIe-слоты для установки нескольких сетевых плат — хорошо, когда можно проапгрейдить сервер, а не покупать новый, если нагрузка слегка возросла.
3) Оперативная память (RAM, ОЗУ)
Раньше этого раздел можно было описать парой предложений: «Для максимальной производительности БД выбирают быструю память, последние поколения серверов, а также серверные базы, в которые можно установить много планок ОЗУ (для масштабирования в будущем). А также анализ всей системы — тесты и ещё раз тесты».
Потому что раньше память была относительно недорогим расходником, на котором почти никто не экономил. Объём памяти сильно влияет на производительность сервера баз данных: если рабочие данные не помещаются в оперативную память, сервер чаще обращается к накопителям, что приводит к общему снижению производительности.
В 2026 году это больше не работает, так как цены на DDR5 улетели в мультивселенную и продолжают пробивать рекорды от месяца к месяцу — по касательной задело и DDR4 (которая в новых устройствах не используется, только в серверах предыдущих поколений), и даже богом забытую DDR3. Всё из-за высокого спроса со стороны компаний, развивающих свои ИИ-продукты: ChatGPT, Gemini, Grok и прочие.
DDR5 или DDR4 для сервера баз данных?
Если максимальная производительность не так критична, то восстановленный сервер предыдущих поколений с большим объёмом DDR4 будет выгоднее и лучше, чем новый сервер с небольшим объёмом DDR5.
Поэтому в 2026 году серверы с DDR4 для баз данных не просто можно рассматривать, но и нужно. Однако всё зависит от масштаба бизнеса и характера нагрузки.
Память DDR4 всё ещё актуальна, так процессоры прошлых поколений (например, Intel Xeon Scalable 2-го и 3-го поколений или AMD EPYC 2-го и 3-го поколений) в избытке лежат на складах и продаются в составе восстановленных серверов (Refurbished) — стоят они в разы дешевле новинок и не уступают в надёжности. Мы в Сервер Молл предлагаем на них выездную гарантию до 5 лет — на 2 года больше, чем на новые от производителей.
Если вы малый бизнес и ваша задача звучит так — 1С:Предприятие на 10–50 пользователей, небольшие CRM, базы данных сайтов на MySQL/PostgreSQL, — то вам 100% подходит DDR4 (и с огромным запасом). А высвободившийся бюджет лучше вложите в надёжные и быстрые NVMe-накопители и хорошую систему бэкапов.
Второй вариант — вы растущая компания (средний бизнес): 1С на 100–300 одновременных пользователей, ERP-системы, активно растущие интернет-магазины, базы данных с объемом в сотни гигабайт. DDR4 всё ещё подходит, но здесь уже важно брать максимальную для DDR4 частоту (3200 МГц) и заполнять все каналы памяти процессора (6 или 8 планок на один процессор), чтобы не резать пропускную способность. Для большинства СУБД среднего бизнеса критичнее иметь пул памяти (чтобы вся база или её горячая часть помещалась в ОЗУ), чем сверхвысокую скорость DDR5. А набрать 256 или 512 ГБ на DDR4 выйдет несравнимо дешевле. Но если бюджет позволяет, можно смотреть и на DDR5.
Примеры отличных серверов на DDR4 для БД: Dell PowerEdge R740 / R740xd (2U); HPE ProLiant DL380 Gen10 / Gen10 Plus (2U); Dell PowerEdge R550 (2U).
Третий вариант — крупный бизнес и Enterprise: ритейл с тысячами транзакций в секунду, банковские системы, биллинг, крупные аналитические базы (Data Warehouses), Highload-проекты. Тут DDR4 подойдёт только для второстепенных задач.
Когда у вас тысячи тяжелых параллельных запросов в секунду к СУБД, процессор тратит много времени на ожидание данных из памяти (процессорное бутылочное горлышко). DDR5 за счет своей пропускной способности раскрывает потенциал современных 128-ядерных (и выше) процессоров. DDR5 выдает примерно в 1.5–2 раза больше ГБ/с, чем DDR4. Для баз данных, которые постоянно перелопачивают гигабайты информации в оперативной памяти (In-Memory вычисления, тяжелые JOIN-запросы), это критично.
Примеры отличных серверов на DDR5 для БД: Dell PowerEdge R760 / R770 (2U); HPE ProLiant DL380 Gen11 (2U); Dell PowerEdge R660 (1U).
Ну и последний, но не по важности, вопрос: какой объём оперативной памяти выбрать для сервера баз данных?
| Сценарий | Минимальный объём |
|---|---|
| Небольшая корпоративная БД | 32–64 ГБ |
| Средняя нагрузка, виртуализация | 128–256 ГБ |
| Высоконагруженная БД | 256–512 ГБ |
| In-memory БД, аналитика | От 512 ГБ и выше |
Совет (или скорее закон для сервера БД)! Равномерно заполняйте каналы памяти — это открывает процессору одновременный доступ ко всем физическим магистралям передачи данных. Если установить только одну или две планки вместо заполнения всей архитектуры, пропускная способность подсистемы памяти упадет в несколько раз. База данных на сервере с восемью планками по 32 ГБ выполнит тяжелый отчет в несколько раз быстрее, чем на том же сервере всего с двумя планками по 128 ГБ, хотя общий объем памяти будет одинаковым.
И не гонитесь за тактовой частотой, если бюджет ограничен — для БД сначала определите требуемый размер буферного кэша (чтобы вся активная БД влезла в RAM), затем обеспечьте скорость записи лога транзакций (быстрый RAID 10 на NVMe), и только потом смотрите на ядра процессора. При этом сетевая карта должна поддерживать RDMA, если вы планируете кластеризацию.
4) Процессор (CPU, ЦПУ) для сервера баз данных
При выборе процессора для сервера баз данных нужно смотреть на несколько характеристик.
Количество ядер. Определяет, сколько параллельных запросов сможет одновременно обрабатывать сервер. Для OLTP-нагрузок (1С, CRM, ERP, интернет-магазины) важна высокая частота отдельных ядер, а для аналитики, виртуализации и быстрого анализа больших массивов информации (OLAP) нужны процессоры с большим количеством ядер. Не гонитесь за тактовой частотой в ущерб количеству ядер. Современные СУБД умеют распараллеливать запросы (например, PostgreSQL с max_parallel_workers). Если у вас база на 500 ГБ и много одновременных чтений, 64 ядра с частотой 2.5 ГГц будут эффективнее, чем 16 ядер на 4.0 ГГц.
Кэш. Чем больше кэш L3 (и другие уровни тоже), тем меньше процессор обращается к оперативной памяти. Для OLTP-нагрузок (индексные поиски, точечные чтения) и т.д. — это крайне важно.
Память и каналы. Именно процессор определяет, какое количество каналов памяти, максимальный объём ОЗУ и поколение DDR поддерживает сервер. Всё это напрямую влияет на производительность тяжёлых запросов и аналитических операций. Например, процессор с 8 каналами (AMD EPYC) при одинаковой частоте памяти даст почти на 30% больше пропускной способности, чем с 6 каналами (старые Xeon), а от этого зависит скорость тяжёлых агрегаций и сортировок.
Количество линий PCI Express. От этого зависит, сколько NVMe-накопителей, сетевых адаптеров и других устройств можно установить, не упираясь в пропускную способность.
Два сокета vs один сокет. Для большинства средних задач достаточно одного мощного процессора (меньше задержек из-за межсокетных коммуникаций). Два сокета оправданы только при экстремальной нагрузке (тысячи активных сессий) или когда нужно больше 64 ядер, а один AMD EPYC 9654 (96 ядер) может закрыть и это. Для 1С и типовых ERP один сокет часто даже предпочтительнее, но с современными процессорами AMD важно потратить время на настройку NUMA под ваши потребности. Процессор имеет внутреннюю архитектуру, хоть сокет и один — и позволяет настраивать количество NUMA-узлов (как правило это 1–4). Для высокопроизводительной СУБД правильная настройка может дать существенный прирост скорости.
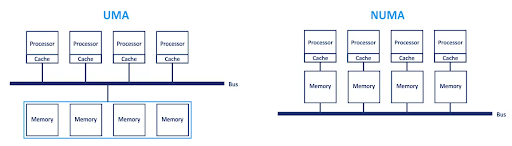
NUMA-узел (от англ. Non-Uniform Memory Access — «неоднородный доступ к памяти») — это логическая группа, на которые делится система в рамках архитектуры NUMA. Проще говоря, это часть сервера или многопроцессорной системы, которая включает в себя один или несколько процессоров (часто целый физический сокет) и локальную для них память.
Какой процессор выбрать для сервера баз данных?
| Сценарий | Типичная нагрузка | Рекомендуемое количество ядер | Оптимальные платформы |
|---|---|---|---|
| Малый бизнес | 1С (10–50 пользователей), небольшие CRM, сайты, MySQL/PostgreSQL | 8–16 |
DDR4: Intel Xeon Scalable 2–3 поколения, AMD EPYC Rome/Milan.
DDR5: младшие Intel Xeon 6, AMD EPYC 9004/9005 |
| Средний бизнес | 1С (100–300 пользователей), ERP, интернет-магазины, корпоративные БД, виртуализация | 24–32 |
DDR4: AMD EPYC Milan, Intel Xeon Scalable 3 поколения.
DDR5: Intel Xeon 6, AMD EPYC Turin |
| Enterprise | Банковские системы, биллинг, Data Warehouse, аналитика, Highload | 48+ | Intel Xeon 6, AMD EPYC Turin (DDR5), при необходимости — двухпроцессорные серверы |
Совет. Производительность сервера баз данных всегда зависит от баланса компонентов. Сервер с 24 ядрами, 512 ГБ оперативной памяти и быстрыми NVMe SSD может быть намного быстрее сервера с 64 ядрами, но малым объёмом DDR4 и медленной дисковой подсистемой.
Характеристики серверов под популярные БД
Дальше мы рассмотрим примерные характеристики серверов под популярные СУБД: Microsoft SQL, MySQL, SQL и PostgreSQL.
Не забывайте, что для каждой конкретной задачи нужно подбирать комплектующие персонализировано, а не по таблицам. Например, при работе с большими объёмами данных может потребоваться более мощный процессор или больший объём оперативной памяти. Также стоит учитывать возможность масштабирования системы и горизонтального распределения нагрузки между несколькими серверами.
Важно также следить за актуальностью используемых версий баз данных и рекомендаций производителей оборудования, чтобы обеспечить максимальную производительность и надёжность системы.
Если есть сложности с подбором сервера под вашу задачу, то обращайтесь к менеджерам Servermall. Это быстро и бесплатно :)
Сервер для Microsoft SQL Server
Microsoft SQL Server — это реляционная СУБД, разработанная компанией Microsoft. SQL Server — одна из самых популярных баз данных в мире и используется во многих крупных компаниях. Она имеет множество функций для управления данными и предоставляет мощные инструменты для анализа и обработки данных.
Для установки и запуска Microsoft SQL Server на сервере рекомендуется следующие минимальные характеристики:
-
Процессор с тактовой частотой не менее 1,4 ГГц (рекомендуется 2,0 ГГц и выше).
-
Оперативная память не менее 1 Гб (рекомендуется 4 Гб и выше).
-
Накопитель объёмом не менее 6 Гб для установки SQL Server и дополнительного места для хранения данных.
-
Операционная система Windows Server 2012 или выше.
Однако, для обеспечения высокой производительности и надёжности базы данных Microsoft SQL Server рекомендуется использовать сервер с более продвинутыми характеристиками, например:
-
Процессор с частотой не менее 2,0 ГГц и не менее 4 ядер (рекомендуется использовать многоядерные процессоры).
-
Оперативная память не менее 16 Гб (рекомендуется 32 Гб и выше).
-
Наличие RAID-массивов для обеспечения отказоустойчивости и скорости доступа к данным.
-
Сетевой интерфейс с высокой пропускной способностью для обеспечения быстрого доступа к базе данных.
-
Операционная система Windows Server 2012 или выше, оптимизированная для работы с Microsoft SQL Server.
Кроме того, рекомендуется правильно настроить параметры конфигурации Microsoft SQL Server для достижения наилучшей производительности и надёжности базы данных. Например, можно настроить буферизацию запросов, настройки кэша, оптимизацию запросов и другие параметры, учитывая специфику работы вашей базы данных.
Сервер для MySQL
MySQL — это свободная реляционная база данных, разработанная компанией Oracle. Это одна из самых популярных реляционных СУБД с открытым исходным кодом. Она широко используется во многих приложениях, таких как блоги, интернет-магазины и форумы. Она используется во многих веб-приложениях и сайтах, в том числе в WordPress, Joomla и Drupal.
Для установки и запуска MySQL на сервере рекомендуется следующие минимальные характеристики:
-
Процессор с тактовой частотой не менее 1 ГГц (рекомендуется 2 ГГц и выше).
-
Оперативная память не менее 1 Гб (рекомендуется 4 Гб и выше).
-
Накопитель объёмом не менее 1 Гб для установки MySQL, а для хранения данных рекомендуется использовать дополнительный накопитель или RAID-массивы.
-
Операционная система семейства Linux, Windows или macOS.
-
Установленный MySQL с необходимыми драйверами и инструментами для работы с базой данных.
Однако, для обеспечения высокой производительности и надёжности базы данных MySQL рекомендуется использовать сервер с более высокими характеристиками, например:
-
Процессор с частотой не менее 2 ГГц и не менее 2 ядер (рекомендуется использовать многоядерные процессоры).
-
Оперативная память не менее 8 Гб (рекомендуется 16 Гб и выше).
-
Наличие RAID-массивов для обеспечения отказоустойчивости и скорости доступа к данным.
-
Сетевой интерфейс с высокой пропускной способностью для обеспечения быстрого доступа к базе данных.
-
Операционная система семейства Linux, Windows или macOS, оптимизированная для работы с MySQL.
Кроме того, рекомендуется правильно настроить параметры конфигурации MySQL для достижения наилучшей производительности и надёжности базы данных. Например, можно настроить буферизацию запросов, настройки кэша, оптимизацию запросов и другие параметры, учитывая специфику работы вашей базы данных.
Сервер для PostgreSQL
PostgreSQL — это свободная объектно-реляционная система управления базами данных (СУБД) с открытым исходным кодом, которая широко используется в приложениях, где требуется высокая производительность и надёжность, в том числе в веб-приложениях и корпоративных приложениях.
Для PostgreSQL рекомендуемые минимальные характеристики сервера зависят от того, какой объем данных будет обрабатываться и сколько пользователей будет иметь доступ к базе данных.
В целом, для установки PostgreSQL на сервер требуется следующее:
-
Процессор с тактовой частотой не менее 1 ГГц (рекомендуется 2 ГГц и выше).
-
Оперативная память не менее 1 Гб (рекомендуется 4 Гб и выше).
-
Накопитель объёмом не менее 10 Гб (рекомендуется использовать RAID-массивы для обеспечения отказоустойчивости и скорости доступа к данным).
-
Операционная система семейства Linux, Windows или macOS.
-
Установленный PostgreSQL с необходимыми драйверами и инструментами для работы с базой данных.
Для обеспечения высокой производительности и доступности базы данных PostgreSQL рекомендуется использовать сервер с более высокими характеристиками, например:
-
Процессор с частотой не менее 2 ГГц и не менее 2 ядер (рекомендуется использовать многоядерные процессоры).
-
Оперативная память не менее 8 Гб (рекомендуется 16 Гб и выше).
-
Наличие RAID-массивов для обеспечения отказоустойчивости и скорости доступа к данным.
-
Сетевой интерфейс с высокой пропускной способностью для обеспечения быстрого доступа к базе данных.
-
Операционная система семейства Linux, Windows или macOS, оптимизированная для работы с PostgreSQL.
Также, для обеспечения надежности и безопасности базы данных PostgreSQL рекомендуется регулярно выполнять резервное копирование данных, использовать SSL-сертификаты для защиты передаваемой информации и обновлять версию PostgreSQL и ее компоненты до последней доступной версии.
Характеристики серверов БД по количеству пользователей
Количество пользователей, использующих базу данных, является важным фактором при выборе характеристик сервера. Чем больше пользователей, тем больше требуется ресурсов для поддержки нагрузки на базу данных. В таблицах ниже приведены примерные характеристики серверов для баз данных различного размера и количества пользователей.
Фактические требования зависят от конкретной реализации базы данных, количества и типа запросов, ресурсов приложения и других факторов (например, версий ПО).
ВАЖНО!
Каждая СУБД имеет свои особенности, которые влияют на её производительность и скорость обработки запросов.
Например, MySQL обеспечивает быстрое выполнение запросов и может масштабироваться на большое количество пользователей, но может иметь проблемы с производительностью при работе с большими объёмами данных.
В то же время, PostgreSQL может обрабатывать большие объёмы данных и предоставляет мощные инструменты для управления данными, но может иметь проблемы с производительностью при выполнении сложных запросов.
Microsoft SQL Server предоставляет широкий спектр функций и инструментов для управления данными, а также обеспечивает высокую производительность при работе с крупными объёмами данных и многопользовательскими приложениями. Однако, для обеспечения высокой производительности и отказоустойчивости может потребоваться дополнительное оборудование и конфигурация серверов.
MySQL
|
Количество пользователей |
Объем базы данных |
Процессор |
Оперативная память |
От 4 накопителей в RAID 10 |
Сетевая карта |
|
1-100 |
1-5 ГБ |
2 ядра |
2-4 ГБ |
100 ГБ |
1 Gb Ethernet |
|
100-1000 |
5-50 ГБ |
4 ядра |
8-16 ГБ |
500 ГБ |
1 Gb Ethernet |
|
1000-10000 |
50-500 ГБ |
8 ядер |
32-64 ГБ |
1 ТБ |
10 Gb Ethernet |
|
10000-100000 |
500-5000 ГБ |
16 ядер |
128-256 ГБ |
10 ТБ |
10 Gb Ethernet |
|
100000+ |
5000+ ГБ |
32 ядра |
512+ ГБ |
100+ ТБ |
40 Gb Ethernet |
Важно:
-
MySQL может быть установлен на разных операционных системах, включая Windows, Linux и MacOS;
-
MySQL требует меньше оперативной памяти и процессорных ресурсов, чем SQL Server, но больше, чем некоторые другие СУБД с открытым исходным кодом;
-
MySQL обычно хранит данные в файловой системе, что может привести к быстрому заполнению накопителя. Поэтому для MySQL также рекомендуется использовать RAID-массивы для обеспечения надёжности и доступности данных;
-
MySQL хорошо масштабируется и может работать на кластерах серверов для обеспечения высокой доступности и производительности;
-
Чтобы подобрать оптимальный сервер под вашу задачу, обращайтесь к менеджерам Servermall. Сделают всё в лучшем виде — быстро и бесплатно.
Microsoft SQL Server
|
Количество пользователей |
Объем базы данных |
Процессор |
Оперативная память |
От 4 накопителей в RAID 10 |
Сетевая карта |
|
1-100 |
1-5 ГБ |
4 ядра |
4 ГБ |
100 ГБ |
1 Gb Ethernet |
|
100-1000 |
5-50 ГБ |
4-8 ядер |
8-16 ГБ |
500 ГБ |
1 Gb Ethernet |
|
1000-10000 |
50-500 ГБ |
8 ядер |
32-64 ГБ |
1 ТБ |
10 Gb Ethernet |
|
10000-100000 |
500-5000 ГБ |
16 ядер |
128-256 ГБ |
10 ТБ |
10 Gb Ethernet |
|
100000+ |
5000+ ГБ |
32 ядра |
512+ ГБ |
100+ ТБ |
40 Gb Ethernet |
Важно:
-
Microsoft SQL Server требует много оперативной памяти и процессорных ресурсов для обработки больших объемов данных и нагрузки от многопользовательских приложений;
-
Microsoft SQL Server предоставляет функции высокой доступности и отказоустойчивости, включая кластеризацию серверов и репликацию данных;
-
Microsoft SQL Server требует много дискового пространства для хранения данных. Рекомендуется использовать RAID-массивы для обеспечения надежности и доступности данных;
-
Microsoft SQL Server поддерживает множество функций для управления данными, таких как полнотекстовый поиск, географические данные и хранимые процедуры;
-
Чтобы подобрать оптимальный сервер под вашу задачу, обращайтесь к менеджерам СЕРВЕР МОЛЛ. Сделают всё в лучшем виде — быстро и бесплатно.
Продажи прекращены
Продажи прекращены

от 20 040 208 ₽
696 397 ₽/мес в лизинг
от 16 426 400 ₽
+ 3 613 808 НДС
от 160 356 ₽
5 572 ₽/мес в лизинг
от 131 439 ₽
+ 28 917 НДС

от 298 535 ₽
10 374 ₽/мес в лизинг
от 244 701 ₽
+ 53 834 НДС
PostgreSQL
|
Количество пользователей |
Объем базы данных |
Процессор |
Оперативная память |
От 4 накопителей в RAID 10 |
Сетевая карта |
|
1-100 |
1-5 ГБ |
2 ядра |
2-4 ГБ |
100 ГБ |
1 Gb Ethernet |
|
100-1000 |
5-50 ГБ |
4 ядра |
8-16 ГБ |
500 ГБ |
1 Gb Ethernet |
|
1000-10000 |
50-500 ГБ |
8 ядер |
32-64 ГБ |
1 ТБ |
10 Gb Ethernet |
|
10000-100000 |
500-5000 ГБ |
16 ядер |
128-256 ГБ |
10 ТБ |
10 Gb Ethernet |
|
100000+ |
5000+ ГБ |
32 ядра |
512+ ГБ |
100+ ТБ |
40 Gb Ethernet |
Важно:
-
PostgreSQL может быть установлен на разных операционных системах, включая Windows, Linux и MacOS;
-
PostgreSQL требует много оперативной памяти и процессорных ресурсов для обработки больших объемов данных и многопользовательской нагрузки;
-
PostgreSQL предоставляет мощные функции для управления данными, такие как JSON-хранилище, географические данные и расширяемость через хранимые процедуры;
-
PostgreSQL хранит данные в файлах, что может привести к быстрому заполнению накопителя. Поэтому для PostgreSQL также рекомендуется использовать RAID-массивы для обеспечения надежности и доступности данных;
-
Чтобы подобрать оптимальный сервер под вашу задачу, обращайтесь к менеджерам СЕРВЕР МОЛЛ. Сделают всё в лучшем виде — быстро и бесплатно.
Безопасность баз данных

Информационная безопасность — это головная боль миллионов специалистов, инженеров и системных архитекторов по всему миру. Киберпреступления с каждым годом учащаются, а главная проблема заключается в трилемме безопасности, функциональности и доступности (так называемый парадокс Андерсона):
-
Чем безопаснее база данных, тем она менее функциональна и доступна для конечного пользователя;
-
Чем функциональнее и доступнее база данных, тем она менее защищена.
Поэтому безопасность базы данных — это во многом компромисс. Но решать его нужно, чтобы не оказаться в неприятной ситуации, как Facebook (Meta) и другие компании, когда личные данные тысяч и миллионов пользователей утекают в сеть. А всё что попадает в сеть, как известно, остаётся там навсегда.
Что ж, безопасность — мера комплексная и организуется сразу на нескольких уровнях:
-
Безопасность на физическом уровне. Сюда входит безопасное расположение серверов для баз данных, а также надёжное оборудование. Про это можно много написать, но если вкратце, то выбирайте надёжное помещение со СКУД, а также оборудование надёжных брендов + резервирование. Второй вариант — облачные услуги, но в таком случае о полной приватности и безопасности данных говорить не приходится.
-
Ограничение прав и контроль доступа. Чтобы обеспечить максимальную безопасность, нужно выдавать доступ к базе данных только тем пользователям, которым он действительно необходим. При этом права нужно ограничить до минимального набора, необходимого для выполнения задач. Помните парадокс Андерсона? Он самый во всей красе.
-
Мониторинг. Даже самые защищенные системы могут подвергаться атакам и другим действиям злоумышленников. Преднастроенные системы мониторинга могут в автоматическом режиме отправлять алёрты о странных событиях и подозрительных действиях с данными
-
Шифрование. В эпоху киберпреступлений процветает снифферинг (от англ. sniff “нюхать”) — хищение данных. Поэтому все хранящиеся и передаваемые данные нужно защищать шифрованием. При этом очень важно соблюдать правила по управлению ключами шифрования (Encryption Key Management). Потеряете ключи — потеряете данные.
-
Безопасность ПО базы данных. Есть пользователи, которые используют пиратские и (или) неактуальные версии софта. Патчи безопасности выпускают не для того, чтобы замучить сисадмина обновлениями.
-
Безопасность узлов. Прочность всей цепи оценивается по самому слабому звену. Именно эти звенья и ищут злоумышленники. Если к вашей базе данных подключено множество устройств, например, веб-сервер или сервер приложений, то каждое из них должно непрерывно тестироваться на безопасность и наличие уязвимостей.
-
Безопасность резервных копий. Зачастую все силы по обеспечению безопасности вкладываются в основную систему, но не стоит забывать про резервные копии. Доступ злоумышленников к ним может причинить не меньший вред и ущерб предприятию.
Что в итоге?
База данных создаётся и управляется специальным программным обеспечением — СУБД. Вся эта система в комплексе образует систему баз данных, от которой и зависит производительность многих приложений и бизнес-процессов.
При проектировании систем баз данных ошибки могут стать большой проблемой, особенно, если мы говорим о реляционных базах. К сожалению, избежать их сложно, учитывая, что компания будет использовать систему баз данных на протяжении многих лет.
Скорее всего ваш выбор СУБД упадёт либо на реляционные, либо на нереляционные. В отдельных случаях крупные предприятия используют гибридные системы, для оптимизации производительности.
Выбор железа всегда происходит от задачи. Параметров много, но особое внимание нужно уделить дисковой подсистеме, сетевым параметра, ОЗУ и, разумеется, ЦПУ.
И не забывайте про безопасность — это убережёт вас и ваши данные от многих проблем.