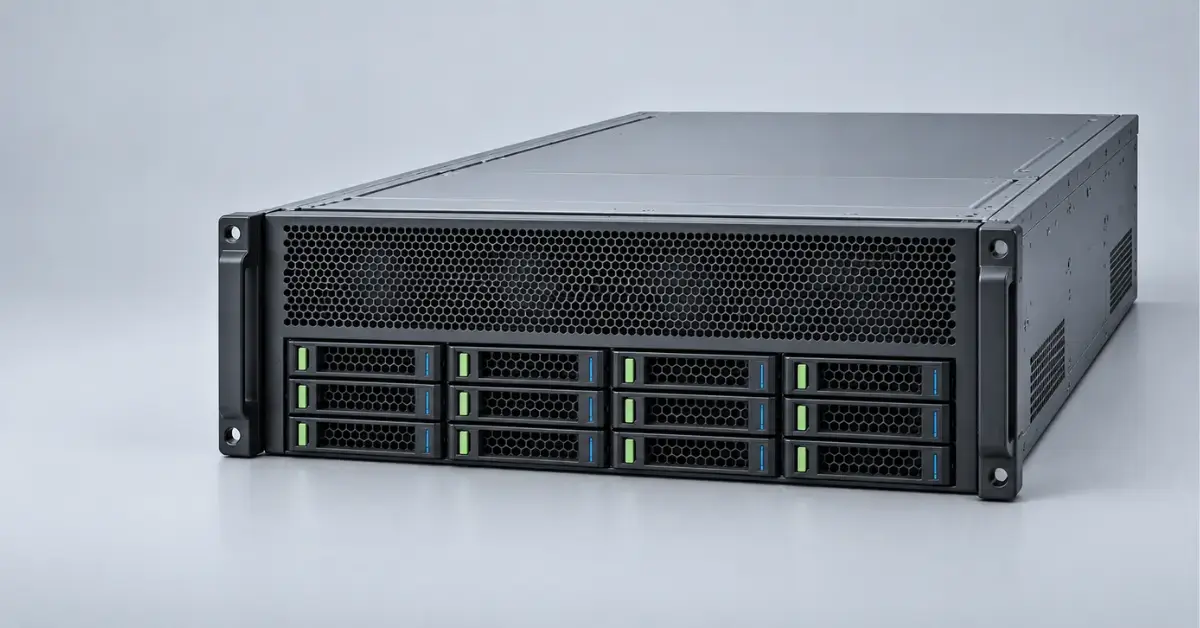
HPE ProLiant DL380a — это специализированный сервер для вычислений на GPU, а не обычный DL380 с увеличенным числом видеокарт. У модели два поколения: компактный DL380a Gen11 в корпусе 2U поддерживает до четырёх двухслотовых ускорителей, а DL380a Gen12 занимает 4U и рассчитан на более высокую плотность — до десяти двухслотовых GPU в совместимой конфигурации. Gen11 разумно выбирать, когда важны плотность стойки и умеренный масштаб проекта; Gen12 — когда требуются самые современные ускорители, больший запас по питанию и охлаждению и дальнейшее наращивание GPU.
Что означает индекс «a» в названии DL380a
Буква «a» означает, что платформа оптимизирована под ускорители. Это влияет не только на количество разъёмов PCIe. Внутренняя компоновка, воздушные каналы, вентиляторы, распределение питания и райзеры проектируются вокруг GPU, которые могут потреблять сотни ватт каждый.
В архитектуре DL380a:
- процессоры и память обслуживают подготовку данных и задачи, которые нельзя перенести на GPU;
- линии PCIe распределяются так, чтобы ускорители не делили узкое соединение без необходимости;
- блоки питания и силовая часть рассчитаны на резкие изменения потребления GPU;
- локальная дисковая подсистема уступает часть пространства ускорителям и охлаждению;
- сетевые адаптеры должны обеспечивать подачу данных без простоя дорогих вычислительных ресурсов.
Поэтому DL380a нельзя оценивать только по числу ядер и объёму оперативной памяти. Для него важнее вся система: модель ускорителя, объём его памяти, топология PCIe, скорость сети, локальные NVMe, потребление стойки и способность дата-центра отвести тепло.
Какие поколения HPE ProLiant DL380a существуют
Серийная линия DL380a начинается с Gen11 и продолжается Gen12. Отдельных моделей DL380a Gen9, Gen10 и Gen10 Plus не было. Серверы DL380 этих поколений могли работать с графическими ускорителями, однако оставались универсальными платформами. Индекс «a» обозначает отдельную архитектуру, а не комплект расширения для любого DL380.
Если нужна история универсальной модели для виртуализации, баз данных и развитого локального хранения, она разобрана отдельно в статье «HPE ProLiant DL380: сравнение поколений Gen9–Gen12». Там же объясняется различие между DL380 Gen12 и DL380a Gen12.
Сравнение DL380a Gen11 и Gen12
| Параметр | DL380a Gen11 | DL380a Gen12 |
|---|---|---|
| Форм-фактор | 2U, два процессора | 4U, два процессора |
| Процессоры | Intel Xeon Scalable 4-го и 5-го поколений, до 64 ядер на процессор в совместимых конфигурациях | Intel Xeon 6, до 144 ядер на процессор в актуальной линейке |
| Память | DDR5, 24 слота DIMM, до 6 ТБ в максимальной совместимой конфигурации | DDR5, 32 слота DIMM; максимальный объём зависит от CPU и редакции QuickSpecs |
| Ускорители | До 4 двухслотовых или 8 однослотовых GPU | Несколько шасси: до 10 двухслотовых либо до 16 однослотовых GPU; ограничения зависят от модели карты |
| Шина расширения | PCIe 5.0; до четырёх линий x16 для GPU и два разъёма OCP в соответствующей сборке | PCIe 5.0; больше GPU-зон и варианты сбалансированного распределения ввода-вывода между CPU |
| Накопители | До 8 передних SFF или EDSFF в зависимости от корзины | До 8 SFF NVMe или до 16 EDSFF в совместимой конфигурации |
| Управление | HPE iLO 6 | HPE iLO 7 в актуальных конфигурациях Gen12 |
| Основная роль | Инференс, VDI, рендеринг и вычисления с умеренной плотностью GPU | Плотный инференс, генеративный ИИ, дообучение, видеоаналитика и масштабные GPU-сервисы |
Максимальные характеристики в таблице нельзя складывать в одну произвольную конфигурацию. Предельное число GPU может потребовать определённого шасси, набора райзеров, блоков питания и режима охлаждения. Часть процессоров или ускорителей несовместима с отдельными вариантами корпуса.
HPE ProLiant DL380a Gen11: четыре мощных GPU в 2U
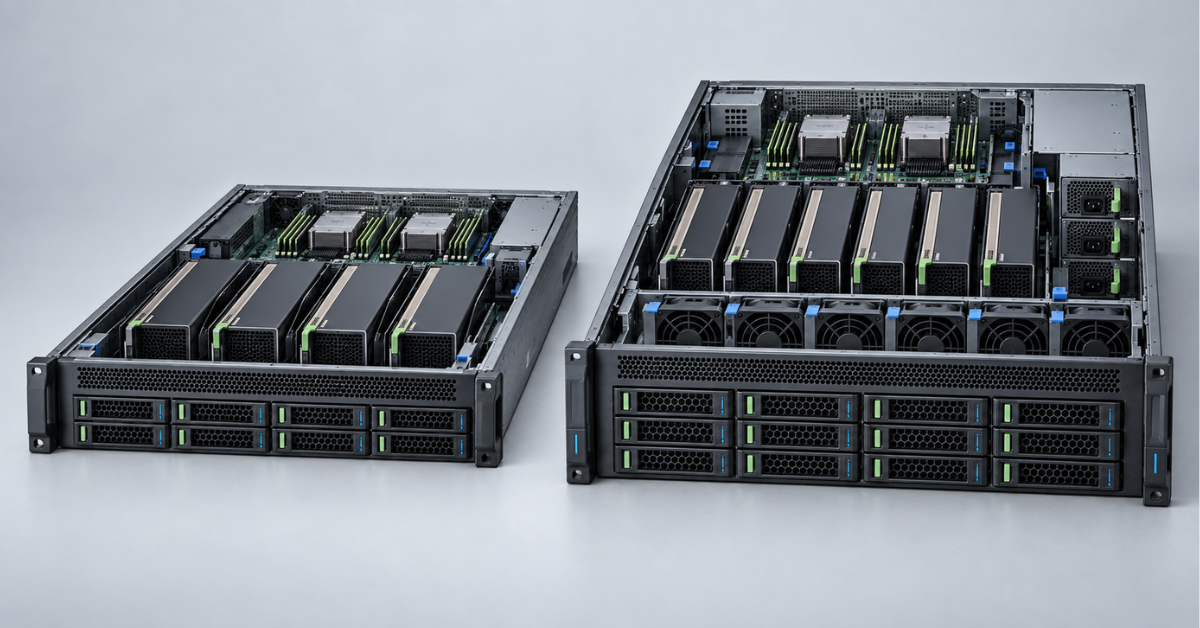
DL380a Gen11 построен как двухпроцессорная 2U-платформа на Intel Xeon Scalable четвёртого и пятого поколений. Поддержка DDR5 и PCIe 5.0 позволила увеличить пропускную способность между CPU, памятью, сетью и ускорителями. Главная особенность — размещение до четырёх двухслотовых или восьми однослотовых GPU без перехода к 4U-корпусу.
Такой формат удобен, когда в стойке уже есть несколько серверов, а проекту не нужен максимально возможный парк ускорителей в одном узле. Четыре GPU подходят для инференса, компьютерного зрения, VDI с графикой, рендеринга, инженерного моделирования и части задач дообучения. При этом итоговая производительность определяется не количеством карт, а их памятью и способом обмена данными.

Процессоры, память и ввод-вывод
Архитектура Gen11 включает:
- два процессора Intel Xeon Scalable для выполнения CPU-этапов конвейера и подключения необходимого числа линий PCIe;
- 24 слота DDR5, обеспечивающих больший объём и пропускную способность по сравнению с платформами эпохи DDR4;
- PCIe 5.0, который вдвое увеличивает пропускную способность линии относительно PCIe 4.0 при одинаковом числе линий;
- два разъёма OCP, позволяющие вынести сеть из основных слотов PCIe и сохранить их для ускорителей.
Для DL380a Gen11 особенно важен баланс по NUMA: GPU и сетевой адаптер должны быть логично распределены между двумя процессорами. Если весь поток данных приходит через один CPU, а часть ускорителей подключена ко второму, межпроцессорный обмен может стать скрытым ограничением.
Ограничения Gen11
Преимущество корпуса 2U одновременно создаёт ограничения. Четыре двухслотовых ускорителя занимают большую часть доступного объёма, поэтому возможности дискового расширения скромнее, чем у обычного DL380. Высокопроизводительные GPU требуют точной комбинации блоков питания, кабелей и вентиляторов, а допустимая мощность карты зависит от конкретной CTO-сборки.
При выборе Gen11 следует учитывать несколько особенностей:
- расширение свыше четырёх двухслотовых GPU потребует второго узла или перехода на Gen12;
- новейшие ускорители могут отсутствовать в поздней матрице совместимости Gen11;
- воздушное охлаждение в 2U предъявляет строгие требования к температуре входящего воздуха и свободному прохождению потока;
- при кластерном росте понадобятся высокоскоростная сеть и внешнее хранилище, иначе новые узлы не обеспечат ожидаемого ускорения.
HPE ProLiant Compute DL380a Gen12: переход к 4U
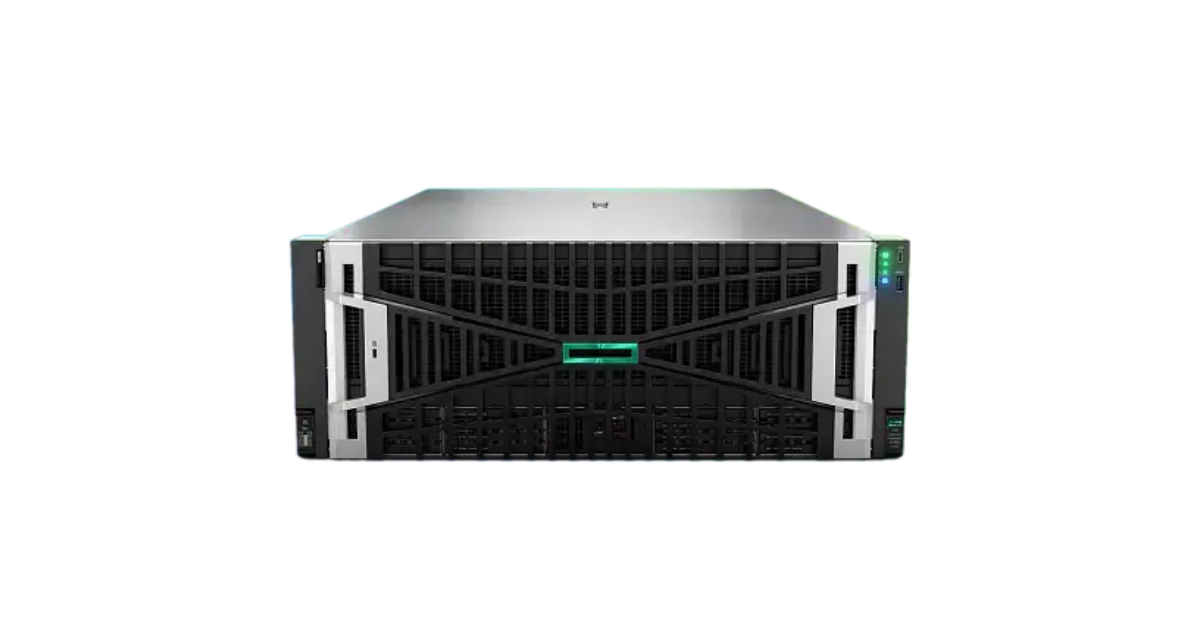
Источник изображения: Сервер Молл
В Gen12 HPE изменила не только процессоры, но и масштаб платформы. DL380a Gen12 занимает 4U, использует два Intel Xeon 6, память DDR5 и PCIe 5.0. Дополнительная высота отдана GPU-зонам, питанию и охлаждению. Поэтому Gen12 следует сравнивать с Gen11 по вычислительной плотности всей системы, а не по числу юнитов одного корпуса.
Актуальная страница модели доступна в каталоге Servermall: HPE ProLiant DL380a Gen12. Для конкретной сборки с быстрыми дисками можно отдельно изучить конфигурацию DL380a Gen12 8SFF NVMe.
Почему встречаются цифры 8 и 10 GPU
В ранних материалах DL380a Gen12 часто описывался как сервер на восемь двухслотовых ускорителей. В актуальных QuickSpecs присутствуют разные CTO-шасси, включая варианты до десяти двухслотовых или до шестнадцати однослотовых GPU. Это не означает, что любую карту можно установить в максимальном количестве.
Ограничения объясняются несколькими причинами:
- разные GPU имеют различную ширину, длину, потребление и способ охлаждения;
- часть конфигураций рассчитана на четыре или восемь карт и оставляет больше места другим адаптерам;
- максимальные варианты требуют соответствующей силовой подсистемы и набора блоков питания;
- поддержка прямого жидкостного охлаждения не делает его обязательным для всех сборок;
- совместимость конкретной модели ускорителя нужно проверять в актуальной редакции QuickSpecs и матрице CTO.
Процессоры, память и накопители
Intel Xeon 6 увеличивает число доступных ядер и пропускную способность памяти, однако в GPU-сервере самый многоядерный CPU не всегда лучший. Для инференса часто важнее частота отдельных ядер, достаточный объём RAM и отсутствие узких мест при подготовке данных. Процессор следует выбирать после профилирования конвейера, а не по верхней строке спецификации.
Платформа имеет 32 слота DDR5 DIMM. Большой объём RAM нужен для кэширования наборов данных, предварительной обработки, виртуализации и моделей, которые частично выгружаются из памяти GPU. Однако системная память не заменяет GPU-память: обмен через PCIe заметно медленнее локальной памяти ускорителя.
Для локальных данных предусмотрены варианты до восьми SFF NVMe или до шестнадцати EDSFF. Ускоренные проекты часто используют эти диски как загрузочный и временный слой, а основные наборы данных хранят во внешней СХД или распределённом хранилище. Это упрощает масштабирование и снижает время копирования данных между узлами.
Что изменилось при переходе от Gen11 к Gen12
Больше ускорителей в одном узле
Gen11 ограничен четырьмя двухслотовыми GPU, тогда как Gen12 допускает значительно более плотные варианты. Это сокращает число серверов для одной задачи и может уменьшить объём сетевого обмена между узлами.
Вместе с тем сбой одного плотного узла затрагивает больше вычислительных ресурсов. Чем больше ускорителей объединено в одном сервере, тем важнее резервирование задач и возможность перенести нагрузку на другой узел.
Новая процессорная платформа
Xeon 6 расширяет выбор между процессорами с большим числом энергоэффективных ядер и моделями, ориентированными на производительность отдельных ядер. Для GPU-нагрузок это позволяет точнее подобрать CPU под подготовку данных, оркестрацию контейнеров, виртуальные рабочие места или параллельные сервисы инференса.
Питание разделено по ролям
В плотных конфигурациях Gen12 используются отдельные домены питания системы и ускорителей. Это помогает распределять нагрузку и резервирование, но увеличивает требования к PDU и электросети стойки.
Нельзя исходить только из паспортной мощности одного блока питания. Нужно считать фактическую нагрузку всех GPU, CPU, модулей памяти, накопителей и вентиляторов с запасом на кратковременные пики.
Охлаждение стало частью архитектуры
Для Gen12 доступны воздушные конфигурации и варианты с прямым жидкостным охлаждением. Воздух проще использовать в существующей серверной, однако при высокой мощности ускорителей потребуется большой расход воздуха.
Жидкостный контур снижает нагрузку на воздушную систему и позволяет обслуживать более горячие компоненты, но требует:
- коллекторов;
- блока распределения охлаждающей жидкости;
- контроля протечек;
- совместимых стоек и трубопроводов;
- подготовленного обслуживающего персонала.
Как выбирать ускорители
Название GPU само по себе не определяет пригодность сервера. Для больших языковых моделей критичны объём памяти ускорителя и скорость обмена между картами. Для компьютерного зрения важны пропускная способность видеодекодеров и число потоков. Для VDI — поддержка профилей виртуализации и лицензирование. Для рендеринга — совместимость с движком и драйвером.
При подборе GPU необходимо учитывать:
- Память GPU. Модель и рабочий пакет должны помещаться с запасом на служебные данные и контекст.
- Точность вычислений. Поддержка нужных форматов влияет на скорость и качество инференса или обучения.
- Межсоединение. Если задача делится между несколькими GPU, важны PCIe-топология и доступный вариант высокоскоростного обмена.
- Питание. Карта на 350 Вт и ускоритель на 600 Вт предъявляют разные требования к шасси и силовым кабелям.
- Охлаждение. Пассивные серверные карты зависят от воздушного потока корпуса. Неподходящий кожух или вентиляторы приводят к снижению частот.
- Программная среда. Нужно заранее сверить операционную систему, драйвер, библиотеки, платформу контейнеров и условия лицензирования.
Память, сеть и хранилище: где возникают скрытые ограничения
GPU простаивает, если данные поступают медленнее, чем он способен их обрабатывать. Поэтому экономия на сети и накопителях часто обходится дороже, чем установка ускорителя более низкого класса в сбалансированную систему.
При проектировании инфраструктуры важно учитывать следующее:
- локальные NVMe подходят для кэша, временных данных и активно используемой части набора;
- сеть 100GbE и даже меньше может быть достаточной для одного узла инференса, но кластеру с синхронным обменом и серьёзными нагрузками могут понадобиться 200/400GbE или InfiniBand;
- прямой доступ GPU к данным требует поддержки всей цепочкой: накопителем, адаптером, драйвером и программным стеком;
- объём RAM следует рассчитывать по размеру исходных данных, числу процессов и схеме загрузки модели, а не как фиксированное отношение к числу GPU;
- для нескольких узлов важны задержка сети, неблокирующая коммутация и достаточная пропускная способность между серверами и хранилищем.
Что предусмотреть в стойке и дата-центре
DL380a Gen12 может потребовать больше подготовки, чем установка обычного двухпроцессорного сервера. До заказа нужно знать доступную мощность на стойку, тип и количество розеток PDU, распределение по фазам, допустимую тепловую нагрузку зала, глубину стойки и массу полностью укомплектованной системы.
Следует учитывать, что:
- блоки питания высокой мощности могут использовать кабели C19/C20 вместо привычных C13/C14;
- резервирование сохраняется только при правильном распределении блоков питания между независимыми линиями;
- четыре юнита высоты не учитывают пространство для кабель-менеджмента и элементов жидкостного контура;
- горячий воздух нельзя возвращать на вход соседних серверов, иначе ускорители начнут снижать частоты;
- обслуживание тяжёлого 4U-узла безопаснее проводить силами минимум двух специалистов и с использованием подходящего подъёмника.
Какое поколение выбрать под конкретную задачу
| Сценарий | Ориентир | Решающий фактор |
|---|---|---|
| Инференс нескольких моделей | Gen11 при 1–4 мощных GPU; Gen12 при большей плотности | GPU-память, число одновременных запросов, задержка |
| Дообучение и генеративный ИИ | Чаще Gen12 | Объём памяти GPU, обмен между картами, сеть к хранилищу |
| VDI с графикой | Gen11 для умеренного пула; Gen12 для высокой консолидации | Поддержка vGPU, лицензии, отказоустойчивость |
| Рендеринг | Оба поколения | Поддержка движка, число независимых задач, энергопотребление |
| Видеоаналитика | Gen11 для одного контура; Gen12 для большого числа потоков | Декодирование, входящая сеть, NVMe-кэш |
| Научные и инженерные расчёты | По требованиям программного обеспечения; Gen12 при большом числе GPU | Точность вычислений, межсоединение, масштабирование |
Когда DL380a не нужен
Специализированная платформа не становится выгоднее только из-за нового поколения. Если проекту достаточно одной или двух карт, больше пользы может дать универсальный DL380 или другая модель с меньшим потреблением и более развитой дисковой подсистемой. Если требуется высокая плотность CPU без GPU, место и бюджет DL380a будут использованы неэффективно.
Для сравнения подходов полезен материал «HPE ProLiant для AI и GPU-нагрузок: DL380a Gen12, DL385 Gen11 и альтернативы». В нём DL380a сопоставлен с универсальными платформами Intel и AMD и специализированными решениями.
В зависимости от задачи альтернативой могут стать:
- Обычный DL380. Подходит для виртуализации, баз данных, корпоративных приложений и умеренного числа GPU.
- DL385 Gen11. Интересен сочетанием AMD EPYC, большого объёма памяти и нескольких ускорителей в 2U.
- DL340 или DL360. Полезны, если важнее компактность, а число GPU ограничено.
- DL384 и XD-системы. Предназначены для более специализированных архитектур и крупных задач, где важен быстрый обмен между ускорителями.
Доступные платформы можно сопоставить в разделах серверов для ИИ и серверов с GPU.
Управление, безопасность и обслуживание
DL380a Gen11 использует HPE iLO 6, а актуальные конфигурации Gen12 — iLO 7. Контроллер удалённого управления позволяет включать и перезагружать сервер, просматривать аппаратные события, устанавливать прошивки и работать с консолью без физического доступа к стойке.
Набор функций зависит от лицензии iLO, поэтому удалённую консоль, расширенную аналитику и интеграцию с корпоративными средствами управления нужно включать в проект заранее.
Аппаратное состояние сервера и телеметрия ускорителей контролируются разными слоями. iLO показывает питание, температуры, вентиляторы, память и системные ошибки, а загрузку GPU, объём занятой памяти, частоты и ошибки ускорителей собирают средствами производителя GPU и системой мониторинга.
Если отслеживать только загрузку процессоров, перегрев или нехватку памяти ускорителя можно не заметить до появления проблем с производительностью.
При эксплуатации DL380a важно обращать внимание на следующие best practice:
- прошивки BIOS, iLO, накопителей, сетевых адаптеров и GPU-драйверы обновляют согласованными версиями;
- для контейнерной среды фиксируют версии драйвера, среды выполнения GPU и библиотек, чтобы обновление одного узла не меняло поведение модели;
- события коррекции памяти, ошибки PCIe и снижение частот GPU передают в централизованный мониторинг;
- доступ к iLO выносят в отдельную управляющую сеть, защищают многофакторной аутентификацией и ограничивают по ролям;
- перед заменой ускорителя сохраняют конфигурацию, серийные номера и привязку слотов, поскольку топология влияет на производительность приложения.
В GPU-сервере плановое обслуживание особенно важно. Загрязнённые воздушные каналы и устаревшая прошивка могут не остановить систему полностью, но вызвать снижение частот и непредсказуемые задержки. После изменения состава ускорителей или памяти полезно повторять нагрузочное испытание, а не ограничиваться успешной загрузкой операционной системы.
Стоимость владения: считать нужно не только сервер
Цена базового шасси составляет лишь часть бюджета. В полной смете учитываются:
- ускорители;
- лицензии;
- высокоскоростные сетевые адаптеры и коммутаторы;
- NVMe и внешнее хранилище;
- электроэнергия;
- охлаждение;
- стойко-места;
- гарантийное обслуживание;
- время специалистов.
У плотного Gen12 стоимость инфраструктуры может быть выше, но один 4U-узел способен заменить несколько менее насыщенных серверов и сократить объём межсерверного трафика.
На стоимость владения влияют следующие факторы:
- Коэффициент использования. Дорогие GPU должны получать задачи регулярно. Простой из-за медленного хранилища увеличивает фактическую стоимость вычисления.
- Энергия и охлаждение. Сравнивать нужно потребление при рабочей нагрузке, а не только сумму максимальных TDP компонентов.
- Лицензирование. VDI, виртуальные GPU, средства оркестрации и коммерческие библиотеки могут тарифицироваться по GPU, пользователю или узлу.
- Отказоустойчивость. Консолидация десяти ускорителей в одном корпусе повышает последствия остановки узла. Иногда два меньших сервера позволяют построить более устойчивую схему.
- Масштабирование. Если проект вырастет до кластера, заранее заложенные сеть и хранилище снизят стоимость следующего этапа.
Gen11 часто выигрывает по цене входа и совместимости с существующей воздушной инфраструктурой. Gen12 выгоднее, когда проект действительно использует высокую плотность GPU и способен загрузить её работой. Покупка максимальной конфигурации «на будущее» без подтверждённого плана задач приводит к расходам на питание и лицензии задолго до появления полезной нагрузки.
Новое или восстановленное оборудование
DL380a Gen11 постепенно становится доступнее на вторичном рынке и может снизить капитальные затраты для инференса, VDI или рендеринга. Экономия оправдана, если поставщик проверяет сервер под нагрузкой, подтверждает комплектность GPU-райзеров, силовых кабелей и вентиляторов и предоставляет гарантию.
Отдельно оценивают происхождение и состояние ускорителей: стоимость GPU нередко выше стоимости базового сервера.
DL380a Gen12 чаще приобретают новым и конфигурируют под конкретный проект. Это предпочтительнее, когда нужны актуальные ускорители, точный тепловой пакет, жидкостное охлаждение или определённое распределение PCIe.
Замена одного элемента после поставки может потребовать другого райзера, блока питания или набора кабелей, поэтому конфигурацию согласовывают целиком.
Итог
HPE ProLiant DL380a Gen11 и Gen12 решают одну задачу — дают корпоративную платформу для GPU, — но делают это в разном масштабе. Gen11 размещает до четырёх двухслотовых ускорителей в 2U и подходит для проектов, которым важна компактность. Gen12 переходит к 4U, Intel Xeon 6 и вариантам до десяти двухслотовых GPU, поэтому лучше соответствует плотному инференсу, генеративному ИИ и росту вычислительного пула.
Выбор следует начинать с модели и объёма памяти GPU, характера обмена между ускорителями, скорости подачи данных, мощности стойки и способа охлаждения. Номер поколения становится решающим только после этих расчётов: новый сервер не устранит узкое место в сети, хранилище или программном стеке.