Сервер для ClickHouse выбирают по объёму данных после сжатия, сложности запросов, числу одновременно выполняемых запросов и скорости поступления новых данных. Для активной аналитики разумно начинать подбор с серверных SSD, процессоров с высокой производительностью и достаточной пропускной способности памяти. Ёмкость дисков рассчитывают с запасом для роста и фоновых операций, а необходимость репликации определяют по требованиям к доступности. Окончательную конфигурацию подтверждают испытаниями на характерных для проекта данных и запросах.
Одинаковый размер базы не означает одинаковую нагрузку. Сервер, который быстро строит ежедневные отчёты, может оказаться недостаточным для годовой аналитики, сложных соединений таблиц или десятков одновременно обновляющихся панелей. Поэтому подбор оборудования начинается с того, как данные будут использоваться.
Почему размер базы не определяет требования к серверу
ClickHouse, в отличие от классических реляционных СУБД, хранит данные по столбцам. Если запросу нужны дата, категория события и сумма, ему не обязательно читать остальные поля таблицы. Это сокращает объем обработки, но не отменяет затрат на чтение, распаковку, фильтрацию и вычисления.
Особенно важен ключ сортировки, задаваемый через ORDER BY. Подходящее расположение данных позволяет пропускать ненужные участки. Если условия запроса плохо соответствуют структуре таблицы, серверу приходится обрабатывать значительно больше информации.
Нагрузка различается даже внутри одной базы:
- Отчёт за последние сутки может читать ограниченный диапазон и несколько столбцов.
- Группировка за год обрабатывает большой объем и создает множество промежуточных результатов.
- Соединение таблиц требует ресурсов на сопоставление строк; потребление памяти зависит от выбранного алгоритма.
- Поиск по строковым полям может оказаться вычислительно дорогим, особенно при широком просмотре.
- Сортировка большого результата нагружает память, а при использовании временных файлов — накопители.
Предположим, две системы хранят по 2 ТБ сжатых данных. Первая обслуживает отчёты по последним семи дням, вторая регулярно анализирует всю историю по уникальным пользователям. Для первой может быть достаточно умеренной конфигурации, тогда как второй понадобятся более мощные процессоры, дополнительная память или распределение данных между узлами.
Количество строк тоже нельзя оценивать отдельно от их состава. Миллиард коротких записей с числами и датами отличается от миллиарда событий с длинными строками и вложенными структурами.
Какие параметры нагрузки нужны для расчёта
Объём, рост и срок хранения
Для планирования следует различать несколько величин:
- Объем входящих данных — сколько информации поступает из приложений, журналов или других источников.
- Размер столбцов без сжатия — внутреннее представление данных в ClickHouse до применения сжатия.
- Сжатый объём — сколько занимают хранимые столбцы после сжатия.
- Фактическое место на дисках — данные вместе с дополнительными структурами, метаданными и другими файлами.
- Активный объём — информация, к которой регулярно обращаются запросы.
Сжатие зависит от типов столбцов, повторяемости значений, сортировки и кодеков — алгоритмов сжатия. Универсального коэффициента для любой базы нет. Для расчёта лучше загрузить представительную выборку: разные периоды, категории событий и типы записей.
Срок хранения влияет на архитектуру не меньше скорости роста. Если ежедневно добавляется 20 ГБ сжатых данных и ничего не удаляется, за год накопится около 7,3 ТБ основных данных. Если хранится только последний месяц, объём может стабилизироваться, но система всё равно должна успевать загружать, объединять и удалять данные.
Запросы и загрузка
Помимо ёмкости нужны сведения о работе системы:
- Сколько запросов выполняется одновременно в обычное время и в пике.
- Какое время ответа допустимо для панели аналитики и для тяжёлого отчёта.
- Сколько строк и байтов поступает в секунду.
- Какими пакетами загружаются данные.
- Бывают ли массовые загрузки, перерасчёты и исправления истории.
- Какой простой допустим и сколько времени отводится на восстановление.
Число пользователей не равно числу запросов. Одна панель может запускать восемь обращений к базе, а синхронное обновление нескольких панелей создаёт кратковременный всплеск.
Важно различать частоту поступления запросов и их одновременное выполнение. При устойчивом потоке десять запросов в секунду со средним временем ответа две секунды означают примерно двадцать запросов в работе. Когда ответы замедляются, одновременная нагрузка растёт даже без увеличения посещаемости.
Как выбрать процессоры для ClickHouse
Ядра, частота и поколение
ClickHouse расходует процессорные ресурсы на распаковку, фильтрацию, вычисления, группировки и фоновые операции. Дополнительные ядра полезны при параллельной обработке больших объёмов и обслуживании нескольких запросов.
Однако сравнение только по числу ядер малоинформативно. Значение имеют:
- производительность одного ядра;
- архитектура и поддерживаемые инструкции;
- пропускная способность памяти;
- частота под продолжительной нагрузкой;
- ограничения питания и охлаждения.
Старый процессор с большим числом ядер может проиграть более новой модели с меньшим числом ядер. Логические потоки также нельзя считать полноценной заменой физическим ядрам: они совместно используют часть ресурсов процессора.
В официальных рекомендациях ClickHouse по подбору оборудования конфигурация связывается с характером нагрузки, объёмом обработки и требованиями к запросам. Приведённые там облачные классы оборудования и соотношения памяти к вычислительным ресурсам полезны как ориентиры, но не заменяют измерения на физическом сервере.
Один или два процессора
Двухпроцессорная платформа может дать больше ядер, каналов памяти и возможностей подключения устройств. Но доступ к памяти другого процессора, за счёт NUMA-архитектуры, имеет свои особенности: результат зависит от размещения данных и распределения работы.
Для сравнения однопроцессорного и двухпроцессорного сервера нужно учитывать всю конфигурацию. Быстрый процессор с равномерно заполненными каналами памяти и правильно подключёнными NVMe может оказаться выгоднее системы с двумя процессорами, но недостаточной пропускной способностью памяти.
Два процессора не гарантируют двукратного ускорения. Если ограничение находится в дисках, сети или последовательной части запроса, дополнительные ядра дадут небольшой эффект.
Параметр max_threads ограничивает число потоков выполнения запроса для поддерживающих его операций. Выделять каждому запросу максимум доступных ресурсов не всегда полезно: несколько тяжёлых обращений начинают конкурировать. Для многопользовательской аналитики оценивают и время отдельного запроса, и количество запросов, которое система успевает обслужить.

Сколько оперативной памяти нужно ClickHouse
База не обязана помещаться в память целиком
ClickHouse способен работать с базами, значительно превышающими объём оперативной памяти. Память нужна для обработки данных и промежуточных результатов, а файловый кэш операционной системы помогает повторным чтениям.
Потребление складывается из нескольких составляющих:
- работа операционной системы и самого сервера базы данных;
- выполнение запросов;
- группировки, сортировки и соединения;
- фоновые операции;
- словари и другие постоянно используемые структуры;
- кэши и эксплуатационный запас.
Особенно важна кардинальность — количество уникальных значений. Группировка по десяти категориям и группировка по миллионам пользователей создают разные объёмы промежуточных структур, даже если читают одинаковое число строк.
Как учитывать одновременные запросы
Для предварительной оценки можно использовать модель:
Память ≈ базовое потребление + память одновременно выполняемых запросов + фоновые операции + запас.
Например, если четыре характерных тяжёлых запроса одновременно потребляют примерно по 12 ГБ, для их выполнения требуется около 48 ГБ. К этому добавляются остальные компоненты. Сервер с 64 ГБ уже может оказаться слишком тесным, хотя каждый запрос по отдельности выполняется успешно.
Это расчетный пример, а не норматив. Пиковое потребление необходимо измерять на реальном сочетании запросов. Нельзя брать самый лёгкий отчёт и умножать его расход памяти на число пользователей.
Для серверной платформы предпочтительна память с коррекцией ошибок. Не менее важно заполнение каналов: одинаковые 256 ГБ, установленные разным количеством модулей, могут обеспечить разную пропускную способность. Схему размещения выбирают по документации конкретного сервера.
Когда часть обработки переносится на диски
Некоторые группировки и сортировки можно выполнять с использованием временных файлов. Это позволяет обработать данные, для которых недостаточно памяти, но увеличивает дисковую нагрузку и обычно ухудшает время ответа.
Такой режим полезен для редких тяжёлых отчётов. Если он постоянно используется обычными панелями аналитики, стоит пересмотреть запросы, структуру таблиц или объём памяти.
Ограничения памяти защищают сервер от отдельных чрезмерно тяжёлых запросов. Однако они не создают дополнительные ресурсы: слишком жёсткие значения могут приводить к ошибкам, а слишком свободные — к конкуренции запросов и нехватке памяти.
Какие накопители нужны и как рассчитать ёмкость
NVMe, SATA SSD и HDD
Для активной аналитики NVMe — подходящий кандидат благодаря возможностям параллельного доступа и высокой пропускной способности. Но реальная польза зависит от того, ограничена ли нагрузка накопителями.
SATA SSD могут быть достаточны для небольших баз, умеренной загрузки и запросов с невысокими требованиями к задержкам. Это нужно подтверждать испытаниями, особенно при одновременном чтении и записи.
HDD можно рассматривать для редко используемой истории, если допустимо более длительное выполнение запросов. Размещение всей активной базы на HDD ради низкой стоимости терабайта способно сделать интерактивную аналитику неприемлемо медленной.
При сравнении накопителей важны:
- устойчивая скорость чтения и записи;
- задержки под смешанной нагрузкой;
- поведение при заполнении;
- ресурс записи;
- защита от потери питания;
- возможности подключения нескольких устройств.
Паспортная скорость одного SSD не равна скорости массива в сервере. Ограничением могут стать контроллер, линии PCIe или схема подключения дисковой корзины.
Почему фоновые слияния увеличивают запись
В таблицах семейства MergeTree данные записываются отдельными частями, которые затем объединяются в фоне. Слияния читают существующие данные и записывают новые файлы.
Поэтому 100 ГБ поступивших данных не означают ровно 100 ГБ записи на SSD. Дополнительную нагрузку создают слияния, изменения данных, перенос между уровнями хранения и временные файлы.
Особенно нежелателен постоянный поток очень маленьких вставок. Он создаёт множество частей и увеличивает накладные расходы. Подходящий размер пакетов или настроенная асинхронная загрузка помогают уменьшить проблему, но должны соответствовать требованиям к появлению новых данных в запросах.
Ресурс SSD оценивают по фактической записи за сутки. Для восстановленных накопителей дополнительно важны оставшийся ресурс, ошибки и история эксплуатации.
Формула расчёта дискового пространства
Для узла с локальным хранением:
Полезная ёмкость ≥
(сжатые данные на узле + дополнительные структуры + временное место) / целевая доля заполнения.
В расчёт входят прогнозируемый объём на выбранном горизонте, неравномерность распределения и особенности таблиц. Свободное место нужно для работы системы, а не только для будущего роста.
Предположим, планируется хранить 6 ТБ сжатых основных данных. Они распределяются между двумя шардами, каждый из которых имеет две реплики. Шард — часть общего набора данных; реплика — копия данных своего шарда.
При равномерном распределении каждый из четырёх узлов хранит по 3 ТБ основных данных. Если в этом примере добавить 1 ТБ на дополнительные структуры и временную работу, а целевое заполнение принять 70%, получится:
(3 + 1) / 0,7 ≈ 5,7 ТБ полезной ёмкости на узел.
Здесь 1 ТБ и 70% — условия примера. Требуемый запас зависит от размеров частей, фоновых операций, дополнительных структур и роста данных.
Полезную ёмкость считают после учёта RAID. Например, зеркало из двух накопителей не даёт сумму их ёмкостей. Также необходимо различать ТБ и ТиБ: 1 ТБ содержит 10¹² байт, а 1 ТиБ — 2⁴⁰ байт.
Резервные копии рассчитываются отдельно. RAID помогает пережить определённые отказы дисков, репликация — сохранить доступность копии базы, резервное копирование — восстановить данные за нужный момент. Ошибочное удаление может распространиться на реплики.
Когда нужен кластер и сколько узлов закладывать
Разделение данных и создание копий
Увеличение числа шардов распределяет данные и часть обработки между серверами. Дополнительные реплики хранят копии данных и могут использоваться для обслуживания чтения при соответствующей маршрутизации.
Схемы различаются по назначению:
- Один узел — простая архитектура без дополнительной копии для доступности.
- Один шард и две реплики — два узла с одинаковыми данными.
- Два шарда и две реплики на каждый — четыре узла, по две копии каждой половины базы.
- Четыре шарда и две реплики на каждый — восемь узлов данных.
Две реплики не означают автоматического ускорения одного запроса вдвое. Эффект зависит от распределения запросов и использования возможностей параллельного чтения.
Две копии также не являются универсально достаточной схемой для любой системы. Число реплик выбирают с учётом отказов, обслуживания, требований к записи и возможностей хранения.
Как понять, что пора добавлять шарды
Основания для распределения данных:
- нужная ёмкость становится неудобной для одного сервера;
- вычислительных ресурсов недостаточно после разумного расширения;
- время ответа под одновременной нагрузкой превышает допустимое;
- загрузка и фоновые операции мешают аналитике;
- дальнейшее увеличение одного узла становится экономически невыгодным.
Однако шардирование добавляет обмен по сети и объединение результатов. В запросах с большими промежуточными результатами узел, собирающий ответ, может стать ограничением.
Важен ключ распределения данных. Если один шард получает непропорционально много записей или запросов, остальные серверы не компенсируют его перегрузку. Добавление нового узла само по себе не перераспределяет уже накопленную историю.
Отказы и восстановление
Кластер оценивают в двух состояниях: при работе всех узлов и при недоступности одной реплики. Если две реплики обычно делят чтение, после отказа оставшаяся должна выдержать большую нагрузку.
Восстановление копии тоже занимает ресурсы. Данные нужно прочитать, передать и записать; в это время система продолжает обслуживать запросы.
Для координации репликации используется ClickHouse Keeper. Отказоустойчивая схема обычно предусматривает как минимум три участника, размещённых с учётом независимых отказов по избежание ситуации Split-Brain. Keeper не хранит ещё одну полную копию аналитической базы, а его ресурсы учитываются отдельно от узлов данных.
Сеть и серверная платформа
Какую сеть закладывать
Сеть обслуживает загрузку, репликацию, распределённые запросы, резервное копирование и восстановление. Эти операции могут совпадать по времени.
Для кластера можно сравнивать варианты с 10 и 25 Гбит/с, но универсального обязательного минимума нет. Нужно оценивать объём передачи и допустимую длительность операций.
Например, передача 3 ТБ по каналу 10 Гбит/с даже при использовании всей номинальной пропускной способности занимает около 40 минут. На практике добавляются накладные расходы и ограничения накопителей, а часть канала может быть занята текущей работой. Поэтому обещать восстановление за это время нельзя.
Что ограничивает возможности шасси
Число отсеков не определяет возможности хранения. Для NVMe важны совместимость корзины, объединительная плата, кабели, линии PCIe и доступные варианты установки.
При подборе платформы учитывают:
- доступные каналы памяти и схему установки модулей;
- подключение накопителей и сетевых адаптеров;
- возможность расширения без замены основной конфигурации;
- питание и охлаждение под длительной нагрузкой;
- доступность запасных частей и обновлений.
У восстановленного сервера более низкая цена покупки может сопровождаться ограничениями по расширению и большей стоимостью эксплуатации. Сравнивать следует весь комплект: процессоры, память, диски, сетевые карты и необходимые компоненты подключения.
Конфигурации под разные объёмы и параллельность
В таблице приведены стартовые варианты для планирования испытаний. Это авторские проектные ориентиры, а не официальные нормативы или измеренная производительность. Объём относится ко всей базе без дополнительных копий, ресурсы — к одному узлу данных.
|
Сценарий |
Сжатые основные данные |
Одновременные запросы для испытаний |
Ресурсы одного узла |
Начальный вариант архитектуры |
|---|---|---|---|---|
|
Небольшая внутренняя аналитика |
До 0,5 ТБ |
1–5 |
8–16 физических ядер, 64–128 ГБ памяти, серверные SSD |
Один узел; копии — по требованиям доступности |
|
Регулярные отчёты и панели |
0,5–3 ТБ |
5–15 |
16–32 ядра, 128–256 ГБ, NVMe |
Один шард с необходимым числом реплик |
|
Аналитика нескольких подразделений |
3–10 ТБ |
10–30 |
32–48 ядер, 256–512 ГБ, несколько NVMe |
Сравнить мощный узел и два шарда |
|
Поток событий и активная аналитика |
10–30 ТБ |
20–60 |
32–64 ядра, 256–512 ГБ, NVMe |
Испытать 2–4 шарда; реплики выбрать отдельно |
|
Длительная история и редкие отчёты |
Десятки ТБ |
1–10 |
16–32 ядра, 128–256 ГБ, быстрое хранение активных данных |
Число шардов определить по ёмкости и времени чтения |
Скорость поступления данных для каждого варианта задают отдельно. Поток загрузки может сделать конфигурацию недостаточной даже при небольшом числе запросов.
Дисковую ёмкость рассчитывают по прогнозу хранения, а не по одной строке таблицы. Указанная параллельность обозначает режим испытаний и не гарантирует определённого времени ответа.
Небольшая база и тяжёлые группировки
Если основная работа — анализ уникальных пользователей, соединения таблиц и сложные сортировки, приоритетом может стать память. Увеличивать количество SSD без оценки промежуточных результатов бесполезно, когда запрос завершается из-за нехватки памяти.
Для таких задач полезны представительные данные с реальным распределением значений. Упрощённая выборка может содержать намного меньше уникальных пользователей и скрыть проблему.
Большая история и редкие отчёты
Если пользователи работают преимущественно с последним месяцем, необязательно размещать всю многолетнюю историю на самом дорогом уровне хранения. Возможна архитектура с быстрыми активными данными и более экономичным хранением старых периодов.
Но отчёт по всей истории затронет медленный уровень. Его допустимое время выполнения должно быть согласовано заранее.
Умеренная база и множество панелей
В этом сценарии важны устойчивость к пикам и совокупная пропускная способность. Даже быстрые запросы создают серьёзную нагрузку, если запускаются одновременно.
Помочь могут разнесение обновлений по времени, сокращение повторных вычислений и ограничение ресурсов тяжёлых отчётов. Покупка дополнительных ядер должна сопровождаться оценкой того, как ими распоряжаются запросы.
Какие серверные модели можно рассматривать
Источник изображения: Сервер Молл
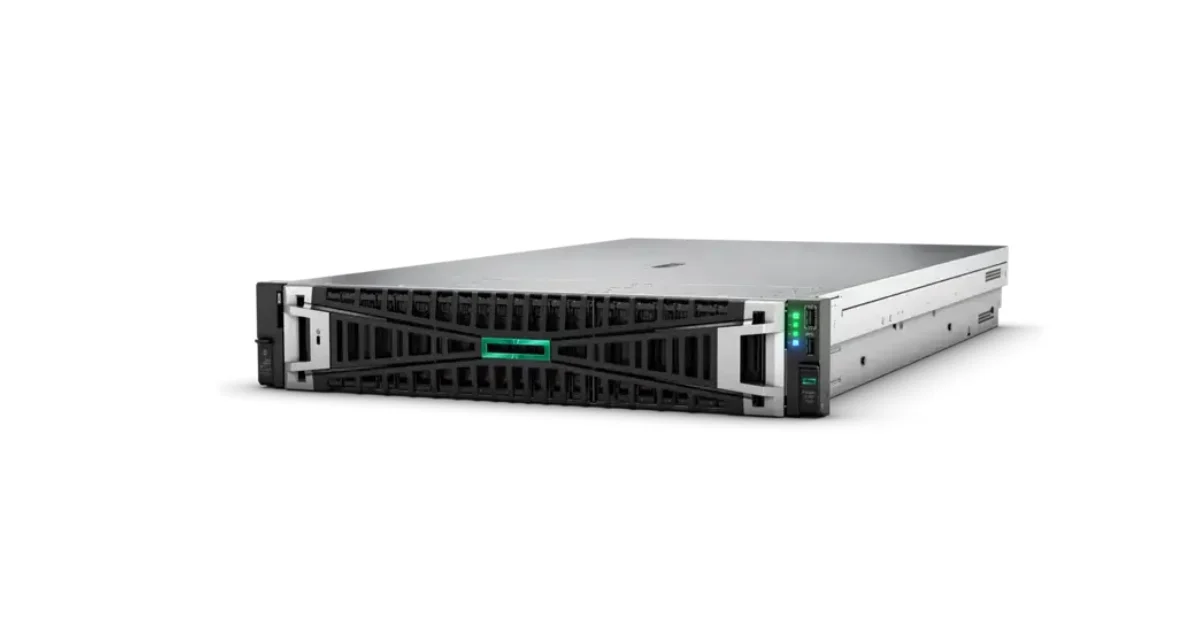
HPE ProLiant DL380 Gen11
Конфигурации HPE ProLiant DL380 Gen11 в каталоге Сервер Молл.
DL380 Gen11 — стоечная универсальная двухпроцессорная платформа 2U на Intel Xeon Scalable с памятью DDR5. Её можно рассматривать для аналитического узла, которому нужны возможности расширения памяти, накопителей и сетевых подключений. Конкретная комплектация зависит от исполнения шасси.
Для ClickHouse особенно важен вариант хранения. Сервер с подходящими процессорами, но ограниченным подключением SSD может проиграть более сбалансированной конфигурации.
При ограниченном бюджете стоит сравнить и предыдущие поколения. Различия платформ, памяти и интерфейсов разобраны в статье «HPE ProLiant DL380: сравнение поколений Gen9–Gen12». Она помогает оценить, какие возможности нового поколения действительно нужны выбранной нагрузке.
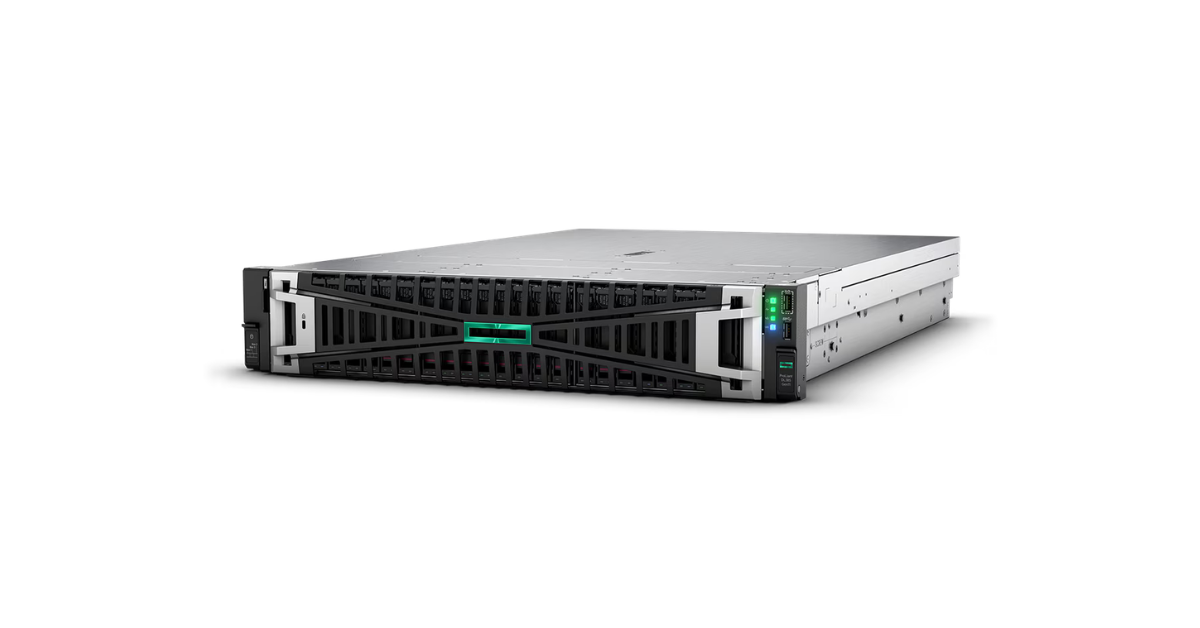
HPE ProLiant DL385 Gen11
Источник изображения: Сервер Молл
Конфигурации HPE ProLiant DL385 Gen11 в каталоге Сервер Молл.
DL385 Gen11 можно включить в сравнение как платформу на AMD EPYC. Для проекта важно сопоставить конкретные процессоры, заполнение памяти, накопители и стоимость всего узла, а не только название семейства.
Сравнение DL380 и DL385 имеет смысл при одинаковой прикладной нагрузке. Если у одного сервера больше памяти или другая схема хранения, результаты отражают различие конфигураций в целом. Приписывать разницу исключительно процессору некорректно.
Ни одна модель не становится сервером для ClickHouse только благодаря названию. Рабочая конфигурация определяется совместно вычислениями, памятью, хранением и архитектурой базы.
Как испытать конфигурацию до покупки
Данные и сжатие
Для воспроизводимого сравнения подходит официальный набор ClickBench. Он содержит около 100 млн строк и 43 стандартных запроса, позволяющих исследовать разные стороны аналитической обработки. Однако одна плоская таблица не воспроизводит все особенности проекта, особенно соединения и многотерабайтное хранение.
Открытый набор полезно дополнить обезличенной рабочей выборкой. В ней должны сохраняться распределение значений, длина строк, доля пустых полей и число уникальных идентификаторов.
Для сравнения фиксируют:
- версию ClickHouse и операционной системы;
- процессоры, память, накопители и число узлов;
- число строк и состав столбцов;
- ключ сортировки и разбиение на разделы;
- кодеки и дополнительные структуры ускорения;
- размер после загрузки и состояние фоновых операций.
Коэффициент сжатия вычисляют из сопоставимых величин. Например, 120 ГБ несжатых столбцов и 30 ГБ сжатых дают коэффициент 4. Это арифметический пример: размер исходного JSON-файла может быть другим из-за текстового представления и служебных символов.
Запросы и режимы работы
Нужны запросы, соответствующие реальному использованию системы. Для таблицы событий это могут быть сумма показателей за сутки, группировка по пользователям за месяц и сортировка категорий по числу событий. При наличии справочников добавляют характерное соединение.
Каждый сценарий выполняют последовательно:
- Один запрос без фоновой загрузки.
- Несколько уровней одновременного выполнения.
- Те же запросы при поступлении новых данных.
- Для кластера — работу при недоступности одной реплики.
Во всех сравнениях сохраняют одинаковые SQL, периоды выборки и настройки. Если изменяется ключ сортировки или добавляется предварительно вычисленная структура, это отдельный эксперимент по оптимизации.
Холодный и прогретый кэш измеряют отдельно. Первый запуск нельзя автоматически считать полностью холодным: данные могут оставаться в файловом кэше после загрузки. В описании указывают, какие кэши сбрасывались и включён ли кэш результатов запросов.
Время выполнения и устойчивость
|
Сценарий |
Что измерять |
Как интерпретировать |
|---|---|---|
|
Один аналитический запрос |
Время, прочитанные строки и байты, пиковую память |
Показывает поведение конкретного запроса |
|
Несколько одновременных запросов |
Медиану, 95-й процентиль, завершённые запросы в секунду |
Показывает скорость обслуживания потока |
|
Запросы вместе с загрузкой |
Время ответа, скорость вставки, накопление фоновых задач |
Показывает устойчивость смешанной нагрузки |
|
Работа без одной реплики |
Время ответа, ошибки, нагрузку оставшихся узлов |
Показывает возможности при отказе |
|
Восстановление реплики |
Продолжительность, передачу данных, влияние на запросы |
Показывает эксплуатационную стоимость восстановления |
Медиана характеризует середину распределения времени ответа. 95-й процентиль — время, в которое укладываются 95% измеренных запросов. Он помогает увидеть замедления, скрытые средним значением.
Для устойчивой оценки нужны продолжительный запуск и достаточное число измерений. Три повторения подходят для предварительного знакомства, но не дают убедительной картины редких задержек.
Время важно разделять на выполнение внутри ClickHouse и ответ, наблюдаемый приложением. Сеть, очереди, передача результата и работа клиента тоже могут влиять на пользователя.
Публикуемый результат должен выглядеть как описание измеренного опыта: точный запрос, набор данных, сжатый объём, конфигурация, режим кэша, число повторов и время в секундах. Без этих условий фраза «запрос выполняется за 0,5 секунды» не помогает подобрать оборудование.
Приведённые выше конфигурации не сопровождались собственными замерами, поэтому им нельзя назначить достоверное время выполнения. Результат на 100 млн строк также нельзя линейно переносить на базу в десятки терабайт: меняются доля данных в кэше, дисковая нагрузка и поведение фоновых операций.
Как выбрать конфигурацию без лишних затрат
Для небольшой аналитической системы разумно сравнить несколько вариантов одного узла, определить ограничение и расширять именно нужный ресурс. Реплики добавляют по требованиям к доступности, независимо от того, насколько мала база.
Шардирование оправдано, когда ёмкость или производительность одного сервера становятся недостаточными, а испытания подтверждают пользу распределения. Слишком ранний переход к большому кластеру увеличивает расходы на сеть, копии данных и сопровождение.
Перед покупкой более мощного оборудования стоит оценить структуру таблиц:
- соответствует ли ключ сортировки основным запросам;
- используются ли подходящие типы столбцов;
- читаются ли только необходимые данные;
- можно ли предварительно вычислять повторяющиеся отчёты;
- не создаёт ли загрузка чрезмерное количество мелких частей.
Стоимость сравнивают в разрезе эксплуатации в течение нескольких лет. В неё входят серверы, SSD и их замена, сетевое оборудование, резервное хранение, электричество, блочный ремонт и сопровождение. В идеальном случае оценивается вероятность отказа и стоимость простоя. Выгодная конфигурация выдерживает обычную нагрузку, пики и предусмотренные отказы с приемлемым временем ответа — без оплаты ресурсов, которые проект не использует.