ZFS — файловая система и менеджер хранения, который объединяет диски в пул, проверяет целостность данных и поддерживает снимки состояния. Она подходит для файловых серверов, хранилищ резервных копий и виртуализации, где важны обнаружение повреждений и удобное восстановление. Для небольшого сервера можно начать с зеркала, а для ёмкого хранилища на нескольких больших HDD — рассмотреть RAID-Z2. При этом ни избыточность, ни снимки ZFS не заменяют отдельную резервную копию.
Что такое ZFS
ZFS управляет дисками и файлами совместно: знает расположение блоков, проверяет их содержимое и при наличии исправной копии устраняет повреждение.
OpenZFS, TrueNAS и поддержка в Linux
Исторически ZFS возникла при поддержке компании Sun, использовалась в Solaris. Затем была портирована под FreeBSD, а затем уже и в Linux. Сейчас, после покупки Sun компанией Oracle, развивается как проприетарный механизм. Поэтому в Linux и FreeBSD используют OpenZFS — открытую реализацию ZFS. Она доступна в таких решениях, как Proxmox VE и служит основой хранения TrueNAS. Эти продукты добавляют собственные интерфейсы управления.
На 13 октября 2026 года последняя стабильная версия в списке релизов OpenZFS — 2.4.4. Дистрибутив может поставлять другую поддерживаемую версию.
В основное дерево ядра Linux ZFS не входит из-за несовместимости лицензий CDDL и GPLv2. Её подключают отдельным модулем.
Как устроена ZFS
Пул, vdev, датасеты и zvol
- Диски — физические HDD, SSD или выделенные разделы.
- vdev — отдельный диск либо группа дисков: зеркало, RAID-Z или dRAID. Здесь задаётся избыточность.
- Пул — общее хранилище из одного или нескольких vdev. Управление — через zpool.
- Датасеты — файловые системы внутри пула. Имеют собственные квоты, сжатие и снимки.
- zvol — блочный том внутри пула, например виртуальный диск для ВМ. Это альтернатива файловому датасету.
Датасеты делят свободное место пула без фиксированной нарезки на разделы. Например, для документов и резервных копий можно задать разные квоты. Физические разделы на дисках при этом допустимы.
Избыточность действует внутри vdev. Пул из двух зеркал переживёт отказ одного диска в каждом, но потеря целого зеркала означает потерю пула. Добавленный одиночный диск также становится точкой отказа.
Запись с копированием, контрольные суммы и scrub
Запись с копированием, Copy-on-Write, сохраняет изменённый блок в новом месте и затем обновляет ссылки. Структура остаётся согласованной, но последние асинхронные записи при сбое питания могут потеряться.
Контрольные суммы данных и метаданных позволяют обнаружить повреждение при чтении. ZFS восстанавливает блок из исправной копии зеркала или по чётности RAID-Z, если избыточности достаточно. На одиночном диске ошибку можно обнаружить, но исправить её часто неоткуда.
Scrub проверяет занятые блоки, включая давно не читавшиеся данные. Устройство пулов и механизм защиты описаны в документации OpenZFS.
RAID в ZFS: mirror, RAID-Z и dRAID
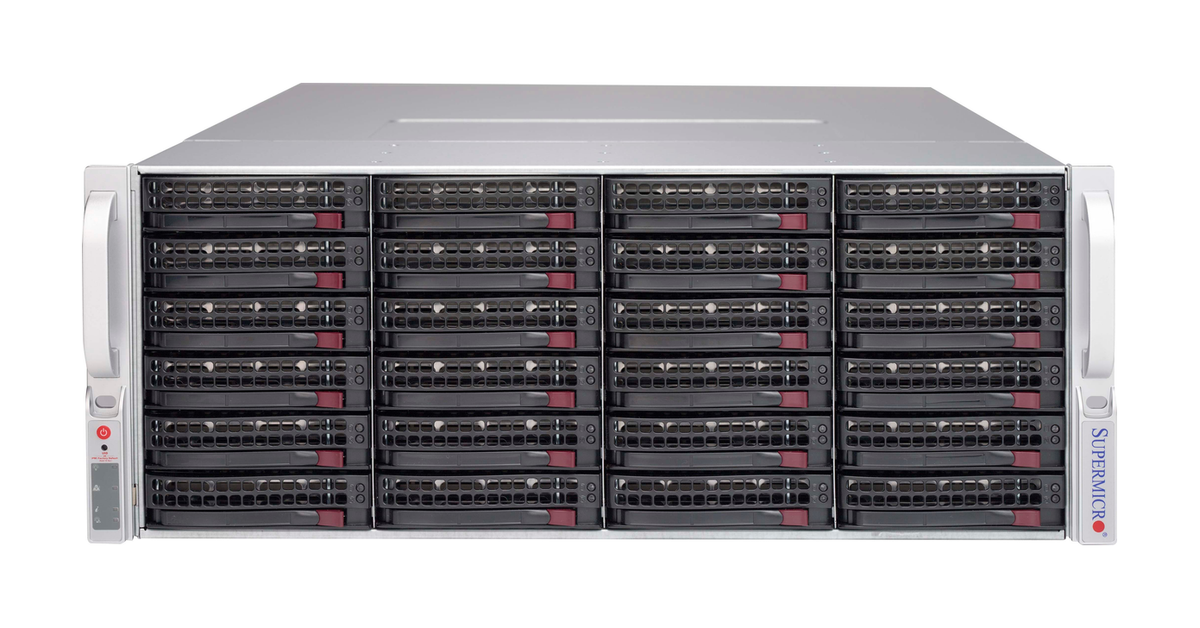
Дисковая полка Supermicro SC847E1C-R1K23JBOD, вид спереди. Источник: Supermicro.
Для SAS/SATA нужен прямой доступ через HBA — адаптер подключения дисков, обычно в режиме IT. Подходит и контроллер в полноценном режиме HBA. NVMe часто подключают напрямую к PCIe.
Аппаратный RAID под ZFS не создают: он скрывает диски и добавляет другой механизм восстановления. Для расширения используют дисковые полки JBOD с совместимым HBA. Пример полки — Dell PowerVault MD1400; совместимость с HBA и кабелями согласуют для конкретной комплектации. Выбор оборудования разобран в статье Сервер Молл «HBA или RAID-контроллер».
| Схема | Защита внутри одного vdev | Где уместна |
|---|---|---|
| mirror | Зеркало из N дисков выдерживает отказ N−1, пока остаётся исправная копия | Виртуальные машины, базы данных, небольшие хранилища |
| RAID-Z1 | Отказ одного диска | Некритичные данные с отдельной копией и допустимым простоем |
| RAID-Z2 | Отказ двух дисков | Ёмкие файловые хранилища на HDD |
| RAID-Z3 | Отказ трёх дисков | Хранилища с повышенными требованиями к избыточности |
| dRAID | Один, два или три отказа в зависимости от уровня чётности | Большие массивы, где важна скорость восстановления на распределённый резерв |

В dRAID резервное пространство распределено по накопителям: после отказа восстановление использует их совместно, а не упирается в запись на один запасной диск.
В RAID-Z чётность распределена по всем дискам. Постоянного «диска чётности» или «диска под контрольные суммы» нет: чётность восстанавливает данные, контрольные суммы проверяют целостность.
На одинаковых дисках ёмкость RAID-Z приблизительно равна (N − P) × объём диска, где P — уровень чётности. Служебные расходы и резерв свободного места дополнительно уменьшают доступный объём.
Зеркала обычно удобнее для мелких случайных обращений, RAID-Z — для экономии ёмкости. Чтение зеркала может использовать несколько дисков; формулы скорости классического RAID 5 нельзя переносить на RAID-Z.
RAID-Z1 или RAID-Z2: что выбрать
После отказа диска RAID-Z1 лишается запаса избыточности. Второй отказ в том же vdev во время восстановления делает данные недоступными; нечитаемый блок на оставшемся диске может привести к потере соответствующих данных.
Большие HDD при высокой нагрузке восстанавливаются долго. RAID-Z2 сохраняет защиту от ещё одного отказа, поэтому для рабочего файлового хранилища обычно предпочтительнее. RAID-Z1 выбирают с пониманием допустимого простоя и порядка восстановления из резервной копии.
С OpenZFS 2.3 RAID-Z можно расширить добавлением диска при поддержке функции пулом. RAID-Z1 не станет RAID-Z2, а старые блоки сохранят прежнее соотношение данных и чётности. Это влияет на доступную ёмкость. Уменьшение за счёт удаления диска не поддерживается.
Кэш и память: ARC, L2ARC и SLOG
Механизмы ускорения решают разные задачи:
- ARC хранит востребованные данные и метаданные в оперативной памяти.
- L2ARC — дополнительный кэш чтения на SSD. Полезен для повторного чтения данных, не помещающихся в ARC. Требует памяти для учёта блоков, запись не ускоряет.
- SLOG — отдельное устройство журнала намерений ZIL. Может ускорить подтверждение синхронной записи — надёжного сохранения до продолжения работы приложения.
SLOG не ускоряет обычную асинхронную запись. Без него ZIL размещается в основном пуле. Для SLOG нужен накопитель с низкой задержкой и защитой от потери питания; для ответственных систем — зеркало. Отключение синхронной записи ради скорости меняет гарантии сохранности данных.
У ZFS, вопреки расхожим мифам, нет единого минимума 8 ГБ и обязательной нормы памяти на терабайт. Потребности зависят от приложений, активных данных и функций хранения. В руководстве TrueNAS минимум 8 ГБ относится ко всей системе TrueNAS.
ECC желательна, но не обязательна, это тоже миф: она исправляет часть ошибок ОЗУ. В конфигураторе Сервер Молл предусматривают память для приложений и ARC, поддержку ECC платой и процессором. L2ARC не заменяет достаточный объём ОЗУ.
Снапшоты, сжатие и дедупликация
Снимки состояния
Снапшот фиксирует состояние датасета или zvol. Он удерживает ссылки на существующие блоки без полного копирования данных. Место расходуется по мере изменений: старые блоки приходится сохранять ради снимка.
Снимок помогает вернуть файл или откатить датасет после обновления. Но он не переживёт потерю пула и не заменяет резервную копию.
Снимки передают на отдельное хранилище через zfs send и zfs receive, включая только изменения. Для согласованности базы данных или ВМ нужна остановка записи либо штатный механизм приложения.
Сжатие и удаление дубликатов
lz4 — быстрый начальный вариант сжатия с небольшой нагрузкой на процессор. zstd позволяет выбрать баланс между плотностью и вычислительными затратами. Архивы и видео сжимаются хуже текста.
Сжатие задаётся по датасетам и действует на новые записи. Старые блоки автоматически не пересжимаются. Результат показывает compressratio.
Дедупликация хранит одинаковые блоки в одном экземпляре, но требует ресурсов для таблицы их использования. Перед включением оценивают повторяемость данных, память и скорость хранения таблицы. Для небольшого сервера разумнее начать со сжатия без дедупликации.
Установка и настройка ZFS
Для пула данных важна комплектация: корзина, HBA, кабели, охлаждение и прямой доступ к дискам. При выборе стоечного сервера проверяют именно эти возможности, а не только название модели.
Установка зависит от операционной системы:
- Ubuntu: включить репозиторий universe, выполнить sudo apt update и sudo apt install zfsutils-linux. Модуль для штатного ядра поставляется пакетами дистрибутива.
- Debian: включить contrib, установить заголовки используемого ядра, затем sudo apt install zfs-dkms zfsutils-linux. При Secure Boot потребуется корректно подписать и разрешить загрузку модуля.
- FreeBSD: ZFS входит в базовую систему; при необходимости модуль загружают командой kldload zfs, а службу включают через sysrc zfs_enable="YES".
Ниже показан пример работы с отдельным пулом данных в Linux. В FreeBSD используют другие имена устройств; порядок работы описан в официальном руководстве.
Создание пула и датасетов
Постоянные имена /dev/disk/by-id/ сопоставляют с серийными номерами дисков. В отличие от /dev/sda, они не зависят от порядка обнаружения устройств.
Пример создаёт зеркало из двух пустых дисков. DISK_A и DISK_B заменяют реальными идентификаторами. Создание пула меняет разметку выбранных накопителей и не сохраняет прежние данные.
sudo zpool create -o ashift=12 tank mirror \
   /dev/disk/by-id/DISK_A \
   /dev/disk/by-id/DISK_B

 sudo zfs create -o compression=lz4 \
   -o mountpoint=/srv/documents tank/documents
 sudo zfs set quota=500G tank/documents

 sudo zpool status tank
 sudo zfs list
ashift=12 соответствует сектору 4096 байт, включая диски 512e. Для большего физического сектора выбирают другое значение. У созданного vdev его нельзя просто изменить.
Подключение пула на другом сервере
Конфигурация хранится на дисках: пул можно перенести на совместимый сервер без исходного HBA.
На исходном сервере останавливают приложения и выполняют экспорт:
sudo zpool export tankНа новом сервере находят и подключают пул:
sudo zpool import -d /dev/disk/by-id
sudo zpool import -d /dev/disk/by-id tank
Новый узел должен поддерживать активные функции пула; зашифрованным датасетам нужны ключи. Одновременный импорт обычного пула на два сервера для записи недопустим.
Замена диска и восстановление
Проверка целостности
Проверка занятых блоков и её результат:
sudo zpool scrub tank
sudo zpool status -v tank
Scrub регулярно запускают в менее загруженные часы. При повторных ошибках исследуют диски, кабели, питание, HBA и память.
Замена накопителя
Неисправного участника находят через zpool status и сопоставляют с физическим накопителем. После подключения нового диска выполняют замену:
sudo zpool replace tank OLD_DEVICE \
   /dev/disk/by-id/NEW_DISK
 sudo zpool status tank
OLD_DEVICE — имя или числовой идентификатор из состояния пула, NEW_DISK — идентификатор нового пустого диска. Его доступная ёмкость должна быть достаточной для замены.
resilver восстанавливает данные на новом диске; до завершения запас защиты уменьшен. Scrub проверяет существующие блоки, resilver восстанавливает копии. Если избыточности уже недостаточно, нужна резервная копия.
Возврат к снимку
Создание снимка и последующий откат:
sudo zfs snapshot tank/documents@before-change
sudo zfs rollback tank/documents@before-change
Откат после остановки приложений отменяет все изменения после снимка. Для одного файла лучше скопировать только его. Более новые снимки блокируют обычный откат к старому; их принудительное удаление требует отдельного решения. Длительное хранение снимка не рекомендуется - требует места и влияет на производительность. Для длительного хранения точки отката лучше использовать Backup.
ZFS в Proxmox VE
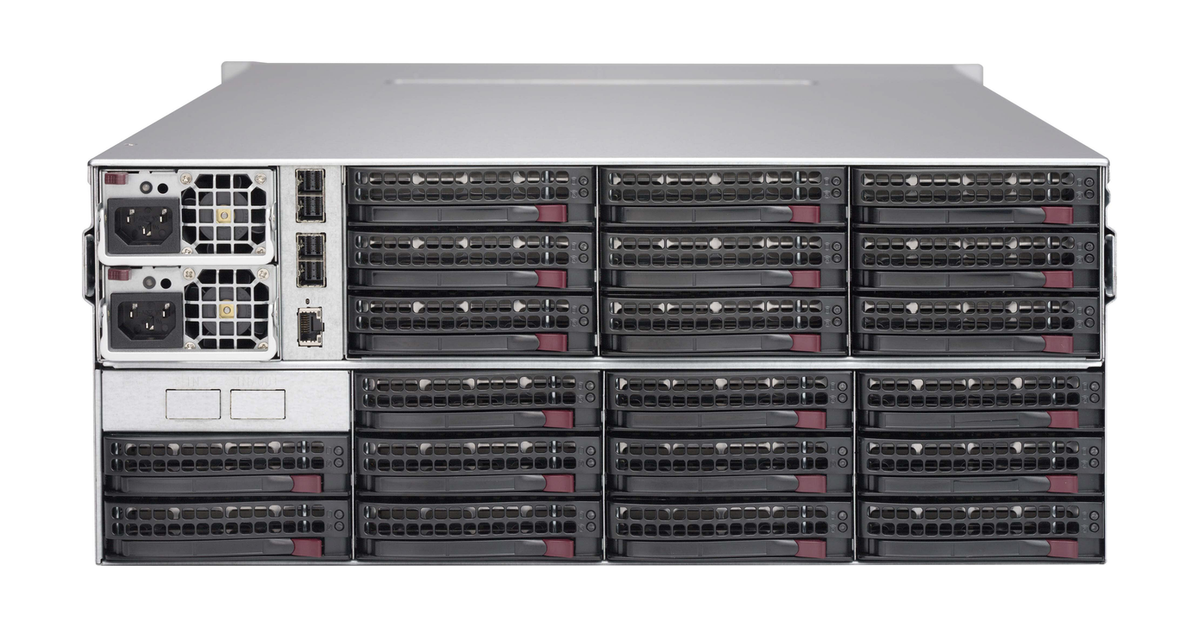
Задняя панель Supermicro SC847E1C-R1K23JBOD: дисковые отсеки, питание и подключения. Источник: Supermicro.
Установщик Proxmox VE предлагает ZFS с зеркалами, RAID-Z1, RAID-Z2 или RAID-Z3. Аппаратный RAID заранее не создают. Для ВМ используются zvol, для контейнеров — файловые датасеты.
Для новых установок с Proxmox VE 8.1 лимит ARC — 10% физической памяти, максимум 16 ГиБ. После обновления старой системы настройка может отличаться. Значение хранится в /etc/modprobe.d/zfs.conf.
Выбирая хранилище ВМ, учитывают задачи:
- ZFS удобна, когда нужны контрольные суммы, собственная дисковая избыточность, снимки и репликация между узлами.
- ext4 и LVM-thin подходят, когда нужен привычный стек Linux и функции ZFS не оправдывают дополнительную настройку. Снимки виртуальных дисков в таком варианте предоставляет LVM-thin, а не ext4.
ZFS не всегда быстрее или медленнее ext4. Сравнивают одинаковые диски, нагрузку ВМ и гарантии синхронной записи, учитывают сжатие, заполнение и размер блоков. Настройки памяти описаны в руководстве Proxmox VE.
Подбор платформы разобран в статье Сервер Молл «Как выбрать сервер для Proxmox». Выбирая сервер для виртуализации, учитывают схему дисков, количество ВМ и активные данные.
ZFS или ext4: в чём разница
Функции ext4 можно дополнить отдельными средствами RAID, управления томами и копирования.
| Возможность | ZFS | ext4 |
|---|---|---|
| Управление дисками | Пулы и vdev встроены | RAID и тома организуют отдельно |
| Контроль целостности | Контрольные суммы данных и метаданных | Есть защита ряда метаданных; штатной проверки содержимого всех файлов нет |
| Исправление повреждений | По исправной копии или чётности при наличии избыточности | Нужны средства других уровней и резервные копии |
| Снимки состояния | Встроены для датасетов и zvol | Нужен другой уровень, например LVM |
| Сжатие | Встроено, настраивается по датасетам | Штатного прозрачного сжатия нет |
| Перенос изменений | Передача между снимками через send/receive | Внешние средства копирования |
| Поддержка Linux | Отдельный модуль и совместимые пакеты | В основном ядре Linux |
Сконвертировать ext4 в ZFS на месте нельзя. Данные переносят на другой носитель, создают пул и возвращают обратно либо мигрируют на новый сервер. Для этого нужны временная ёмкость и время.
Минусы и когда ZFS не нужна
Схему пула сложнее изменить, чем свойства датасета. Основные ограничения:
- ARC конкурирует за память с приложениями.
- Администратору нужно понимать vdev, функции пула и восстановление.
- RAID-Z vdev нельзя убрать из пула. Расширение добавлением диска не даёт возможности потом уменьшить его или сменить уровень чётности.
- Для записи с копированием нужен запас свободного места. Переполнение осложняет обслуживание и снижает скорость.
ZFS может быть избыточна для небольшой ВМ с одним виртуальным диском, системного раздела или воспроизводимых временных данных. Если задача решается ext4 и резервным копированием, усложнять хранение необязательно.
ZFS оправдана, когда нужны вместе контроль целостности, избыточность, снимки и перенос изменений. Начать стоит с понятной схемы дисков, сжатия и отдельного резервного копирования, а дополнительные устройства выбирать по реальной нагрузке.