

GPU серверы HPE для AI

от 9 000 000 ₽
312 750 ₽/мес в лизинг
от 7 377 049 ₽
+ 1 622 951 НДС

от 9 000 000 ₽
312 750 ₽/мес в лизинг
от 7 377 049 ₽
+ 1 622 951 НДС

от 73 169 988 ₽
2 542 657 ₽/мес в лизинг
от 59 975 400 ₽
+ 13 194 588 НДС

от 51 253 298 ₽
1 781 052 ₽/мес в лизинг
от 42 010 900 ₽
+ 9 242 398 НДС
Полезные статьи

Серверы HPE для искусственного интеллекта и GPU-вычислений
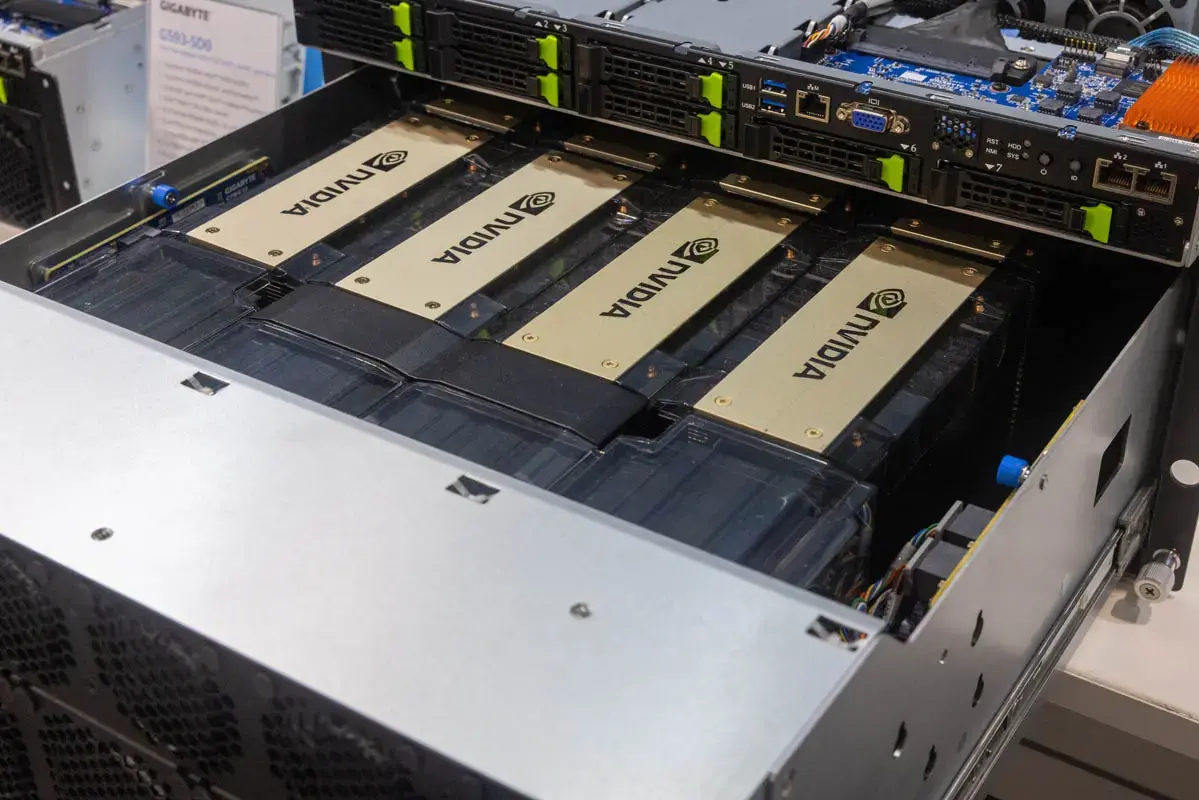
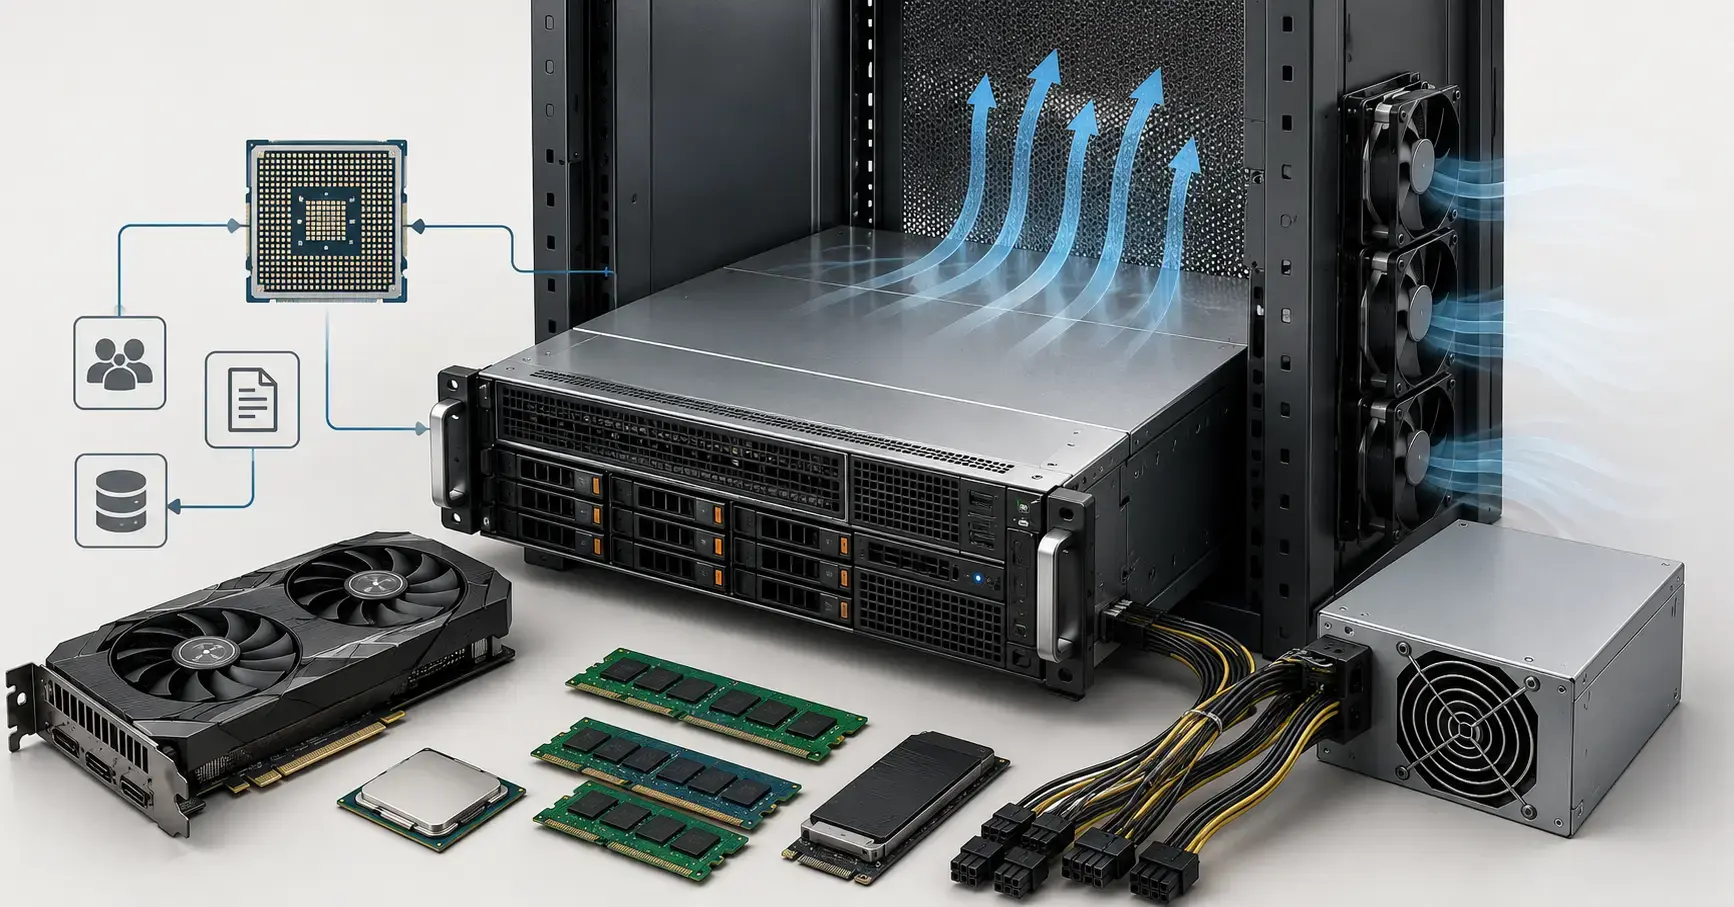
Серверы HPE для AI предназначены для обучения нейросетей, инференса больших языковых моделей и высокопроизводительных вычислений. В каталоге представлены универсальные HPE ProLiant для корпоративных ИИ-сервисов и плотные HPE Cray с восемью связанными ускорителями.
Эти системы различаются не только количеством GPU. HPE ProLiant проще интегрировать в существующую корпоративную инфраструктуру, а HPE Cray рассчитан на крупные модели, распределённое обучение и вычислительные кластеры.
Для каких задач подходят AI-серверы HPE
-
Инференс LLM. Серверы используют для корпоративных ассистентов, RAG-систем, обработки документов и других сервисов на базе языковых моделей.
-
Дообучение моделей. Несколько ускорителей позволяют адаптировать готовые модели под данные и бизнес-процессы компании.
-
Обучение нейросетей. HPE Cray с восемью GPU подходит для распределённой работы с языковыми, мультимодальными и рекомендательными моделями.
-
HPC и научные расчёты. Серверы применяют в моделировании, биоинформатике, инженерных исследованиях и других параллельных вычислениях.
Максимальная GPU-конфигурация нужна не всегда. Для локального ассистента или ограниченного количества пользователей может быть достаточно нескольких ускорителей. Восемь связанных GPU оправданы, если модель не помещается на одном устройстве или нагрузка действительно поддерживает распределённые вычисления.
HPE ProLiant DL384 Gen12 с NVIDIA GH200
HPE ProLiant Compute DL384 Gen12 — компактный сервер 2U на базе NVIDIA GH200 Grace Hopper. В конфигурации NVL2 используются два суперчипа, каждый из которых объединяет ARM-процессор Grace и GPU Hopper через высокоскоростное когерентное соединение NVLink-C2C.
Такая архитектура уменьшает объём копирования данных между процессорной и графической памятью. Она подходит для инференса, RAG, дообучения и других задач, которым требуется большой общий объём быстрой памяти.
Перед покупкой следует проверить совместимость программного обеспечения с архитектурой ARM. Контейнеры и приложения, собранные только для x86, могут потребовать пересборки или замены отдельных компонентов.
HPE ProLiant DL380a Gen12 с GPU NVIDIA
HPE ProLiant Compute DL380a Gen12 — сервер 4U с двумя процессорами Intel Xeon 6 и отдельными ускорителями PCIe. Платформа поддерживает разные типы GPU и подходит для инференса, дообучения, виртуальных рабочих станций и корпоративных ИИ-приложений.
Представленная в каталоге конфигурация использует NVIDIA H200 NVL. Такие ускорители располагают большим объёмом HBM3e и могут соединяться попарно через NVLink, но не образуют единую восьмичиповую платформу с NVSwitch, как в сервере NVIDIA HGX.
DL380a удобен, когда требуется гибкость: несколько независимых GPU можно распределить между разными приложениями или использовать для одновременного обслуживания нескольких моделей. При этом точное количество и топологию ускорителей необходимо согласовать до заказа.
HPE Cray XD670 для обучения и HPC
HPE Cray XD670 — специализированная система 5U с восемью ускорителями NVIDIA H100 или H200 SXM. GPU связаны через NVLink и NVSwitch, поэтому сервер подходит для задач, в которых одна модель распределяется между всеми ускорителями.
Сервер с NVIDIA H100 можно выбрать для проектов на архитектуре Hopper, которым достаточно 80 ГБ памяти на GPU. Это рациональный вариант для уже настроенного программного стека и моделей умеренного размера.
Сервер с NVIDIA H200 предоставляет 141 ГБ HBM3e на каждый ускоритель. Дополнительная память полезна для крупных моделей, длинного контекста и большого KV-кэша, а также может уменьшить необходимость распределять модель между несколькими узлами.
Переход с H100 на H200 имеет смысл, когда ограничением является именно объём или пропускная способность GPU-памяти. Если задача упирается в CPU, хранение данных или сеть, замена ускорителей сама по себе проблему не решит.
Управление серверами HPE
Для удалённого администрирования серверов HPE используется контроллер iLO. Он позволяет отслеживать состояние компонентов, управлять питанием, устанавливать обновления и диагностировать аппаратные проблемы без физического доступа к системе.
HPE Compute Ops Management и другие инструменты управления помогают контролировать несколько серверов и стандартизировать обслуживание. Для крупной ИИ-инфраструктуры это особенно важно: простой вычислительного узла с дорогими GPU обходится значительно дороже обычной серверной неисправности.
Что проверить перед покупкой AI-сервера HPE
Процессоры должны успевать выполнять токенизацию и подготовку данных, оперативная память — хранить датасеты и промежуточные результаты, а NVMe-накопители — быстро загружать модели и сохранять контрольные точки.
Для объединения нескольких HPE Cray потребуется производительная сеть с поддержкой RDMA. В зависимости от архитектуры кластера можно использовать InfiniBand, высокоскоростной Ethernet или HPE Slingshot. Хранилище также должно обеспечивать одновременную работу всех вычислительных узлов.
До поставки необходимо проверить глубину корпуса, доступную мощность стойки и возможности охлаждения ЦОД. HPE Cray XD670 выпускается с воздушным и прямым жидкостным охлаждением, а выбор конкретного варианта зависит от плотности размещения и инфраструктуры площадки.
Цена и покупка сервера HPE для AI
Цена сервера HPE для искусственного интеллекта зависит от модели, количества и типа GPU, процессоров, оперативной памяти, накопителей, сети и системы охлаждения. В бюджет проекта также следует включить коммутацию, хранилище и подготовку ЦОД.
Специалисты Сервер Молл помогут подобрать HPE ProLiant или HPE Cray для инференса, обучения и HPC, проверить программную совместимость и требования к размещению. Конфигурацию можно скорректировать под используемую модель и планируемую нагрузку.
Вопросы и ответы
Не нашли нужной информации? Спросите — мы ответим!
Какие условия доставки?
Сроки доставки обычно составляют: 1 рабочий день по Москве и Санкт-Петербургу, по России — 3–5 рабочих дней (в зависимости от региона и перевозчика).
Что входит в гарантию?
Гарантия «Сервер Молл»: 5 лет на серверы и СХД, 1 год на комплектующие, 6 месяцев на Б/У накопители.
8 причин купить GPU серверы HPE для AI в СЕРВЕР МОЛЛ
для людей, а не для галочки: без мелочей вроде платной доставки до транспортной компании
5 лет гарантии
с выездом
Берём все логистические и технические расходы на себя. Быстро реагируем, обрабатываем и закрываем заявки. Собственные сервисные центры, склады и надёжные логистические партнёры — всё, чтобы ваши бизнес-процессы работали 24/365.


СЕРВЕР МОЛЛ — крупнейший поставщик оборудования Dell, HPE и Lenovo в России и СНГ
Мы сэкономим ваше время!
Поможем, расскажем, посоветуем.


