Привет, друзья!
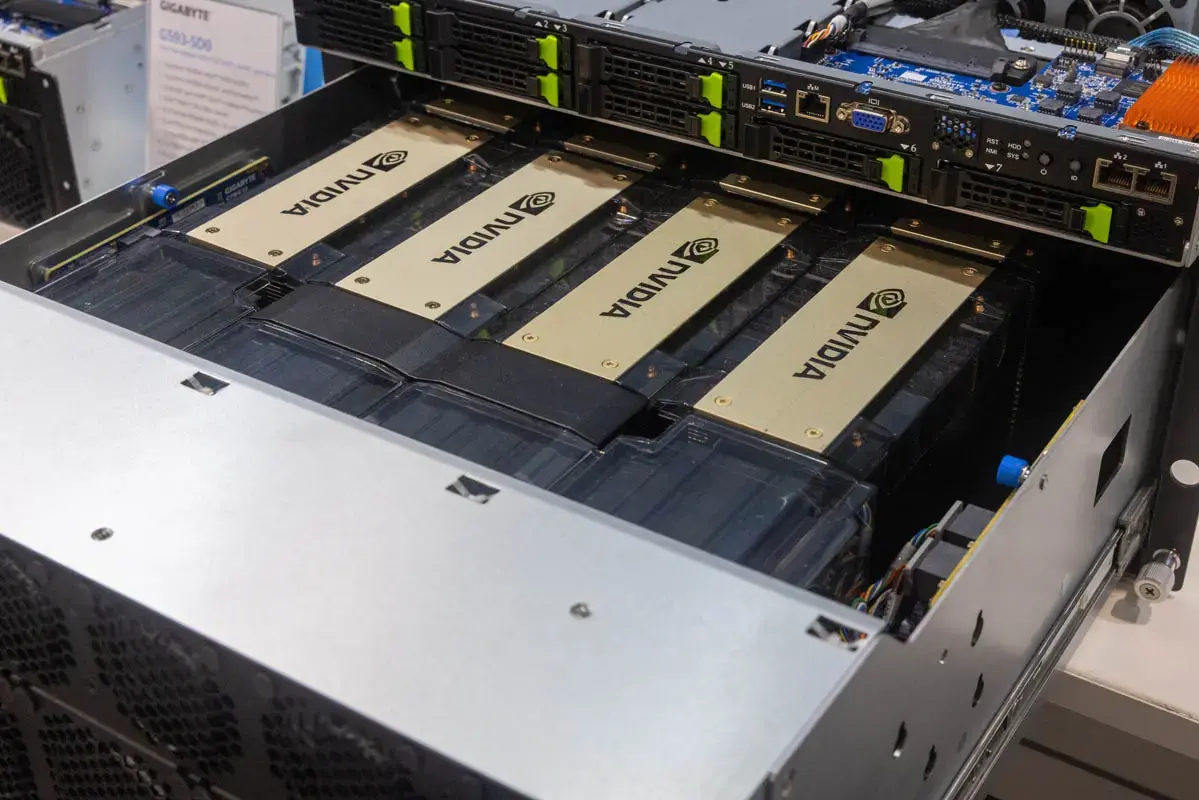
NVIDIA — первая в истории компания, капитализация которой превысила $5 трлн, что примерно на уровне номинального ВВП Германии за прошлый год. А всё почему? NVIDIA продаёт GPU компаниям, которые работают с ИИ (для сравнения: игровое направление приносит всего ~10% выручки, а ИИ-ускорители аж ~87%).
Или возьмём акции AMD (капитализация на уровне ~$900 млн) — с января 2026 года они выросли более чем на 144%, что даже выше темпов роста Nvidia в этом году. И всё из-за поставок ИИ-чипов для дата-центров OpenAI, Google, Microsoft и т.д.
Цунами из больших языковых моделей (LLM, Large Language Model) и генеративного ИИ накрыло весь мир и всего за несколько лет изменило всю IT-индустрию. Публичные облака не справляются со спросом крупных заказчиков (гиперскейлеры, вроде Amazon, Google, Microsoft), что привело к росту цен на аренду мощностей. Поэтому организации (частные и государственные — затронуло всех) строят свои ЦОДы с GPU и ищут решения, которые можно развернуть в локальной IT-инфраструктуре.
И рынок серверов подстроился мгновенно: ведущие вендоры уже не первое поколение создают специализированные платформы и серверы общего назначения с поддержкой профессиональных GPU. А поскольку при выборе железа нужно учитывать бизнес-задачи, бюджет и даже геополитические риски, то самое время во всём этом разобраться.
Приступим!
CPU vs GPU: когда нужен графический ускоритель

Графические процессоры (GPU, Graphics Processing Unit) во многом похожи на классические центральные процессоры (CPU, Central Processing Unit), но они превосходят CPU в пиковой производительности на потребляемый ватт энергии в специфических задачах (машинное обучение aka ML, высокопроизводительные вычисления aka HPC, рендеринг).
Для несложных задач (разработка, инференс aka вывод небольших моделей) часто достаточно одного или двух GPU среднего уровня, а иногда и просто CPU. Топовые же ускорители (NVIDIA Blackwell B200/B300 стоимостью миллионы рублей), про которые бесконечно пишут в новостях, нужны только крупным компаниям и ЦОДам при обучении сложных моделей на сотни миллиардов параметров.
Зачем нужны GPU в ИИ
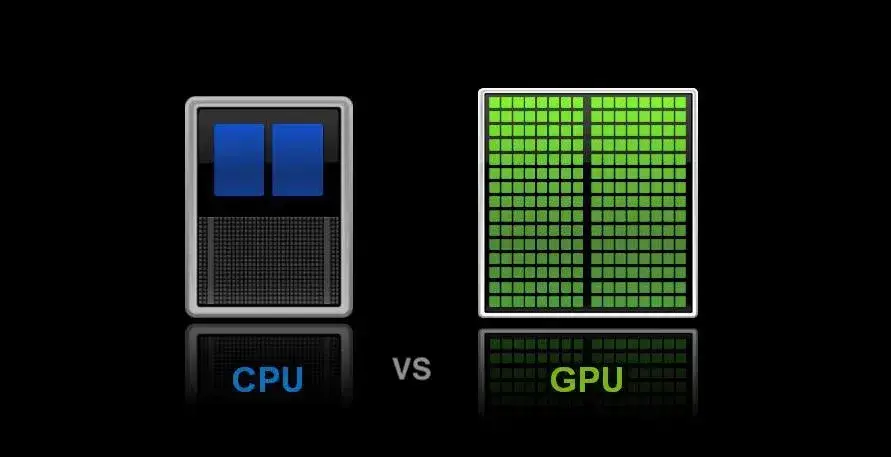
GPU работают с массовыми параллельными специализированными вычислениями и содержат тысячи относительно простых вычислительных ядер (вместо единиц, десятков и сотен более сложных ядер у CPU). GPU очень требовательны к оптимизации кода, потому что их производительность сильно зависит от эффективного распараллеливания нагрузки между тысячами ядер. Если код содержит слишком много ветвлений, обращения к памяти разбросаны или данные не выровнены по структурам, производительность резко упадёт. Поэтому фреймворки (PyTorch, TensorFlow) и библиотеки (CUDA, ROCm) постоянно улучшаются.
Поэтому программы для GPU часто пишут с учётом архитектуры конкретного ускорителя — оптимизируют память, минимизируют ветвления и стараются загружать вычислительные блоки максимально равномерно.
Но так было не всегда. Изначально GPU использовали для рендеринга трёхмерной графики, но со временем инженеры заметили, что их архитектура отлично подходит и для других задач — от физического моделирования до обучения нейросетей.
Так и появилось направление GPGPU (General-Purpose computing on Graphics Processing Units) — использование графических процессоров для общих вычислений.
Топовые GPGPU и GPU кратно превосходят лучшие CPU по пиковой производительности (и в том числе на 1 ватт затрачиваемой энергии) в оптимизированных задачах, и именно это позволило создать современные LLM и генеративный ИИ, вроде ChatGPT и Sora. Но не под все задачи нужны серверы с ускорителями NVIDIA B300 Blackwell Ultra за десятки и сотни миллионов рублей — это хайэнд сегмент для Enterprise-бизнеса, гиперскейлеров и других техногигантов.
Зачем нужны CPU в ИИ
Они намного универсальнее — распределяют задачи, управляют потоками, обрабатывают последовательную логику, общаются с ОС и прочим оборудованием. А из-за того, что CPU лучше оптимизированы для быстрого выполнения отдельных последовательных задач, современные серверы сочетают как универсальные CPU, сотни гигабайт памяти DDR5, NVMe SSD, так и GPU (один или несколько) для специализированных вычислений. То есть в сервере CPU и GPU (если он есть) обрабатывают данные вместе, но каждый — свои.
CPU, в отличие от GPU, не требует настолько качественной оптимизации исполняемого кода, так как может частично компенсировать неэффективный код за счёт сложных механизмов предсказания и кэширования.
Как понять, что вам уже нужен GPU
Всё зависит от задач.
Для классических офисных и базовых задач ИИ достаточно обычных серверов с современным CPU. Например, в Intel Xeon (начиная с Scalable 4-го поколения) встроена технология Intel AMX (Advanced Matrix Extensions), а в AMD EPYC — поддержка инструкций AVX-512 VNNI. То есть они подходят для матричных вычислений и ускоряют работу нейросетей в разы по сравнению со старыми CPU. При этом CPU не так сильно ограничены памятью (ОЗУ можно расширять до терабайтов).
Если добавляются несложные ИИ-задачи, то достаточно обычного сервера на CPU и нескольких GPU среднего уровня. Например, запуск корпоративных чат-ботов на базе небольших открытых моделей (Llama 3 8B, Mistral 7B или Phi-3) для работы с внутренними регламентами и базами знаний. Различные ИИ-агенты (парсинг почты, классификация заявок от клиентов, автоматическое заполнение CRM), компьютерное зрение на местах (распознавание лиц, контроль качества на конвейере), простой инференс, обучение малых моделей, анализ структурированных данных, речевые технологии.
Для ресурсоёмких задач, где нужны колоссальные объёмы памяти и высокая скорость обработки данных, придётся покупать дорогие специализированные GPU — без них никуда. Обучение или инференс больших языковых моделей (LLM: например, ChatGPT, DeepSeek, Grok или Gemini), масштабный RAG (Retrieval-Augmented Generation, генерация с дополненной выборкой, например, поиск дополнительных данных в интернете для ответа), сложные научные симуляции, финансовое моделирование и аналитика, мультимодальный ИИ (обработка видеопотоков в реальном времени, синтез фотореалистичной 3D-графики, работа с изображениями и звуком) и другое.
Графические ускорители NVIDIA (GPU): от Volta и Hopper до Blackwell и Vera Rubin
Сегодня NVIDIA доминирует на рынке ИИ-ускорителей — занимает около 90% рынка серверных GPU.
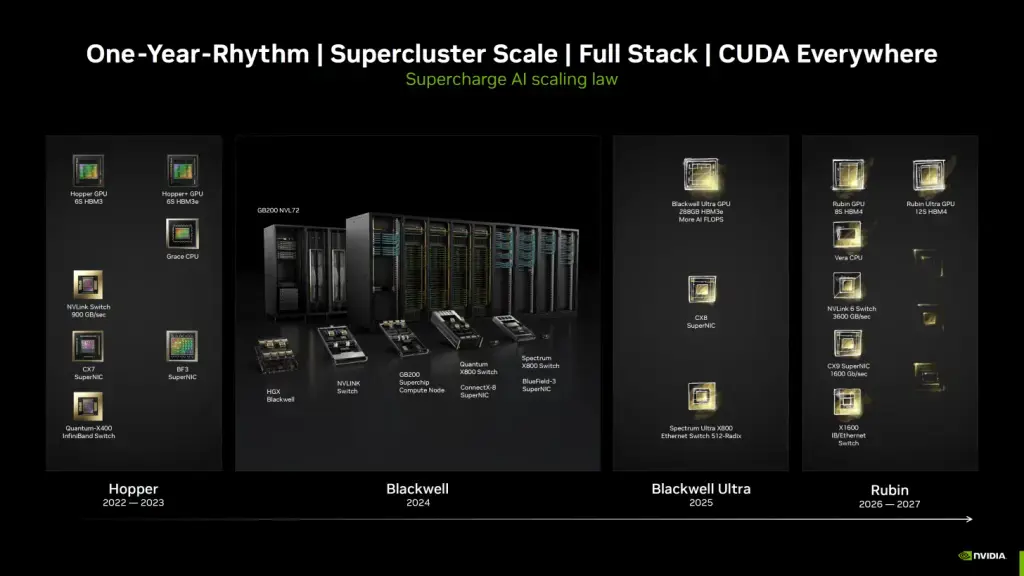
На архитектуре Hopper (H100/H200) прямо сейчас работает огромное количество ЦОДов по всему миру, но большинство новых крупных проектов строится на платформе Blackwell (B200/GB200) и новейшей Blackwell Ultra (B300/GB200) — между ними огромная пропасть в технологиях и производительности.

Итак, всё началось с NVIDIA TESLA V100 — ускорителя на архитектуре Volta (2017 год) для задач машинного обучения и HPC. Именно там впервые появились тензорные ядра первого поколения, ускорившие обучение нейросетей, а также память HBM2 с пропускной способностью до 900 ГБ/с. Затем последовали архитектуры Turing (модифицированная Volta, в профессиональном сегменте не получившая широкого распространения для ИИ) и Ampere (2020 год).

Ускоритель NVIDIA A100 (Ampere) получил тензорные ядра третьего поколения, память HBM2e (2 ТБ/с) и возможность разделения GPU на несколько независимых инстансов (Multi-Instance GPU, он же MIG) — то есть один ускоритель можно использовать параллельно для разных задач. Для обучения самой первой модели ChatGPT (OpenAI) использовали порядка 10 000 штук Nvidia A100 в суперкомпьютере.

Следующий заметный ускоритель — NVIDIA H100 — построен по архитектуре Hopper (2022 год) с памятью HBM3 и пиковой производительностью для ИИ до 4 PFLOPS в формате FP8 и 2 PFLOPS в BF16/FP16 при энергопотреблении до 700 Вт. Он стал основой большинства современных ИИ-кластеров первого поколения. Самая первая версия Grok (xAI) обучалась на кластере примерно из 20 000 ускорителей Nvidia H100.
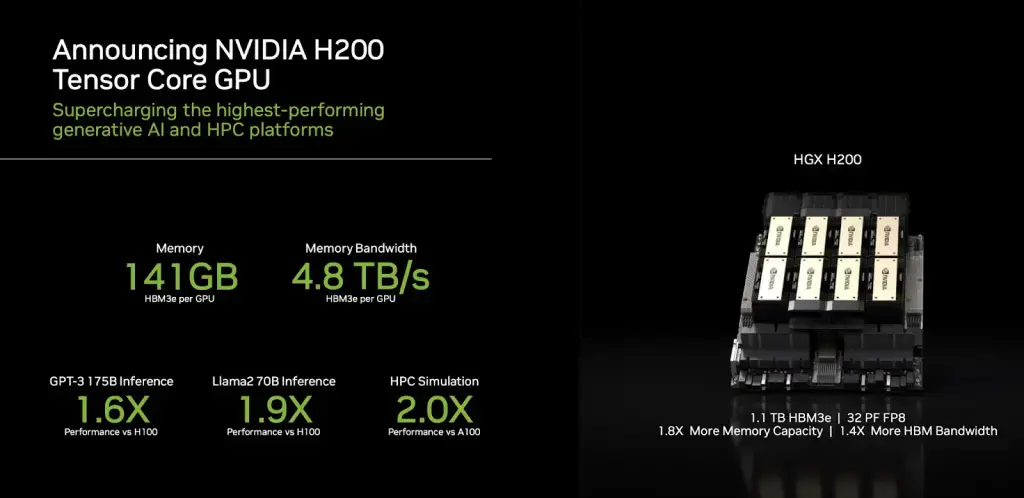
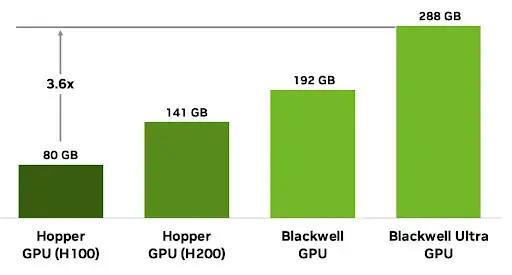
Следом появился ускоритель NVIDIA H200. Он сохранил архитектуру Hopper и поддержку NVLink четвёртого поколения (подробнее об этом — ниже), но получил более быструю память HBM3e объёмом 141 ГБ и с пропускной способностью около 4,8 ТБ/с, что повысило эффективность при работе с очень большими моделями. Значительная часть суперкомпьютера Илона Маска Colossus была усилена именно картами H200 для ускорения обучения Grok 2 и Grok 3.
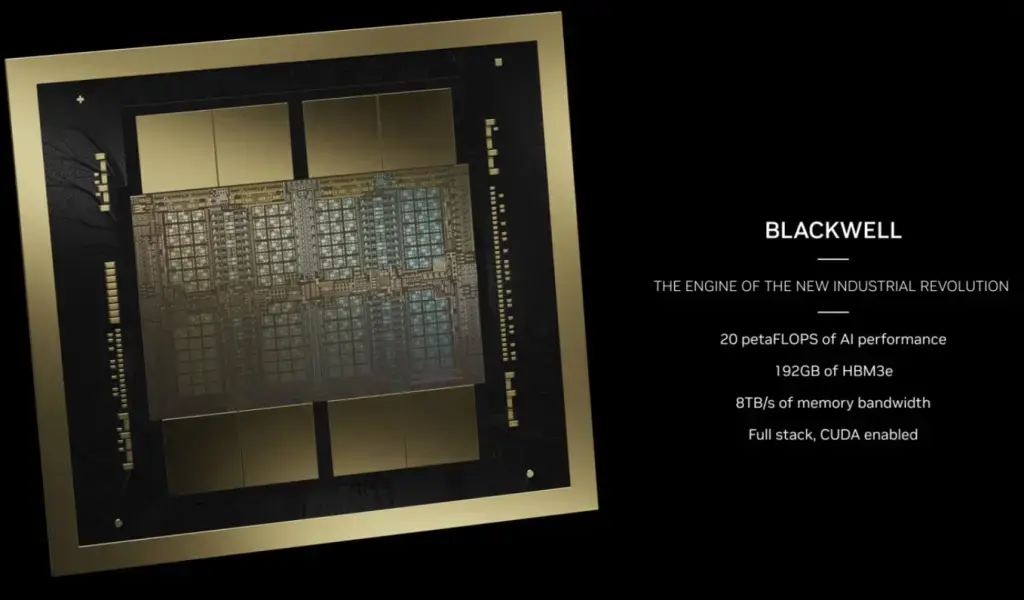
Следующая архитектура (Blackwell) сделала качественный скачок. Интересно, что на конференции GTC 2024 компания представила ускоритель B100 как референсную модель, а массовые поставки начались сразу с ускорителей B200 и суперчипов GB200 Grace Blackwell. Новая архитектура получила тензорные ядра пятого поколения, поддержку вычислений FP4 и FP6, существенно увеличенную пропускную способность памяти и оптимизации специально для современных моделей генеративного ИИ.

Почему GB200 — это суперчип? Он объединяет два GPU B200 и Grace CPU внутренним NV-HBI-интерфейсом с пропускной способностью 10 ТБ/с. Он использует память HBM3e и обеспечивает до 40 PFLOPS производительности в ИИ-нагрузках. Если же рассматривать B200 как отдельный дискретный ускоритель (например, в составе платформ NVIDIA HGX B200), то у него аж 192 ГБ памяти HBM3e с пропускной способностью до 8 ТБ/с, что позволяет выдавать до 10 PFLOPS производительности в формате FP4 при энергопотреблении до 1200 Вт на GPU.
Флагманской платформой NVIDIA стало семейство Blackwell Ultra (B300/GB300). Каждый GPU B300 получил уже 288 ГБ памяти HBM3e с пропускной способностью до 8 ТБ/с. Blackwell Ultra значительно нарастила производительность в задачах обучения, инференса и особенно reasoning* моделях.
Ремарка!
Reasoning* — это способность модели логически рассуждать, планировать свои действия и проверять себя в процессе решения задачи. Если обычные языковые модели (LLM) выдают ответ почти мгновенно (хоть и слово за словом, а не целиком), то языковые модели рассуждений (RLM, Reasoning Language Models) перед выводом ответа создают иллюзию (или нет — вопрос философский) мыслей во внутреннем чате, строя цепочку рассуждений (CoT, Chain of Thought).
RLM — разновидность больших языковых моделей, которые дополнительно обучаются для решения задач, требующих выполнения нескольких последовательных шагов рассуждения.
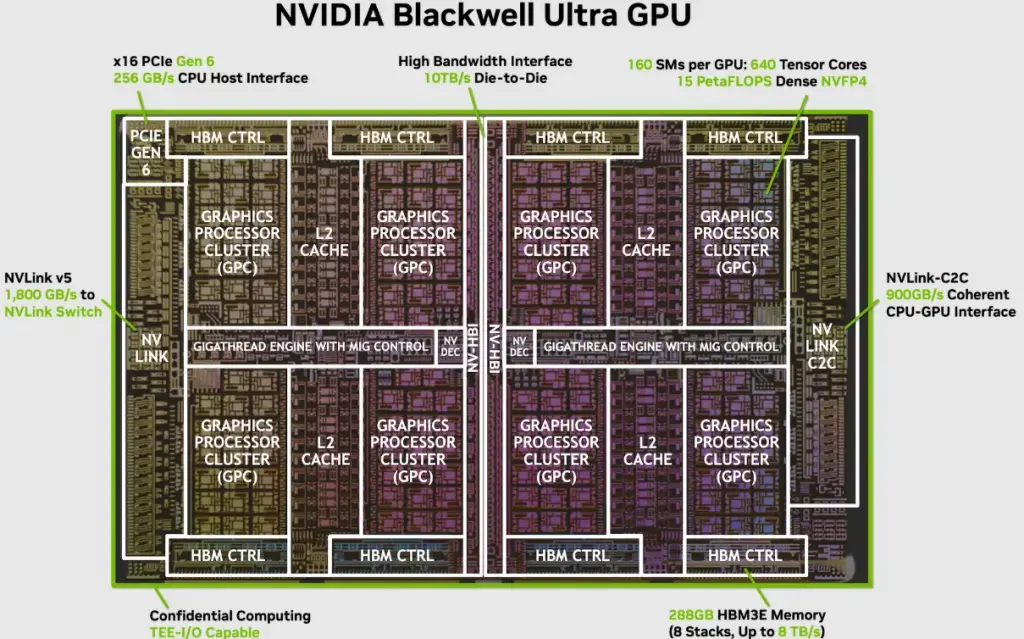
Физические кристаллы внутри платформы соединены через интерфейс NV-HBI, а между ускорителями используется NVLink пятого поколения с двунаправленной пропускной способностью до 1,8 ТБ/с на один GPU в домене NVSwitch. Производительность каждого ускорителя достигает 15 PFLOPS в формате FP4 при энергопотреблении до 1400 Вт, поэтому Blackwell Ultra — новый флагман для высокопроизводительных ИИ-кластеров.
Уже во второй половине года NVIDIA начнёт поставки платформы следующего поколения — Vera Rubin. Новое поколение состоит из шести тесно интегрированных компонентов — процессора Vera на архитектуре Arm (новые ядра Olympus), графического ускорителя Rubin, коммутатора NVLink шестого поколения, сетевого адаптера ConnectX-9 SuperNIC, DPU BlueField-4 и Ethernet-коммутатора Spectrum-6. Новая архитектура создана для агентного ИИ (Agentic AI), reasoning-моделей и моделей Mixture-of-Experts (MoE, разделение нейросети на подсети-эксперты).
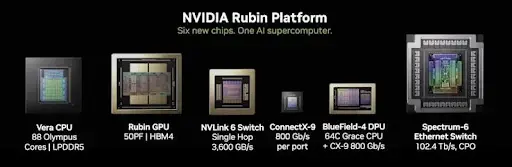
Сам графический процессор NVIDIA Rubin (официальное коммерческое название модели — R100) состоит из двух объединённых кристаллов на одной подложке (dual-reticle die), изготовлен по техпроцессу TSMC 3-нм и содержит около 336 миллиардов транзисторов. Ускоритель получит до 288 ГБ HBM4 с огромнейшей пропускной способностью — до 22 ТБ/с. Должно получиться до 50 PFLOPS в вычислениях FP4. Заявлена поддержка шины NVLink 6 (3,6 ТБ/с на GPU) и адаптеров ConnectX-9 (1,6 Тб/с) для эффективной работы в составе многонодовых систем.
Большинство новых ИИ-фабрик и ЦОДов будет строиться на этих NVIDIA Vera Rubin.
Межпроцессорное взаимодействие NVIDIA: NVLink, NVLink Switch, GB300 NVL72 и Vera Rubin NVL144
Когда в сервере работают сразу несколько GPU, нужно, чтобы обмен данными между ними не стал бутылочным горлышком. Раньше это происходило через PCIe, но позже компании начали разрабатывать проприетарные решения.
NVLink — это проприетарная высокоскоростная шина, которая позволяет нескольким GPU (а также GPU и CPU в определенных системах) напрямую обмениваться данными с очень высокой пропускной способностью, минуя узкие места PCIe. Это не просто протокол, а физическая шина с выделенными линиями связи. Прямое соединение P2P (точка-точка) даёт минимальные задержки.
Но что ещё важно — NVLink позволяет нескольким GPU работать с памятью друг друга как со своей собственной, избавляя систему от проблем копирования данных через CPU. Это критически важно для сложных вычислений в ИИ и HPC. Получается нечто вроде CXL с когерентной памятью, но здесь проприетарное решение NVIDIA, а не общедоступный стандарт. Почитать про CXL можете в нашем материале на Хабре.
|
Поколение |
Пропускная способность на GPU |
Макс. линков на GPU |
Архитектуры |
|
3-е |
600 ГБ/с |
12 |
Ampere (A100) |
|
4-е |
900 ГБ/с |
18 |
Hopper (H100/H200) |
|
5-е |
1800 ГБ/с |
18 |
Blackwell (B200/GB200) |

|
Поколение NVLink |
Пропускная способность на GPU |
Макс. линков на GPU |
Архитектуры |
|
1-е |
160 ГБ/с |
4 |
Pascal (P100) |
|
2-е |
200 ГБ/с |
4 |
Volta (V100) |
|
3-е |
600 ГБ/с |
12 |
Ampere (A100) |
|
4-е |
900 ГБ/с |
18 |
Hopper (H100/H200) |
|
5-е |
1800 ГБ/с |
18 |
Blackwell (B200/GB200) |
|
6-е |
3600 ГБ/с |
18 |
Vera Rubin (R100) |
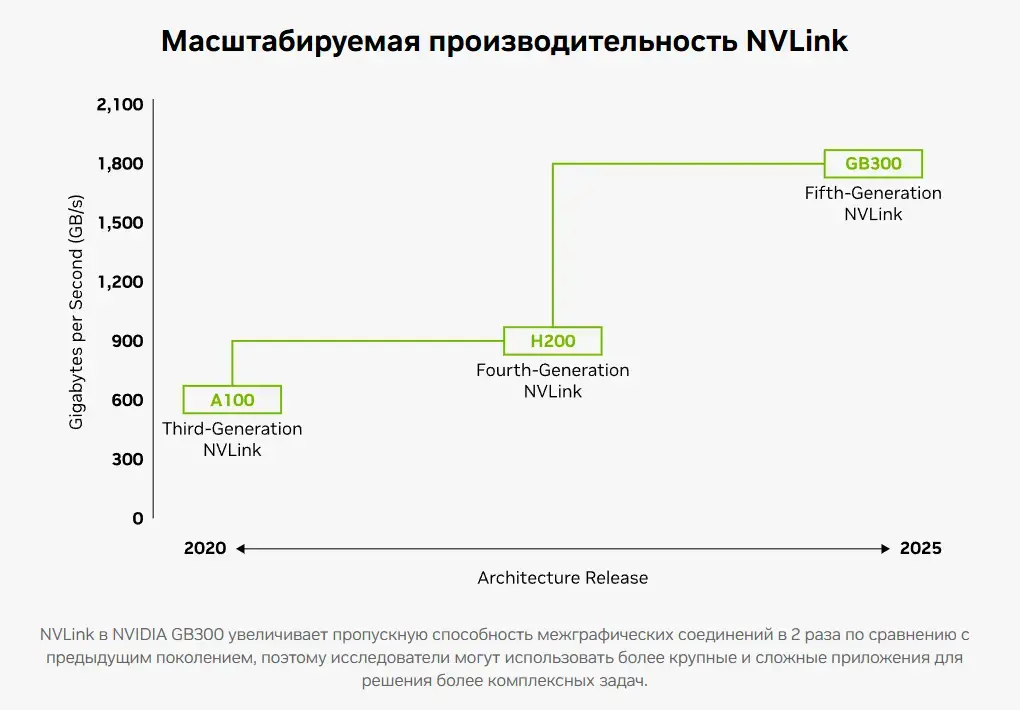
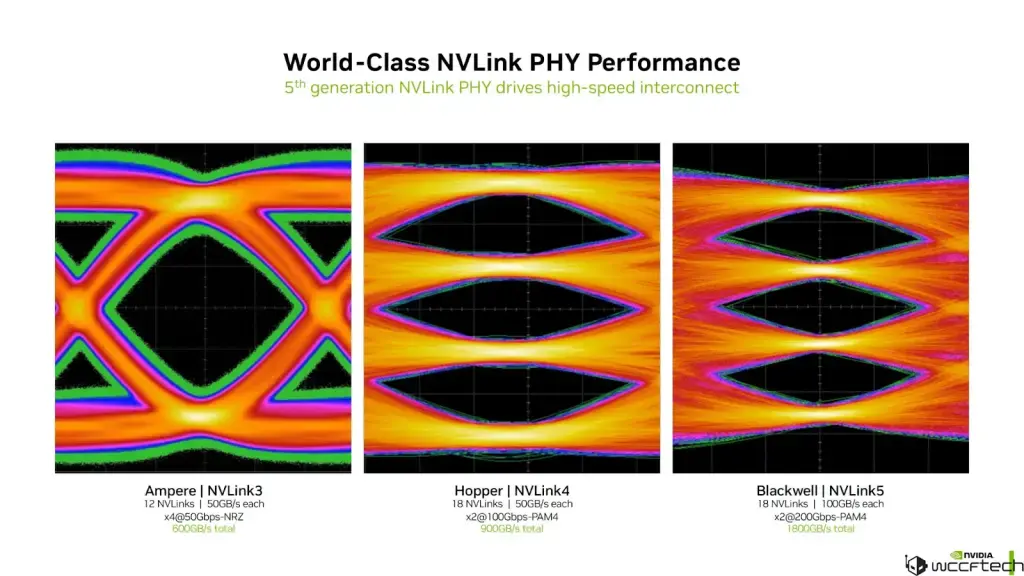
В пятом поколении архитектура NVLink поддерживает до 18 линков на ускоритель с пропускной способностью 100 ГБ/с каждое, что даёт суммарно до 1,8 ТБ/с двунаправленной передачи данных на GPU. Это вдвое больше, чем в предыдущем поколении, и в 7 раз выше, чем у PCIe 6.0 (256 ГБ/с через разъём x16).
Следующее, шестое поколение NVLink, дебютировавшее вместе с архитектурой Vera Rubin, удвоило пропускную способность до 3,6 ТБ/с на один GPU. Благодаря этому ускорители могут обмениваться ещё большими объёмами данных при обучении и инференсе крупных языковых моделей, а преимущество NVLink над PCIe 6.0 выросло уже примерно до 14 раз.

У NVIDIA есть технология NVLink Switch, которая предлагает высокоскоростную связь между несколькими GPU и CPU внутри узла или стойки. Работает она на аппаратном (физическом) чипе-коммутаторе, который соединяет несколько графических процессоров с помощью высокоскоростных интерфейсов NVLink. Если сама шина предлагает соединение чипов по P2P (точка-точка), то NVLink Switch соединяется несколько GPU по топологии A2A (All-to-all — то есть все узлы напрямую общаются друг с другом).
Это не сетевая технология в привычном смысле — она не заменяет Ethernet или InfiniBand в ЦОДе, а дополняет их внутренней шиной с низкими задержками.
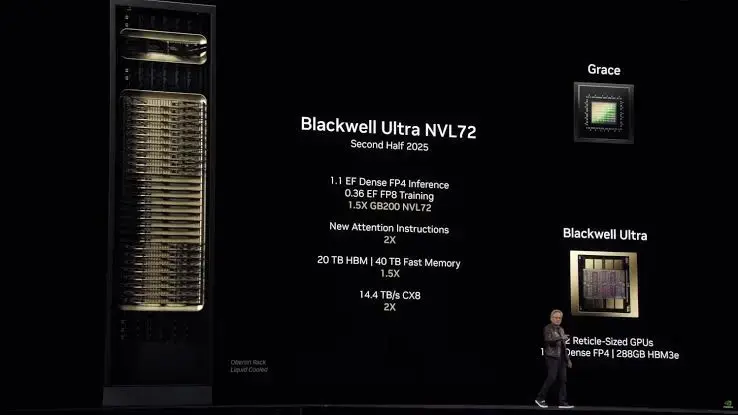
Например, 72 графических процессора NVIDIA Blackwell Ultra и 36 процессоров NVIDIA Grace на базе Arm в стойке NVIDIA GB300 NVL72 можно использовать как единый высокопроизводительный узел с вычислительной мощностью до 1,44 экзафлопс в FP4 для задач искусственного интеллекта.
По сравнению с предыдущим поколением платформа GB300 значительно ускоряет инференс и reasoning современных моделей, а также повышает эффективность работы агентных ИИ-систем.
Следующий шаг NVIDIA — платформа Vera Rubin NVL144. Она объединит 144 GPU Rubin и 72 процессора Vera через шину NVLink шестого поколения, что позволит лучше масштабировать ИИ-кластеры для обучения и инференса моделей следующего поколения.
AMD уже вывела на рынок платформу Instinct MI350/MI355X с архитектурой CDNA 4 и продолжает развивать открытую экосистему ROCm. Intel, в свою очередь, продолжает развивать линейку ускорителей Gaudi 3, однако сегодня основная конкуренция на рынке серверных ИИ-ускорителей разворачивается именно между NVIDIA Blackwell и AMD Instinct последних поколений.
GPU от AMD: линейка Instinct, Infinity Fabric и альтернатива NVIDIA
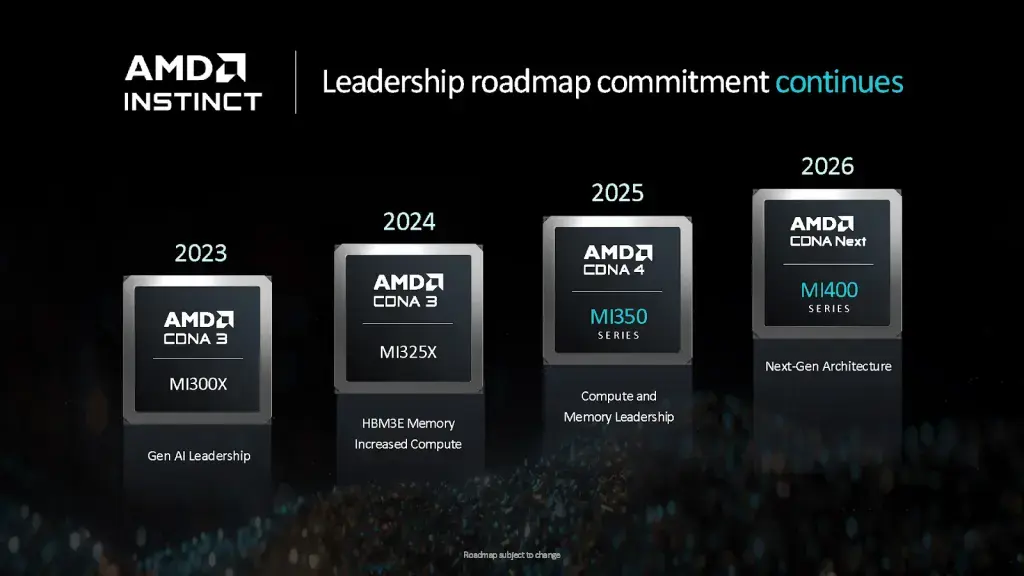
AMD — главный конкурент NVIDIA (хоть и не единственный) с долей рынка ИИ-чипов и GPU-вычислений около 4–6% (напомню — у NVIDIA около 90%). Да, AMD вошла в гонку ИИ-ускорителей немного позже NVIDIA, но за последние поколения заметно сократила отставание — как по производительности, так и по зрелости экосистемы.
Итак, линейка AMD Instinct — это профессиональные решения для ЦОДов, HPC (GPGPU) и ИИ-вычислений: глубокого обучения (DL), машинного обучения (ML), инференса больших языковых моделей, reasoning и агентных ИИ-систем. Она стала для AMD тем же, чем Ampere, Hopper и Blackwell стали для NVIDIA: ядром всего серверного сегмента и символом технологического прорыва компании.
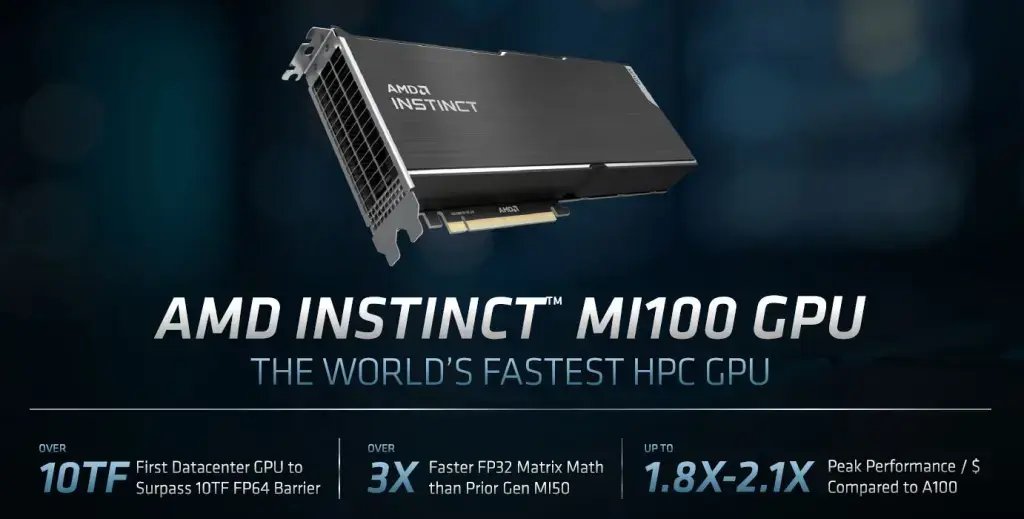
Первым серьёзным шагом стала серия AMD Instinct MI100, построенная на архитектуре CDNA. Она предлагала до 11,5 TFLOPS FP64 и 23.1 TFLOPS FP32, используя интерфейс PCIe 4.0 и память HBM2 с пропускной способностью около 1,2 ТБ/с. Уже тогда AMD сделала ставку на высокую плотность вычислений и энергоэффективность, ориентируясь на HPC-задачи и обучение моделей среднего масштаба.

Затем вышло поколение AMD Instinct MI200 — и вот здесь началась настоящая конкуренция с NVIDIA. Серия MI250/MI250X перешла на архитектуру CDNA 2 и получила двухчиповый дизайн (MCM), аналогичный тому, что NVIDIA реализовала позже в Blackwell. Каждый ускоритель содержал два кристалла, объединённых через Infinity Fabric, с совокупной пропускной способностью памяти HBM2e до 3,2 ТБ/с и производительностью до 95.7 TFLOPS в матричных операциях FP32. Эти GPU стали сердцем первого в мире экзафлопсного суперкомпьютера Frontier.
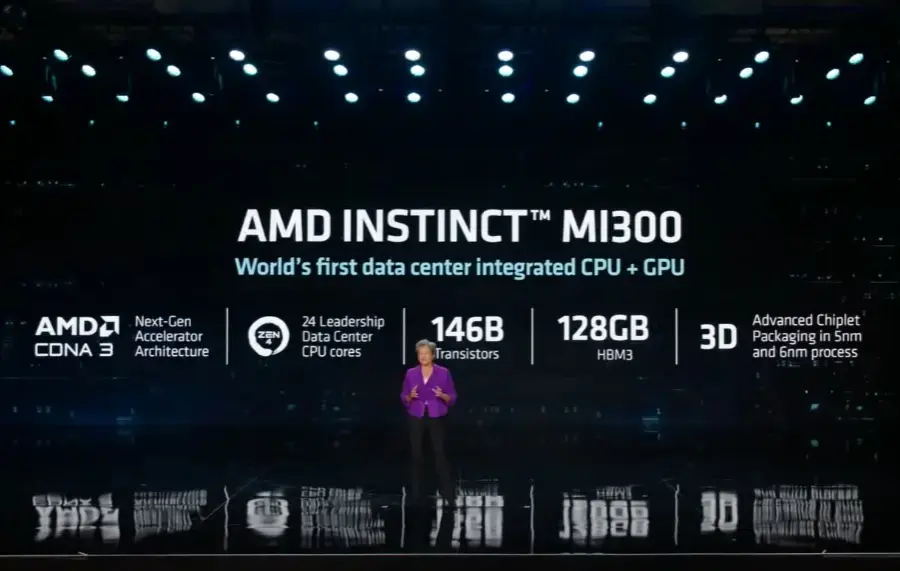
Следующим шагом стало семейство AMD Instinct MI300, где AMD объединила CPU и GPU в одном корпусе — APU для дата-центров. Вариант MI300A совмещает ядра Zen 4 и GPU CDNA 3, обеспечивая когерентность памяти и мгновенный обмен данными между CPU и GPU без внешних шин. Версия MI300X ориентирована исключительно на генеративные вычисления: 192 ГБ HBM3, пропускная способность свыше 5,3 ТБ/с с поддержкой FP8 и BF16 для ускорения ИИ-задач.
Даже после выхода нового поколения ускорителей MI300X остаётся востребованным во многих корпоративных ИИ-кластерах благодаря большому объёму памяти и зрелой программной экосистеме.
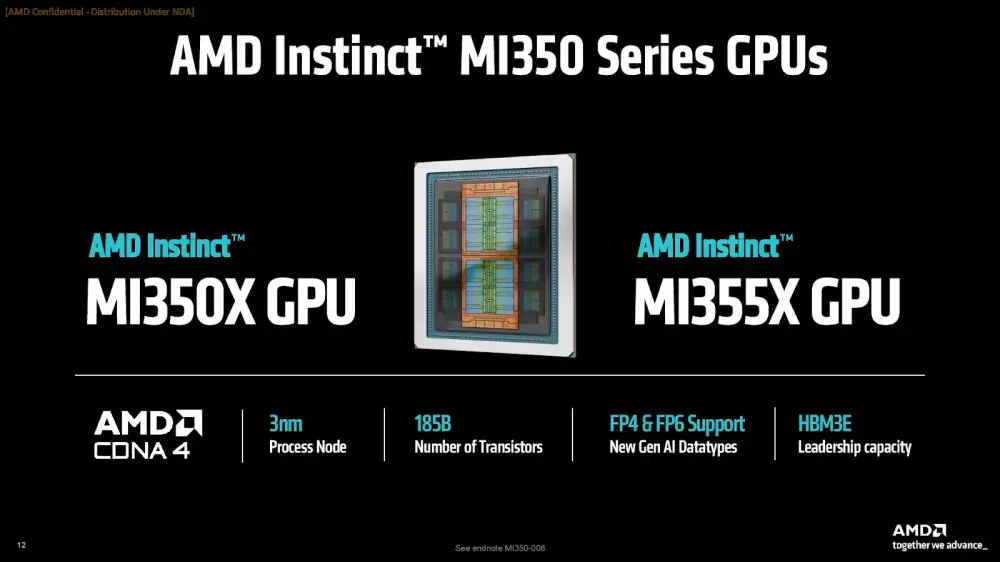
Далее вышло семейство MI350 на архитектуре CDNA 4. Ускорители MI350X и MI355X получили 288 ГБ памяти HBM3e с пропускной способностью до 8 ТБ/с, поддержку современных форматов вычислений FP8, FP6, FP4 и INT4, а также оптимизации специально для генеративного ИИ, reasoning и агентных систем. В одной платформе можно использовать до восьми GPU (до 2,3 ТБ общей HBM-памяти), что позволяет строить масштабируемые серверы для обучения и инференса больших языковых моделей с высокой энергоэффективностью.
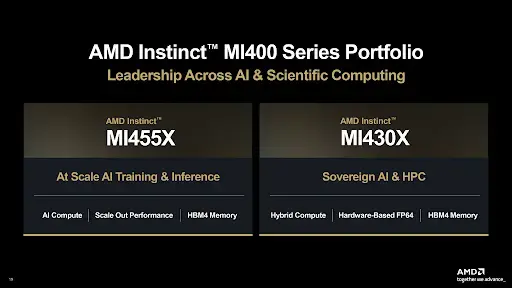
Компания планирует начать поставки ускорителей нового поколения Instinct MI400 (модели MI430X, MI440X и MI455X) на архитектуре CDNA 5, которые станут частью платформы Helios AI Rack Scale — это масштабируемая стоечная платформа для ИИ на базе открытых стандартов OCP (Open Compute Project). Позиционирование — обучение, инференс, reasoning больших языковых моделей и научные вычисления (с поддержкой настоящего FP64), а также HPC.
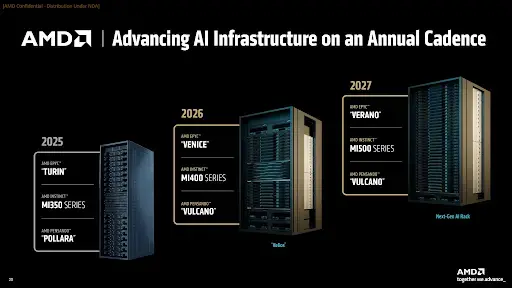
По заявлениям AMD, платформа Helios сможет объединять десятки ускорителей в единое вычислительное пространство и станет прямым конкурентом NVIDIA Vera Rubin. Новые GPU получат до 432 ГБ памяти HBM4, пропускную способность 19,6 ТБ/с, Infinity Fabric пятого поколения и одновременно открытый стандарт UALink (это локальная внутренняя шина для объединения соседних GPU). Пиковая производительность — до 40 FP4 PFLOPS, 20 FP8 PFLOPS и более 200 TFLOPS в нативном FP64.
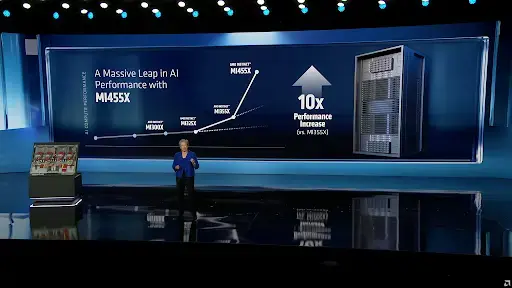
В поколении Instinct MI400 AMD прыгает выше головы — компания полностью перекраивает внутреннюю структуру чипа и подсистему памяти (для прямой конкуренции с NVIDIA Blackwell Ultra и Vera Rubin). Вместо прежней схемы компоновки MI400 использует два продвинутых активных интерпозера (AID, в прошлом поколении было четыре интерпозера по два вычислительных чиплета XCD) на базе новой технологии TSMC CoWoS-L (вместо старой CoWoS-S) с техпроцессом 2 нм. Теперь на каждом интерпозере размещается до четырёх вычислительных кристаллов — это позволило удвоить вычислительную плотность и спроектировать флагманский GPU MI455X на 320 миллиардов транзисторов.
Также AMD в этом поколении впервые внедряет MultiMedia IO Dies (MID) — это специализированные чиплеты ввода-вывода и мультимедиа-декодирования, которые забирают на себя обработку данных и разгружают вычислительные ядра.
Всего за пять поколений AMD прошла путь от классических ускорителей HPC до гибридных вычислительных систем с плотной интеграцией CPU и GPU. А благодаря открытой экосистеме ROCm 7, поддержке PyTorch, TensorFlow, vLLM, SGLang, DeepSpeed, Triton и llama.cpp, а также сотрудничеству с Microsoft, Meta, OpenAI и другими разработчиками ИИ AMD Instinct уже превратился из догоняющего решения в полноценную альтернативу NVIDIA на рынке дата-центров и ИИ-инфраструктуры.
Да, NVIDIA всё ещё сохраняет доминирующее положение на рынке серверных ИИ-ускорителей, но AMD заметно укрепила позиции в корпоративном инференсе, HPC и крупных ИИ-кластерах, а конкуренция вендоров всегда идёт на пользу нам — поставщикам, заказчикам и конечным потребителям.
Межпроцессорное взаимодействие AMD: интерконнекты Infinity Fabric, UALink и UEC
AMD использует проприетарный интерконнект — Infinity Fabric (IF) в нескольких поколениях, который связывает GPU, CPU, контроллеры памяти и другие компоненты системы с низкими задержками, высокой пропускной способностью и когерентностью. Это не просто шина (как часто пишут в определениях), а универсальный коммуникационный стек технологий, встроенный в архитектуру всех современных чипов компании — от консьюмерских Ryzen и видеокарт Radeon RX до серверных процессоров EPYC и ускорителей Instinct.
В сериях MI200 и MI250X Infinity Fabric (через интерфейс XGMI) обеспечивала связь между двумя GPU-кристаллами в одном модуле с двунаправленной пропускной способностью около 400 ГБ/с. В MI300 эта технология перешла на версию Infinity Fabric 3.0, которая соединяет CPU, GPU и подсистему ввода-вывода (I/O) внутри одного модуля, предлагая когерентный доступ к общей памяти и совокупную внутреннюю пропускную способность до нескольких терабайт в секунду (в зависимости от конфигурации).
В ускорителях серии Instinct MI350 AMD внедрила 4-е поколение Infinity Fabric, значительно улучшив как внутреннее взаимодействие между чиплетами (чипом ввода-вывода IOD aka I/O Die и вычислительными кристаллами XCD), так и соединения между GPU. Два кристалла IOD связаны между собой внутренним интерконнектом Infinity Fabric Advanced Package (AP) с внушительной двунаправленной скоростью до 5,5 ТБ/с. Важно, что это касается всех устройств серии. В половинчатой модификации Instinct MI350P (в стандартном форм-факторе PCIe-платы) каналы Infinity Fabric полностью отключили. А потому коммуникация между несколькими MI350P в одной системе идёт через стандартную шину PCIe 5.0 x16.
Ремарка! На уровне кластеров и ЦОДов Infinity Fabric не соединяет стойки. У AMD это реализуется стандартными сетевыми средствами: InfiniBand (через адаптеры от Mellanox / NVIDIA), Ethernet (RoCE, RDMA) или через специализированные DPU/SmartNIC, такие как AMD Pensando. Infinity Fabric в этом случае работает внутри каждого узла, а взаимодействие между узлами идёт поверх других протоколов, где когерентность обеспечивается уже на уровне программного обеспечения — ROCm 7, RCCL, MPI, UCX и других библиотек распределённых вычислений.
Но в поколении CDNA 5 и ускорителях Instinct MI400 AMD разделила технологию Infinity Fabric на внутреннюю логику чипа и внешние сетевые протоколы.
Раньше (MI350) были серьёзные физические ограничения: протокол xGMI (транспортный слой) позволял напрямую связывать по схеме Full Mesh («каждый с каждым») максимум восемь ускорителей в рамках одной платы (узла). Если нужно было больше, то приходилось использовать Ethernet, что создавало задержки.
Теперь вместо Infinity Fabric можно использовать открытый стандарт UALink, который увеличивает пропускную способность внешних линков (в рамках xGMI) до 300 ГБ/с (у MI350 было 153,6 ГБ/с) и позволяет масштабироваться до 72 GPU в рамках одной готовой ИИ-стойки AMD Helios или до 1024 GPU в рамках одного сверхпроизводительного пула (без выхода в общую сеть ЦОДа). Важно, что это концепция вертикального масштабирования (наращивание мощности узла), так как все GPU будут связаны на аппаратном уровне с когерентной памятью (доступна всем, все видят одно и то же). А процессор физически видит память любого другого ускорителя из этого пула как свою собственную и обращается к ней напрямую по физическому адресу. Для ПО этот гигантский пул тоже выглядит как один огромный виртуальный GPU.
Ремарка! AMD вместе с Broadcom, Cisco, Google, HPE, Intel, Meta, Microsoft и другими участниками консорциума UALink развивает открытый стандарт UALink (Ultra Accelerator Link). Он похож на NVLink — обеспечивает высокоскоростное когерентное взаимодействие между ИИ-ускорителями, — но без привязки к производителю. Цель UALink — дать возможность объединять ускорители разных вендоров в масштабируемые вычислительные системы с открытой архитектурой.
На уровне соединения стоек в ЦОДе AMD полностью переходит на Ultra Ethernet Consortium (UEC) — это сетевая технология для связи между независимыми серверами и стойками в ЦОД. Это концепция горизонтального масштабирования. Главная фишка UEC — это гипермасштабируемость вплоть до 1 000 000+ GPU в рамках одного ИИ-облака. Например, если ЦОДу нужно построить кластер на 100 000 GPU, то через UEC 1.0 можно объединить серверы (до восьми GPU в каждом), стойки Helios (до 72 GPU) или когерентные пулы (до 1024 GPU) — с предсказуемыми сверхнизкими задержками без потери пакетов (что раньше было эксклюзивным преимуществом InfiniBand).
Ремарка! Достигается это через технологию пакетного напыления (Packet Spraying). Если Ethernet гонит все данные по одному маршруту (из-за чего возникают заторы), то UEC умеет дробить одно сообщение на мелкие пакеты и веерно рассылать их по всем доступным путям в сети одновременно. На приёмнике (на DPU Pensando Vulcano) эти пакеты снова собираются, даже если они пришли не по порядку. Так что сетевая карта AMD Pensando Vulcano в такой сети не прихоть, а необходимость.
Внутри MI400 физическая Infinity Fabric использует архитектуру с гибким вводом-выводом. Если в старых поколениях AMD сделала архитектурную ошибку и намертво распаяла физические линии — одни только под PCIe, другие только под внутреннюю сеть, — то внутри новых чипов создали универсальный массив из линий ввода-вывода, которые могут динамически переключаться между протоколами в зависимости от нужд системы. Например, чип может использовать их как линии PCIe 6.0 для общения с процессором, переключить в режим наносекундной памяти UALink для связи со стойкой Helios или пустить напрямую в сетевой коммутатор ЦОДа в обход сторонних сетевых карт через протоколы вроде Infinity Fabric over Ethernet (IFoE).
Внутренняя логика способна маршрутизировать данные как классическая Infinity Fabric на скорости 64 Гбит/с на одну линию (в режиме NRZ), так и xGMI / UALink на скорости 128 Гбит/с. Или же трансформировать трафик в IFoE на рекордной скорости до 212 Гбит/с на одну линию благодаря передовому кодированию сигналов PAM4.
Если раньше Infinity Fabric решала практически все задачи обмена данными внутри ускорителей и серверов AMD, то с появлением MI400 архитектура стала многоуровневой. Infinity Fabric отвечает за связь компонентов внутри чипа и узла, UALink — за объединение больших когерентных пулов GPU, а Ultra Ethernet (UEC) — за масштабирование между стойками и целыми ИИ-кластерами. Такой подход позволяет AMD конкурировать с экосистемой NVIDIA не только на уровне отдельных ускорителей, но и на уровне всей ИИ-инфраструктуры.
Серверные платформы с чипами NVIDIA: MGX, HGX, DGX
Развитие современных ИИ-систем опирается на сквозной технологический стек NVIDIA. Высокая интеграция софта (CUDA, cuDNN, NCCL, TensorRT, стек NVIDIA AI Enterprise) и железа позволяет лидировать на рынке ИИ-ускорителей.
Пора поговорить про физическое воплощение этих технологий (то, что реально работает в ЦОДах) — про три ключевые серверные архитектуры: MGX, HGX и DGX.
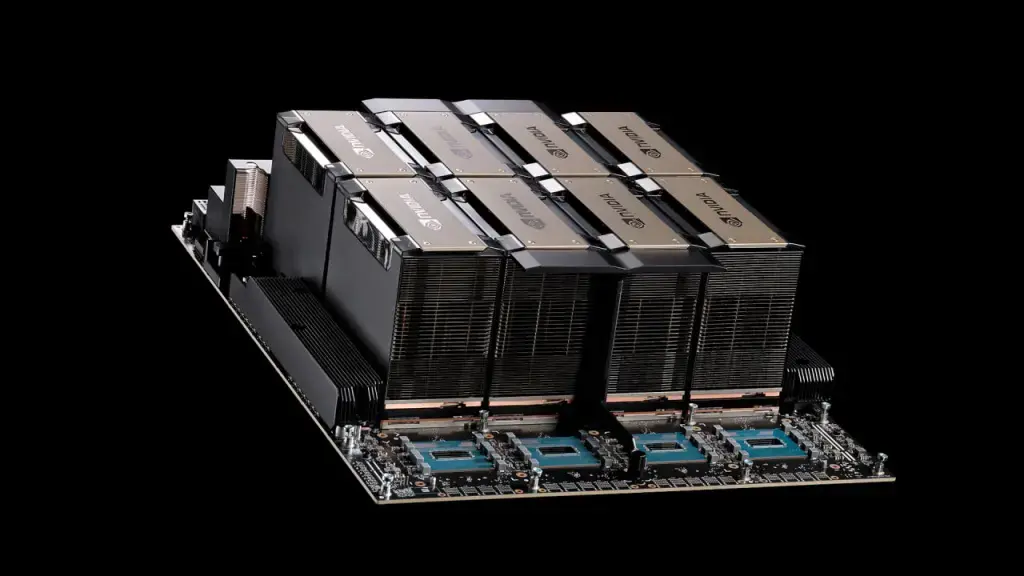
Модуль HGX
NVIDIA MGX — модульный стандарт для гибких систем
MGX — это открытая архитектура, позволяющая OEM-производителям оперативно собирать кастомные конфигурации под конкретные задачи и бюджет. Она поддерживает любые комбинации CPU (x86 или ARM, включая процессоры NVIDIA Grace и Vera), графических ускорителей (форм-факторы PCIe и SXM) и сетевых чипов DPU. Отличное решение для инференса и задач малого и среднего бизнеса.
Примеры:
-
HPE ProLiant DL380a Gen12 — универсальное решение, адаптируемое под 8 ускорителей NVIDIA H200 NVL или новейшие карты RTX PRO 6000 Blackwell Server Edition.
-
Dell PowerEdge XE7740 / XE7745 — решения на архитектуре MGX, оптимизированные под модули NVIDIA, включая мощные ускорители RTX 6000 Ada и Blackwell NVIDIA-Certified Systems.
NVIDIA HGX — суперкомпьютерные платы высокой плотности
HGX — это фиксированные высокопроизводительные базовые платы, на которые устанавливаются 4 или 8 мощных GPU-модулей в форм-факторе SXM. Графические процессоры объединены внутри шасси через чипы NVSwitch, что превращает сервер в единый вычислительный узел с огромной скоростью обмена данными памяти HBM. Архитектура создана для тяжёлого обучения LLM и HPC-задач.
Примеры:
-
Dell PowerEdge XE9680 (и жидкостный XE9680L) — флагманский 8U-сервер, несущий на борту до 8 ускорителей HGX H100/H200, с возможностью модернизации до Blackwell B200 / B100.
-
Dell PowerEdge XE9785 — это высокопроизводительный 10U-сервер с поддержкой до 8 ускорителей HGX B300 NVL8.
-
Lenovo ThinkSystem SR680a V3 — специализированная платформа высокой плотности для ИИ-инфраструктур, масштабируемая до 8 модулей NVIDIA H200 или Blackwell B200.
-
Supermicro SYS-822GS-NB3RT — готовое HGX-шасси на базе новейших модулей Blackwell Ultra (HGX B300 NVL8) и процессоров Intel Xeon 6-го поколения.
NVIDIA DGX — готовые Enterprise-суперкомпьютеры
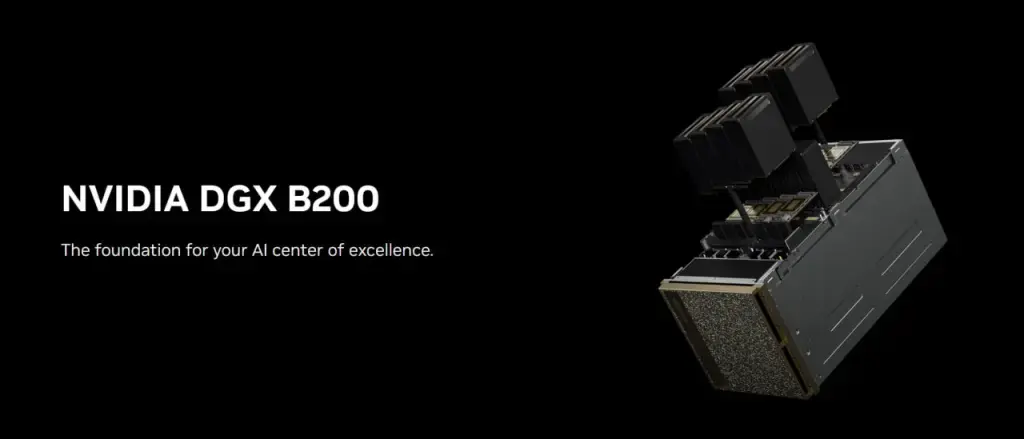
DGX — это закрытые, полностью укомплектованные программно-аппаратные комплексы, собираемые и поддерживаемые напрямую корпорацией NVIDIA. Это премиальный сегмент для создания ИИ-фабрик. Системы поставляются протестированными под ключ вместе с операционной системой DGX OS и полным DevOps-инструментарием.
Примеры (для наглядности приведу конкретные конфигурации, но возможны и другие варианты):
-
NVIDIA DGX Spark GB10 — компактная рабочая станция на базе суперчипа GB10 с 20 ядрами Arm (Cortex-X925 и Cortex-A725) и 128 ГБ объединённой памяти для локальной разработки мультиагентных систем и прототипирования ИИ.
-
NVIDIA DGX H100 — автономный сервер, оснащённый 8 ускорителями H100 SXM (640 ГБ суммарной VRAM), двумя процессорами Intel Xeon Platinum и 2 ТБ системной памяти DDR5 для масштабных распределённых ИИ-вычислений.
-
NVIDIA DGX A100 — сервер предыдущего поколения с 8 ускорителями A100, двумя CPU AMD EPYC 7742 и 2 ТБ памяти DDR4 для корпоративных ИИ-нагрузок и инференса.
-
NVIDIA DGX B200 — флагманский сервер нового поколения с 8 ускорителями B200 SXM, двумя Intel Xeon Platinum 8570 и 2 ТБ DDR5 для самых требовательных задач обучения больших языковых моделей.
-
MSI XpertStation WS300 DGX — рабочая станция на базе чипа GB300 с 72 ядрами Neoverse V2 и 496 ГБ памяти для локальной разработки, тонкой настройки и инференса мультиагентных систем.
-
NVIDIA DGX H200 — высокопроизводительный сервер с 8 ускорителями H200, двумя Intel Xeon Platinum 8480C и 2 ТБ DDR5, оптимизированный для работы с LLM и вычислительно интенсивных ИИ-задач.
-
NVIDIA DGX B300 — новейший сервер на базе 8 ускорителей B300 SXM, двух Intel Xeon 6776P и 2 ТБ DDR5, предназначенный для самых ресурсоёмких распределённых ИИ-вычислений и суперкомпьютерных кластеров.
Учитывайте, что высокая плотность вычислений (до 120 кВт на стойку) часто вынуждает использовать прямое жидкостное охлаждение (DLC), которое в этом сегменте становится базовым решением вместо воздушного.
Серверные платформы с чипами AMD: экосистема AMD Instinct
Все заметные OEM-производители (Dell, HPE, Lenovo, Supermicro) развивают линейки серверов и других платформ на базе ускорителей AMD Instinct. Такого же четкого деления на серии, как MGX, HGX и DGX, нет, но архитектурная сегментация и форм-фактор в целом схожи, что упрощает выбор клиентам и миграцию с NVIDIA на AMD и наоборот.

Серверные базовые платы и экосистема UBB (аналоги NVIDIA HGX)
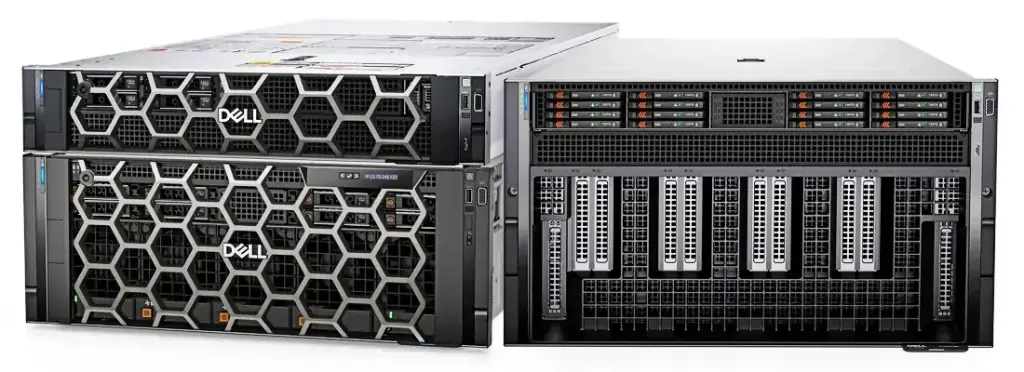
Это тяжёлая артиллерия для обучения больших языковых моделей (LLM). В аппаратной основе этих решений лежат модули AMD OAM (OCP Accelerator Module). AMD поставляет OEM-партнёрам готовые универсальные базовые платы стандарта UBB (Universal Baseboard), где 8 OAM-ускорителей жёстко объединены друг с другом через внутреннюю шину Infinity Fabric с огромной пропускной способностью.
Примеры серверов:
-
Dell PowerEdge XE9680 (и жидкостный XE9680L) — универсальный (работает и с NVIDIA) GPU-сервер высотой 6U для экстремальных нагрузок. Поддерживает до 8 ускорителей AMD Instinct MI300X/MI325X с объёмом HBM3-видеопамяти до 1,536 ТБ, 2 × Intel Xeon Platinum и до 4 ТБ памяти DDR5. Доступен в версиях с воздушным и продвинутым жидкостным (L) охлаждением для плотных инфраструктур.
-
Supermicro AS-8125GS-TNMR — высокоплотная 8U-система на платформе A+ (на базе CPU AMD EPYC) для интенсивных вычислений и обучения крупных нейросетей. Поддерживает до 8 ускорителей AMD Instinct MI300X, 2 мощных CPU AMD EPYC 9005/9004 и до 6 ТБ оперативной памяти стандарта DDR5.
-
Lenovo ThinkSystem SR685a V3 — это универсальный и высокопроизводительный стоечный ИИ-сервер высотой 8U, созданный на базе открытых стандартов для масштабного обучения генеративного ИИ и LLM-моделей. Поддерживает до 8 AMD Instinct MI300X, 2 мощных CPU AMD EPYC 9005/9004 и до 3 ТБ высокоскоростной памяти DDR5.
Модульные и гибридные системы (аналоги MGX)
Данный класс устройств ориентирован на гибкость конфигурации, инференс и специфические задачи на стыке классических вычислений (HPC) и нейросетей. Сюда входят серверы с уникальной APU-архитектурой и гибридным дизайном CPU+GPU.
-
Supermicro AS-2145GH-TNMR — революционная 4U-система на базе 4 гибридных процессоров AMD Instinct MI300A (APU). Архитектура MI300A объединяет ядра CPU Zen 4, GPU CDNA 3 и 128 ГБ сверхбыстрой памяти HBM3 на одной подложке с единым адресным пространством, а совокупная память доходит до 512 ГБ. Система ликвидирует задержки шины PCIe при переносе данных и оптимизирована для сложнейших конвергентных задач ИИ и научных вычислений (HPC).
-
GIGABYTE G383-R80-AAP1 — это компактный специализированный HPC/ИИ-сервер высотой 3U. Платформа поддерживает до 4 APU AMD Instinct MI300A.
Готовые ИИ-кластеры под ключ (аналоги DGX)
В отличие от NVIDIA, AMD не производит брендовые серверы самостоятельно. Вместо этого компания использует:
-
Концепцию AMD Validated Cluster Designs — вместо продажи готового железа AMD разрабатывает эталонные архитектуры, выпускает строгие инженерные чертежи, спецификации и программные утилиты для создания отказоустойчивых ИИ-кластеров на базе оборудования сертифицированных партнёров.
-
Модель открытой экосистемы AMD Data Center Partner Ecosystem — антипод закрытого подхода NVIDIA. AMD объединяет гигантов рынка, позволяя клиентам избегать жёсткой привязки к конкретному поставщику.
Например, AMD совместно с Supermicro или HPE поставляет полностью верифицированные программно-аппаратные стойки под ключ, вроде Supermicro AMD Helios — это сверхмощная готовая ИИ-стойка (rack-scale), разработанная Supermicro в тесном сотрудничестве с AMD на основе открытых спецификаций (ответ AMD и Supermicro на закрытые ИИ-системы NVIDIA, вроде GB200 NVL72).
Подбор конфигураций серверов с GPU для компаний разных размеров
Ниже я приведу приблизительные конфигурации серверов для различных сценариев использования GPU — от локального инференса и разработки ИИ-приложений до обучения больших языковых моделей (LLM) и построения корпоративных ИИ-кластеров.
Для примеров я буду использовать популярные серверы ведущих производителей (Dell Technologies, HPE, Lenovo, ASUS, Supermicro и др.), а также отечественные платформы с поддержкой современных ускорителей NVIDIA и AMD. Конечно, на рынке есть множество других решений, но приведённые ниже — самые востребованные из них, так как хорошо сбалансированы и предлагают отличное соотношение цены и качества.
Важно! Поскольку все задачи уникальны, подборка может не подойти конкретно вам. Поэтому все конфигурации ориентировочны — итоговое решение всегда зависит от модели ИИ, объёма данных, требований к производительности и бюджета. Иногда выгоднее установить четыре ускорителя среднего уровня вместо одного флагманского GPU или, наоборот, использовать платформу HGX вместо нескольких PCIe-карт.
Чтобы точно подобрать сервер с GPU, напишите нашим менеджерам в чат — они помогут согласовать спецификацию оборудования с бизнес-задачами и бюджетом. Платить за лишние или избыточные по производительности GPU — значит терять деньги.
При закупке GPU-сервера важно учитывать и форм-фактор ускорителей, иначе можно столкнуться с необходимостью полной замены сервера или ускорителей, что дорого в обоих случаях:
-
PCIe — классические ускорители, которые устанавливают в ПК и стандартные серверы в слоты PCIe. Хорошо подходят для инференса, компьютерного зрения, RAG, небольшого fine-tuning моделей (дообучения) и большинства корпоративных задач. Это идеальный и экономически выгодный выбор, если вам не нужны экстремальные вычислительные мощности, а инфраструктура компании — пара стандартных серверных стоек с воздушным охлаждением.
-
Фиксированные модули (SXM / OAM) — графические ускорители монтируются прямо на плату без стандартных слотов PCIe. Такой подход увеличивает производительность и пропускную способность системы. Несколько GPU внутри одного сервера становятся единой сверхбыстрой сетью с когерентным доступом к памяти. Такие решения выбирают, когда планируют обучение огромных LLM-моделей с нуля, масштабный распределённый инференс тяжёлых нейросетей или построение мощных корпоративных ИИ-кластеров. Чаще всего требуется жидкостное охлаждение.
В экосистеме NVIDIA есть проприетарные модули SXM, монтируемые на платы HGX или DGX с объединением через коммутаторы NVSwitch по шине NVLink. Компания AMD реализует аналогичную концепцию, но на базе открытого индустриального стандарта: модули OAM (например, в чипах MI300A и MI300X) монтируются на универсальные платы UBB и связываются между собой через внутреннюю шину Infinity Fabric. Оба решения выполняют одну задачу — разница лишь в физическом формате разъёмов и типе используемой сетевой архитектуры конкретного производителя.
| Уровень | Задачи | Примеры серверов |
|---|---|---|
| Базовый (1 GPU) | Локальный инференс Llama, DeepSeek, Qwen, разработка ИИ-приложений, RAG, компьютерное зрение. |
Dell PowerEdge R750 8SFF (2 × Intel Xeon Silver 4310, 64 ГБ DDR4, до 8 × 2,5″ SFF, 1 × NVIDIA A10); Dell PowerEdge R750 12LFF (2 × Intel Xeon Gold 5315Y, 256 ГБ DDR4, до 12 × 3,5″ LFF, 1 × NVIDIA A30); HPE ProLiant DL385 Gen11 12LFF (1 × AMD EPYC 9654, 64 ГБ DDR5, до 12 × 3,5″ LFF, 1 × NVIDIA A100 40 ГБ); ASUS ESC N8-E11 10SFF (2 × Intel Xeon Gold 6442Y, 1 ТБ DDR5, до 8 × NVMe + 2 × SATA, 1 × NVIDIA HGX H100). Отечественные аналоги: OpenYard HN203I (до 4 GPU, но конфигурация на 1; 2 × Intel Xeon 6, до 8 ТБ DDR5, до 320 ТБ NVMe, поддержка NVIDIA H100 или специализированных L40/L40S/L4). Новые модели: Dell PowerEdge R770 (2 × Intel Xeon 6, до 32 слотов TruDDR5, диски SAS/SATA/EDSFF, контроллеры PERC H965i; поддерживает до 2 двухслотовых ускорителей NVIDIA H200 NVL с ограничением мощности до 450 Вт / H100 NVL / L40S / A16 / RTX PRO 6000 с ограничением мощности до 450 Вт, а также до 6 однослотовых NVIDIA L4); HPE ProLiant DL380 Gen12 (2 × Intel Xeon 6, до 32 слотов DDR5 DIMM и до 8 ТБ RAM, накопители EDSFF/SFF, управление iLO 7; поддерживает до 3 двухслотовых NVIDIA H200 NVL / L40S / RTX PRO 6000 Blackwell Server Edition / RTX PRO 4500 Blackwell Server Edition / RTX 6000D, а также до 8 однослотовых NVIDIA L4 / RTX A1000); Lenovo ThinkSystem SR650 V3 (до 2 процессоров Intel Xeon Scalable 4-го или 5-го поколения, до 32 слотов DDR5, до 40 накопителей SFF; поддерживает до 3 NVIDIA H100 / H100 NVL / H800 / L40 / L40S / A100 / A40 / A30 / A16 / A800 / RTX 6000 Ada / RTX A6000 / RTX A4500 / AMD Instinct MI210, до 4 NVIDIA RTX A2000, а также до 8 NVIDIA L4 / A2 / T1000 / T400 / RTX A1000 / RTX A400); ASUS ESC4000-E11 (2 × Intel Xeon Scalable 4-го или 5-го поколения, до 8 × NVMe/SATA/SAS; поддерживает до 4 двухслотовых NVIDIA H100 NVL / H100 / L40S / A100 / A40 / RTX 6000 Ada / RTX A6000 / RTX A5000 / AMD Instinct MI210 / MI100 или до 8 однослотовых NVIDIA L4 / A2 / T4). |
| Средний (2–4 GPU) | Дообучение моделей до десятков миллиардов параметров, корпоративный ИИ, многопользовательский инференс. |
Dell PowerEdge R760xa (конфигурируется до 4 GPU, например с NVIDIA A100/H100); HPE ProLiant DL384 Gen12 (NVIDIA GH200 NVL); ASUS ESC N8-E11 (до 4 GPU NVIDIA H100); HPE ProLiant DL380a Gen12 (2 × Intel Xeon 6710E, 64 ГБ DDR5, до 8 × SFF/EDSFF, NVIDIA H200 NVL). Отечественные аналоги: YADRO G4208P G3 (конфигурируется до 4 GPU A100/H100/H200 NVL и других ускорителей, 2 × Intel Xeon Scalable 4-го или 5-го поколения, до 8 ТБ DDR5 ECC, PCIe 5.0). Новые модели: Dell PowerEdge R760xa (двухпроцессорная платформа с поддержкой до 4 двухслотовых NVIDIA H100 NVL / H100 / L40S / L40 / A100 / A40 / A30 / RTX 6000 Ada / AMD Instinct MI210 / Intel Data Center GPU Flex 170, до 8 однослотовых NVIDIA RTX A4000 / AMD FirePro, а также до 12 однослотовых NVIDIA L4 / A2 / T4 / Intel Data Center GPU Flex 140); HPE ProLiant Compute DL385 Gen11 (2 × AMD EPYC 4-го поколения, до 6 ТБ DDR5; поддерживает до 4 двухслотовых NVIDIA H200 NVL / H100 NVL / H100 / L40S / L40 / A100 / A16 / A40 / RTX PRO 6000 Blackwell / RTX 6000 Ada / RTX A6000 / RTX A4500, а также до 8 однослотовых NVIDIA L4 / A2 / T4); Lenovo ThinkSystem SR665 V3 (двухпроцессорная платформа на AMD EPYC 4-го поколения, до 32 слотов DDR5, плотная компоновка PCIe для ИИ-задач; поддерживает до 3 двухслотовых NVIDIA H100 / H100 NVL / H800 / L40 / L40S / A100 / A40 / A30 / A16 / A800 / RTX 6000 Ada / RTX A6000 / RTX A4500 / AMD Instinct MI210, до 4 NVIDIA RTX A2000, а также до 8 однослотовых NVIDIA L4 / A2 / T1000 / T400 / RTX A1000 / RTX A400). |
| Высокопроизводительный (8 GPU) | Обучение LLM, HPC, корпоративные ИИ-кластеры. |
Supermicro SYS-420GP-TNAR+ 6SFF (2 × Intel Xeon Silver 4310, 256 ГБ DDR4, до 6 × NVMe/SAS, 8 × NVIDIA A100 80 ГБ); Dell EMC PowerEdge XE9680 8SFF (2 × Intel Xeon Platinum 8468, 2 ТБ DDR5, до 8 × NVMe, 8 × NVIDIA HGX H200 141 ГБ); NVIDIA DGX H800 640 ГБ (2 × Intel Xeon Platinum 8480C, 2 ТБ DDR5, 8 × 3,84 ТБ NVMe, 8 × NVIDIA H100 с суммарной памятью 640 ГБ). Новые модели: Dell PowerEdge XE9680L (поддерживает монолитные ИИ-модули: до 8 NVIDIA HGX B200 180 ГБ 1000 Вт SXM6 или до 8 NVIDIA HGX H200 141 ГБ 700 Вт SXM5, полностью объединённых по технологии NVLink, либо AMD Instinct MI300X или Intel Gaudi 3 OAM — в зависимости от заводской спецификации); ASUS ESC8000-E12 / E12P (массивные вычислительные узлы 4U/6U с резервными блоками питания мощностью 3000 Вт; поддерживают установку до 8 двухслотовых ускорителей мощностью до 600 Вт каждый: NVIDIA H200 NVL / H100 NVL / H100 / L40S / A100 / RTX PRO 6000 Blackwell Server Edition / RTX PRO 4500 Blackwell Server Edition / RTX 6000 Ada / RTX A6000 / AMD Instinct MI210 / Intel Gaudi 3 PCIe, а также до 8 однослотовых NVIDIA L4 / A2 / T4); Supermicro SYS-A21GE-NBRT (ИИ-платформа на базе процессоров Intel Xeon Scalable 4-го или 5-го поколения, спроектированная для интеграции до 8 NVIDIA HGX B200 в форм-факторе SXM5/SXM6 со 180 ГБ HBM3e на единой подложке с полноразмерным интерконнектом NVLink); Supermicro SYS-822GS-NB3RT HGX (топовая фабрика искусственного интеллекта на базе 8 NVIDIA HGX B300 с архитектурой Blackwell Ultra SXM и 288 ГБ HBM3e на единой плате-подложке с полноразмерным межчиповым интерконнектом NVLink пятого поколения); Dell PowerEdge XE9785 / Dell PowerEdge XE9780 / NVIDIA DGX B300 (топовые фабрики искусственного интеллекта на базе 8 × NVIDIA B300 SXM). |
| ИИ-фабрики (Rack Scale) | Обучение фундаментальных моделей, агентный ИИ, гиперскейлеры. | NVIDIA GB300 NVL72, AMD Helios AI Rack Scale (MI400). Используются для построения ИИ-фабрик и крупнейших корпоративных кластеров, объединяя десятки ускорителей в рамках одной стойки. |
Другие отечественные производители (OpenYard, YADRO, «Гравитон», QTECH, «Тринити», KARMA и другие) тоже поставляют серверы с поддержкой современных ускорителей NVIDIA и AMD, а также новейших Intel Xeon 6 и AMD EPYC Turin.
В каждом сервере и категории из таблицы выше возможны конфигурации под задачу и бюджет: большинство серверов позволяют менять GPU в рамках одного вендора и списка поддерживаемых ускорителей, поэтому выбирать между NVIDIA SXM и AMD OAM нужно на этапе закупки — потом заменить один формат на другой не получится. А вот с PCIe GPU всё проще — заменить карту на другую немногим сложнее, чем в домашнем ПК.
И не списывайте со счетов и прошлые поколения GPU
Переход NVIDIA и AMD на Blackwell, Rubin, MI350 и MI400 не означает, что ускорители прошлых поколений потеряли актуальность. Наоборот, благодаря появлению новых флагманов цены на H100, H200, A100, A30, L40S, L4 и MI300X постепенно снижаются, поэтому многие компании могут получить доступ к мощным GPU по адекватным ценам.
Эти решения подходят, если вы занимаетесь инференсом современных LLM размером до нескольких десятков миллиардов параметров, RAG-системами и корпоративными ИИ-ассистентами, компьютерным зрением, рекомендательными системами, дообучением небольших и средних моделей, научными вычислениями и даже HPC на уровне прошлых поколений.
Будущее ИИ-серверов
В целом будущее за комбинированными вычислительными платформами. Это позволит решать новые задачи ИИ быстрее и дешевле. Для закупщиков же важно наблюдать за этими трендами и вовремя адаптировать инфраструктуру под бизнес-задачи. В мире ИИ новые технологии и архитектуры выходят каждые 1–2 года.
Спасибо, что дочитали лонгрид до конца! В нашем каталоге вы найдёте серверы с поддержкой профессиональных GPU для любых задач — от лабораторных тестов и инференса небольших моделей до тренировки крупных LLM. Можно подобрать конфигурацию под один GPU или собрать высокоплотный узел с ускорителями NVIDIA или AMD.
Подберём решение под ваши задачи. Выездная гарантия до 5 лет, бесплатная доставка по всей России и коммерческое предложение за час (или быстрее).