Выбор процессора (CPU) влияет как на стоимость отдельно взятого сервера (и десятки других параметров, включая производительность), так и на стоимость косвенных нагрузок и инфраструктуры вокруг него. Если влияние консьюмерского процессора редко распространяется на другие устройства, то в серверном сегменте всё иначе — там компоненты тесно взаимосвязаны и работают над рабочими задачами сообща в единой IT-инфраструктуре (кластеры, хранилища, сеть, виртуализация и оркестрация, контуры киберзащиты и т.д.).
В этой статье я расскажу о том, как серверный процессор влияет на стоимость виртуализации и хранения данных в ЦОДе (центре обработки данных aka дата-центре). После прочтения вы будете точно знать, почему не столь важна цена CPU, сколько единица полезной нагрузки, которую можно получить на его базе.
от 33 754 500 ₽
1 172 969 ₽/мес в лизинг
от 27 667 623 ₽
+ 6 086 877 НДС
от 33 105 375 ₽
1 150 412 ₽/мес в лизинг
от 27 135 553 ₽
+ 5 969 822 НДС

от 17 580 469 ₽
610 921 ₽/мес в лизинг
от 14 410 220 ₽
+ 3 170 248 НДС
от 31 182 712 ₽
1 083 599 ₽/мес в лизинг
от 25 559 600 ₽
+ 5 623 112 НДС
CPU, виртуализация и хранилище — как они связаны и как это влияет на стоимость IT-инфраструктуры
Начнём с виртуализации и базовых понятий.
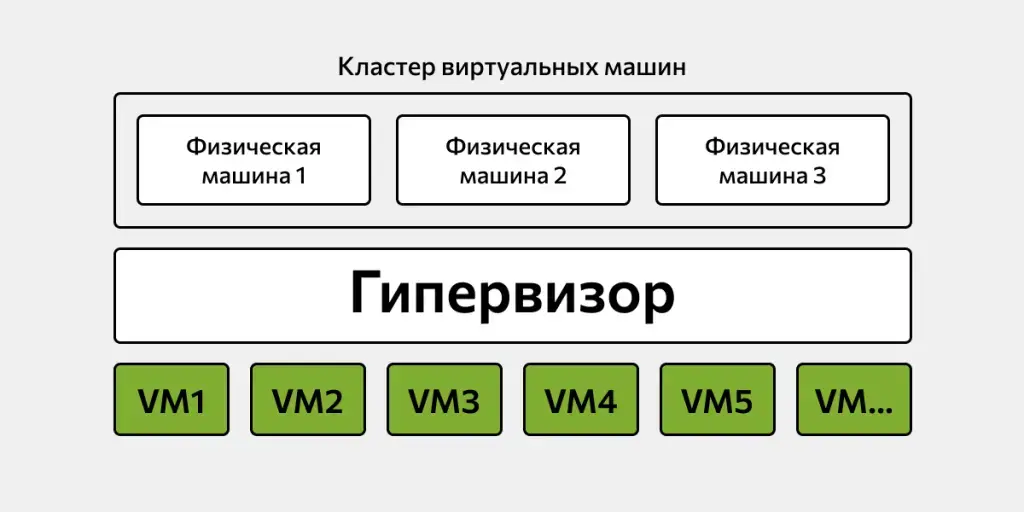
Виртуализация позволяет представить физические ресурсы сервера (процессор, память, хранилище, сеть) в виде программных абстракций с помощью специальной операционной системы — гипервизора (например, VMware ESXi, KVM или Hyper-V).
Ремарка! Гипервизоры в классическом понимании бывают двух типов: первый тип (Bare-Metal) работает напрямую на физическом оборудовании, а второй тип (Hosted) устанавливают поверх обычной операционной системы. В современной IT-индустрии есть понятие гибридного (третьего типа) гипервизора — это виртуализация, встроенная в ядро операционной системы (например, KVM).
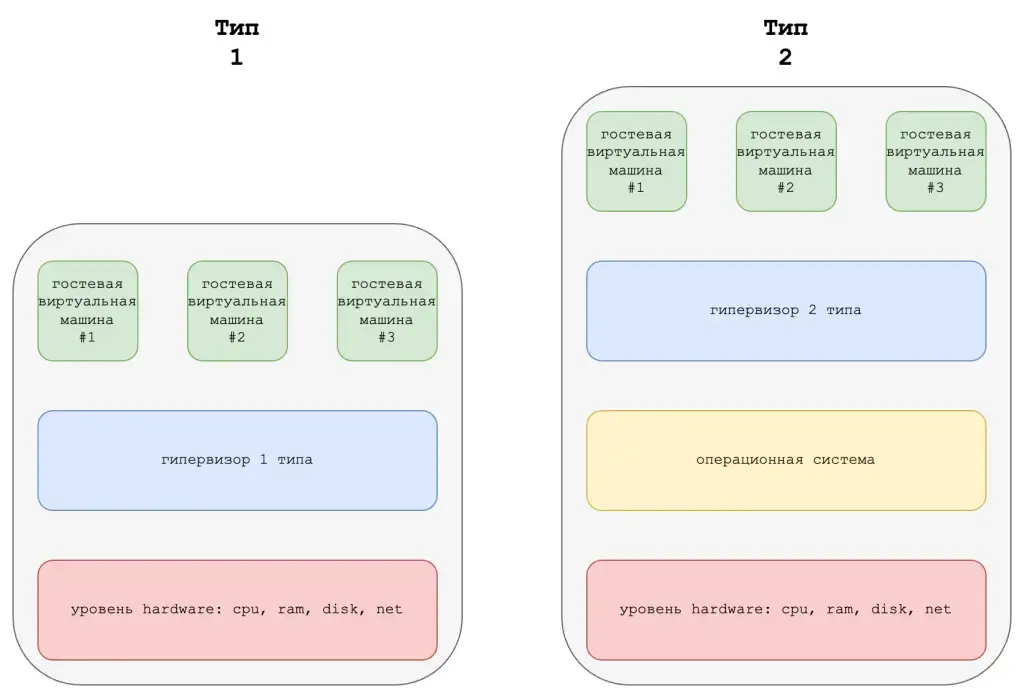
Далее эти виртуализированные (абстрактные) ресурсы можно распределять по виртуальным машинам (ВМ) aka виртуалкам. Гипервизор может разделить один сервер (хост) на несколько независимых операционных систем и приложений (ВМ).
Отсюда можно предположить, что чем больше у серверного процессора (на хосте) физических ядер и потоков (логических ядер, с помощью которых ядро обрабатывает два потока данных одновременно), тем больше виртуальных процессоров (vCPU) гипервизор сможет выделить каждой ВМ.
![[svfjfop[d.png](/upload/resize_cache/format_converted/8d2cc8fe321fece908457b41c734f089.webp "[svfjfop[d.png")
Ремарка! В простейших случаях 1 vCPU в настройках виртуалки равен 1 логическому потоку (потоку SMT/HT) на физическом сервере (в зависимости от гипервизора, конфигурации и режима планирования связь может быть не такой прямой).
Важно, что два логических потока на одном физическом ядре не делают из него два полноценных ядра. Они просто повышают утилизацию ядер (эффективнее загружают их), но насколько именно — зависит от нагрузки.
Приведу упрощенный, но очень наглядный пример. Из процессора на 96 ядер можно нарезать 192 виртуалки, которые будут иметь по 1 vCPU (можно сделать меньше ВМ с большим количеством vCPU). Но ведь в реальных офисных нагрузках виртуалки не нагружены на 100% одновременно, так? Кто-то пошел на обед, кто-то заболел, кто-то на совещании, а кто-то листает новости вместо работы. То есть часть мощностей сервера будет простаивать.
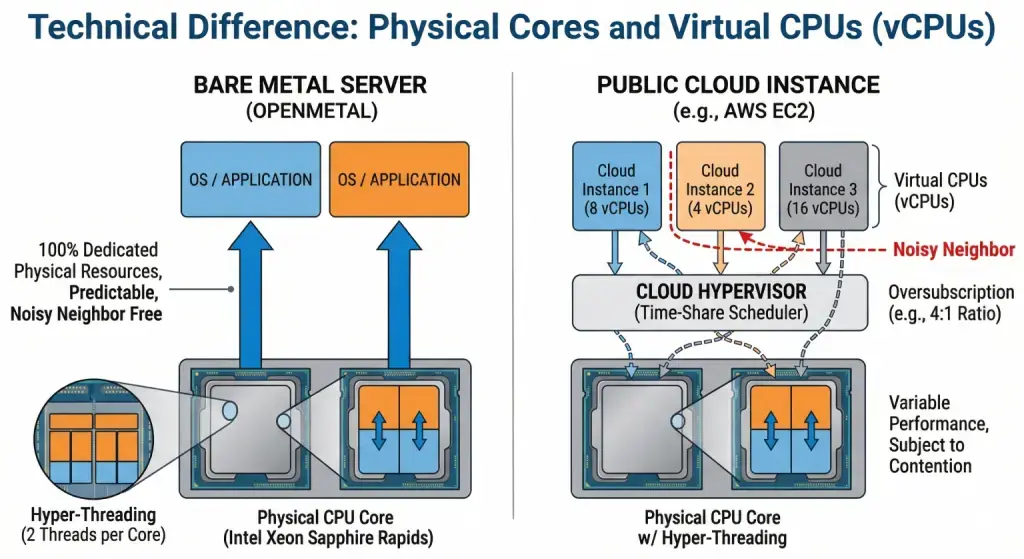
Чтобы решить эту проблему, гипервизор умеет отдавать виртуальным машинам больше vCPU (полезнейший механизм переподписки в правильных руках, но которым злоупотребляют недобросовестные провайдеры), чем у него физически есть потоков.
Например, если у нас есть CPU с 96 ядрами 192 потоками, то мы можем нарезать 384 vCPU (получится коэффициент переподписки 2:1) или даже 768 vCPU (коэффициент 4:1) для нетребовательных офисных задач. И да, вы правильно поняли, что из процессора подешевле, например на 32 ядра и 64 потока, можно сделать те же 192 виртуалки с коэффициентом переподписки 3:1.
Ремарка! Виртуалок может быть сколько угодно с любыми коэффициентами переподписки, но из-за налога на виртуализацию часть мощностей сервера (время CPU, память, хранилище, ввод/вывод) уходит под нужды самого гипервизора. В идеальном мире не стоит давать ВМ больше vCPU, чем ей нужно на самом деле. В реальном же нужно стремиться к этому идеалу.
Для обычной корпоративной среды коэффициент 2:1 или 3:1 — нормальная отправная точка, хотя это не норматив и не гарантия. Учтите, что базы данных, аналитика, VDI и требовательные к CPU приложения требуют совершенно других расчетов vCPU на каждую ВМ.
Тем, как реальные задачи от разных виртуалок будут распределяться по свободным физическим ядрам/потокам CPU, занимается планировщик гипервизора, которому неплохо бы иметь пространство для маневра (запас производительности хоста в 20–30%). Если мощности процессора хватает, то всё будет работать отлично. Если рассчитаете неправильно, то либо мощности дорогого процессора будут простаивать, либо начнётся деградация и виртуальные машины будут лагать.
Пример! Представьте виртуалку с 16 vCPU, которой внезапно понадобилась вся выделенная ей вычислительная мощность. А рядом с ней ещё сотня мелких виртуалок. Гипервизору приходится планировать работу большого количества vCPU на доступных потоках хоста. Чем выше конкуренция между ВМ, тем сложнее быстро предоставить ей нужную вычислительную мощность.
Отмечу, что это касается и памяти, и хранилища, и сети у ВМ. Нередки сценарии, когда память у сервера закончилась, а процессор работает вполсилы — или наоборот. Можно поставить в сервер 2 × CPU с огромным количеством ядер, но упереться в линии PCIe, пропускную способность сетевой карты или задержки системы хранения данных (СХД).
Поэтому 192 vCPU на сервере с 96 физическими ядрами и 192 vCPU на сервере с 32 ядрами — это абсолютно разные среды.
Важно! Ядра ядрам рознь. Количество ядер — 32, 96 или сколько угодно — сами по себе не гарантируют линейного роста производительности, поскольку их реальная эффективность в виртуализации зависит от комплекса характеристик. Скорость работы одного ядра определяется и микроархитектурой, и частотой, и доставкой данных. Критичен объём L3-кэша, пропускная способность памяти, количество каналов и топология NUMA, которая при неправильной настройке может резко увеличить задержки. Также архиважны плотность линий PCIe, поддержка технологий SMT (Simultaneous Multithreading) и аппаратной виртуализации, энергопотребление и банальное ограничение на объем памяти. Поэтому выбирать CPU нужно не по количеству ядер или частоте, а по совокупности всех параметров — и строго под задачу.
И здесь мы получаем парадокс. Дорогой многоядерный CPU за 5000 долларов может сильно уменьшить стоимость виртуализированной IT-инфраструктуры (так как позволит убрать из ЦОДа два сервера по 5000 долларов), но совсем не обязательно сделает это — если этот дорогой 96-ядерный CPU будет загружен на 30%, а два относительно дешёвых 32-ядерных процессора на 70–80%, то первый не имеет смысла. Да, иногда многоядер просто стоят без дела, кушают электричество, дешевеют со временем, да ещё и лицензионные платежи увеличивают.
Как я и сказал в самом начале, серверный CPU в ЦОДе (да и любой другой IT-инфраструктуре) влияет на десятки и сотни параметров во всей IT-инфраструктуре.
Приведу 5 примеров, когда влияние CPU на виртуализацию и хранение данных критично:
-
Аппаратные возможности и масштабируемость. CPU определяет максимальный объём, скорость и канальность памяти, а они — плотность размещения виртуальных машин (ВМ). Количество линий PCIe ограничивает подключение скоростных NVMe-накопителей и сетевых карт (100/200 Гбит/c) для NVMe-oF, а ядра и потоки — лимиты vCPU.
-
Производительность и тип нагрузок. CPU напрямую влияет на отзывчивость СУБД в ВМ. Его производительность определяет скорость дедупликации, сжатия и шифрования данных на лету в программно-определяемых хранилищах (SDS), а также эффективность распределения ресурсов между ВМ при пиковых нагрузках.
-
Совокупная стоимость владения (TCO, Total Cost of Ownership). Прямое влияние на энергопотребление и охлаждение серверов виртуализации и узлов хранения. К тому же проприетарное корпоративное ПО (вроде гипервизора VMware vSphere) часто лицензируется по количеству сокетов и/или ядер, а значит может быть важна максимальная производительность на один поток.
-
Безопасность и надёжность. Аппаратные технологии (Intel SGX, AMD SEV) из серверных CPU критичны для виртуализированных вычислений (особенно в облаке), они защищают память ВМ от компрометации со стороны гипервизора. А аппаратное ускорение криптографии защищает данные ВМ как при передаче по сети, так и при хранении на локальных накопителях.
-
Поколение платформ и сопутствующих технологий. Процессор определяет поколение и архитектуру серверной платформы (или наоборот — дилемма курицы и яйца) и всех сопутствующих технологий, вроде шины PCIe, памяти DDR и накопителей NVMe. Новые поколения кардинально увеличивают пропускную способность виртуальных коммутаторов и скорость работы дисковых подсистем, что особенно важно при частом обращении виртуалок к централизованному хранилищу.
Краткий подытог. Для виртуализации нужно покупать CPU не с максимальным количеством ядер, а решение с оптимальным соотношением вычислительной плотности, памяти, возможностей ввода/вывода, стоимости лицензий и самого серверного хоста/платформы.
А теперь подробнее расскажу, как связаны CPU и хранение данных в контексте виртуализации.

Как мощный CPU и сервер могут усложнить хранилище и сделать его неочевидно дороже
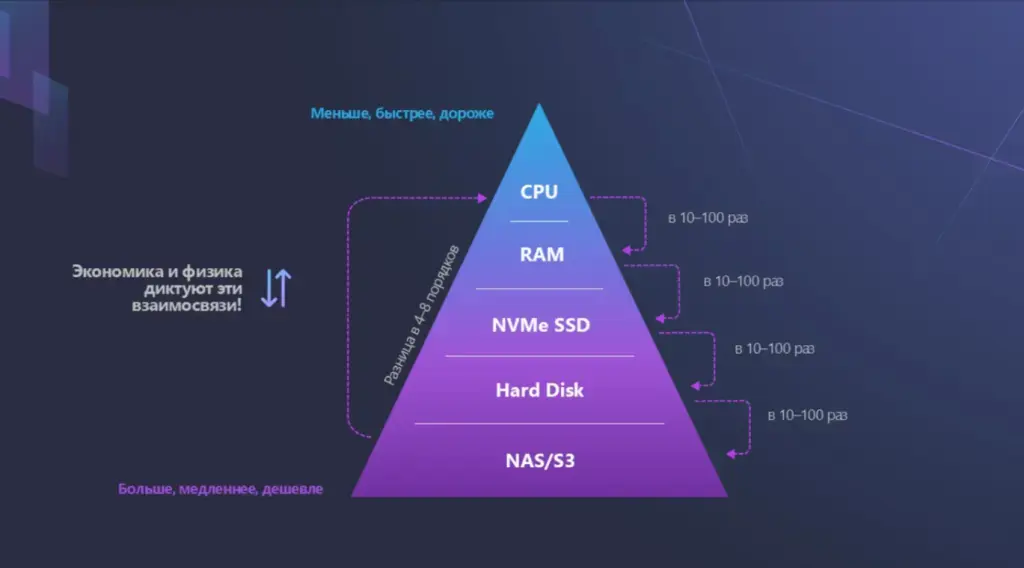
Производительный современный CPU может задавать минимальные требования к железу и ПО, но напрямую не сделает дороже ни подсистему хранения данных в самом сервере-хосте (локальные HDD или SSD), ни внешний СХД, ни SDS, ни HCI (Hyperconverged Infrastructure — гиперконвергентная инфраструктура).
Зато косвенно — легко. Так как CPU позволяет развернуть больше ВМ на одном физическом узле и плотнее упаковать их, то нагрузка самих виртуалок уже меняет требования, например, к хранилищу (любому — локальному, DAS, NAS и SAN), потому что этому узлу придётся работать с бóльшим количеством операций ввода-вывода. Сюда же ширина канала, сетевая инфраструктура L2/L3, системы охлаждения, различные требования к архитектуре высокой доступности (HA, High Availability) и планам катастрофоустойчивости (DRP, Disaster Recovery Plan) — по цепочке усложняется и дорожает почти всё.
Ремарка! И если идти от обратного, то хранилище (и т.д.) может ограничить производительный CPU: принцип «больше ядер — больше виртуалок» будет работать, пока хватает остальных ресурсов.
С локальным хранилищем у сервера будет больше операций ввода-вывода (на накопители) и выше требования к PCIe. Например, у AMD EPYC 9655 аж 128 линий PCIe 5.0, а у его конкурента Xeon 6980P — 96. Это определяет возможные конфигурации из NVMe, сетевых адаптеров и других дискретных устройств. Кстати, поэтому процессоры подороже и позволяют уменьшить количество серверов, хотя стоимость платформы под такой CPU — выше.
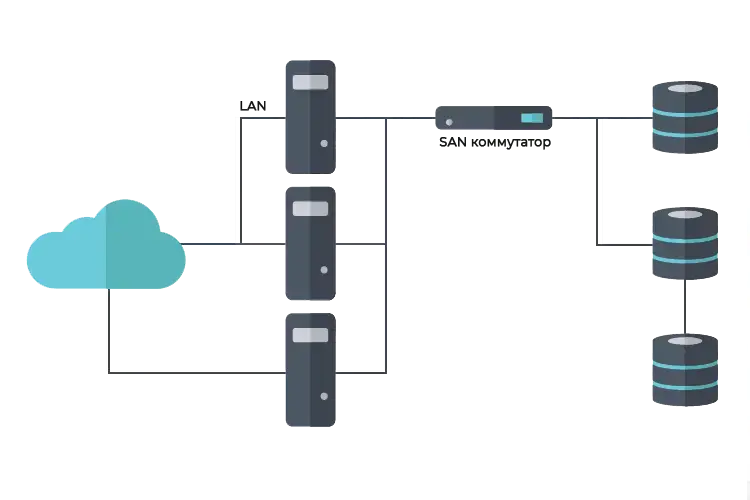
Отмечу, что в корпоративных средах редко (почти никогда) работают с виртуализацией на локальных накопителях (DAS или накопитель внутри сервера). В классической схеме вычислительные узлы и хранение данных разделяют (вычисления + SAN + хранилище). Но когда мы выносим хранилище, узким местом становится транспортная сеть хранения данных — будет больше трафика из-за постоянного обращения хоста к СХД, а потому нагрузка на HBA (Host Bus Adapter) или Ethernet-адаптеры тоже вырастет.
Пример! Для надёжности внешние СХД всегда подключают по нескольким путям (Multipathing / MPIO). Адаптерам сервера приходится постоянно опрашивать эти пути, балансировать нагрузку и обрабатывать переключения (failover). Если это кластер гипервизоров (например, VMware vSphere или Proxmox VE), то через те же или соседние адаптеры идёт постоянный служебный трафик распределённой файловой системы (блокировки VMFS, heartbeat). Задачи довольно требовательные.
Поэтому в современных корпоративных средах с виртуализацией в вычислительные узлы чуть ли не по умолчанию ставят двухпортовые HBA на 32/64 Гбит/c FC или сетевые карты 25/100 Гбит/c Ethernet с обязательной поддержкой технологий разгрузки процессора (RDMA / RoCE).
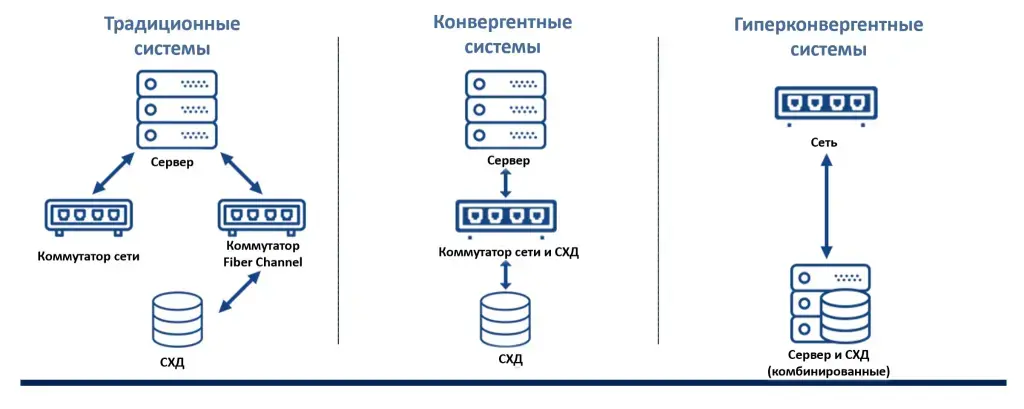
Для SDS и HCI история еще сложнее. Во-первых, там программные хранилища конкурируют с ВМ за ресурсы. В том же Ceph (opensource SDS) различные процессы (особенно OSD — демоны дисков) активно кушают ресурсы процессора и оперативную память для репликации, сжатия данных, подсчета контрольных сумм и очистки. Поэтому при проектировании HCI-систем всегда закладывают неприкасаемый резерв по CPU и памяти под накладные расходы, который запрещено отдавать виртуалкам — с ним работает только SDS. Иначе прожорливая база данных в ВМ могла бы перетянуть одеяло на себя.
Во-вторых, схема разделения вычислений и хранения реализуется не дорогим аппаратным СХД, а с помощью ПО и локальных накопителей в серверах. Мы экономим на покупке внешней хранилки, но требования к конфигурации самого сервера (подсистема хранения, выносливость и скорость накопителей, шина PCIe, частота CPU для обслуживания OSD, объём памяти) стремятся к максимуму. С одной стороны SDS и HCI — это революция, с другой — сложно-дорого-непонятно. Нужны серьёзные компетенции и опыт.
Наглядные расчёты совокупной стоимости владения (TCO)
Представим два кластера — на одном HDD кручёные, на другом SSD печёные.
В первом 20 средних серверов, во втором — 5 флагманов. Количество ВМ одинаковое — пусть будет 400 штук, которым нужно 800 ТБ хранилища.
Если у компании есть внешняя СХД, то физическая ёмкость массива от процессора не изменится. Те же 800 ТБ логического пространства потребуются независимо от того, выполняются 400 ВМ на 18 хостах или на 6.
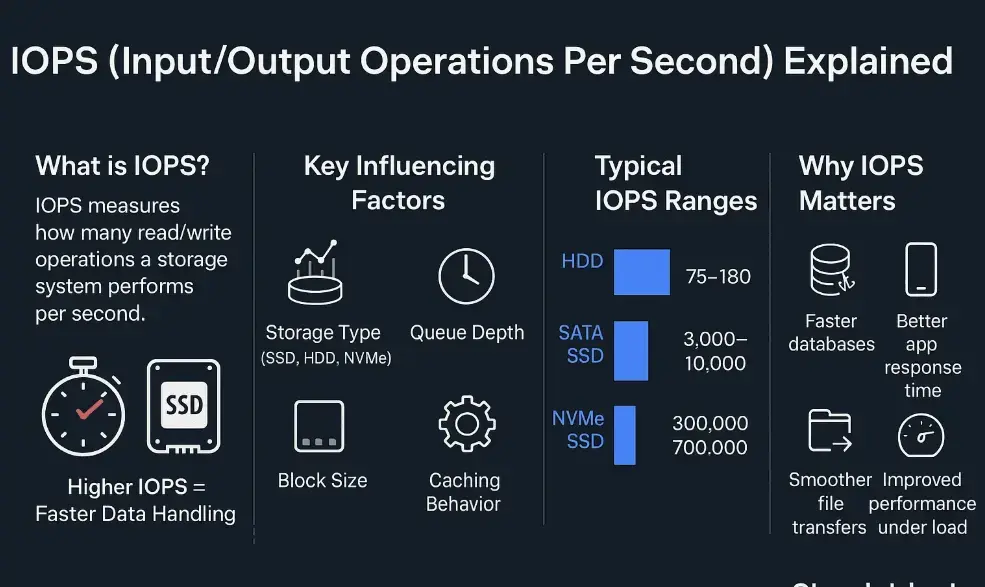
Но нагрузка на каждый хост будет разной. Допустим 400 ВМ генерируют суммарно 100 тысяч IOPS.
Ремарка!
IOPS (Input/Output Operations Per Second) — это количество операций ввода-вывода, которое дисковая система или накопитель (HDD, SSD) успевает выполнить за одну секунду. Это не объём переданных данных (мегабиты в секунду), а именно число отдельных запросов, с которыми накопитель справляется ежесекундно. Высокие IOPS критически важны для систем, где происходит много мелких обращений к диску: баз данных (PostgreSQL, MySQL), виртуальных машин и операционных систем.
IOPS — один из главных показателей производительности СХД и отдельных накопителей.
При 20 хостах будет около 5 тысяч IOPS на сервер, а при 5 хостах — 20 тысяч IOPS. И аналогично с требованиями по пропускной способности.
Вывод простой: более мощный CPU уменьшает число хостов, но и увеличивает требования к каждому оставшемуся серверу по хранилищу и сети. Если вы уберёте половину серверов, то могут понадобиться дополнительные NVMe, сетевые платы на 100 Гбит/c вместо 25 Гбит/с, больше памяти (что критично), более продвинутая система охлаждения и т.д.
от 160 000 ₽
5 560 ₽/мес в лизинг
от 131 148 ₽
+ 28 852 НДС
от 205 850 ₽
7 153 ₽/мес в лизинг
от 168 730 ₽
+ 37 120 НДС
от 160 000 ₽
5 560 ₽/мес в лизинг
от 131 148 ₽
+ 28 852 НДС
от 2 939 467 ₽
102 146 ₽/мес в лизинг
от 2 409 399 ₽
+ 530 068 НДС
Классическая проблема линейного планирования инфраструктуры (и нелинейного результата)
Давайте посчитаем на 400 ВМ разные конфигурации серверов. Разумеется, для статьи я сделаю некоторые допущения, ибо мы не реальный проект считаем:
-
Минимум 400 ВМ (можно больше, если память позволяет);
-
4 vCPU на одну ВМ (1600 на кластер);
-
Запас по CPU — классические 30% на узел;
-
Один CPU на сервер;
-
12 ГБ ОЗУ на одну ВМ (минимум 4800 ГБ на кластер);
-
Использование памяти — не более 75% кластера (значит физической должно быть минимум 4800 / 0,75 = 6400 ГБ);
-
Кластер N+1 (группа из N активных узлов + 1 дополнительный резервный узел на случай отказа любого из них);
-
Три года эксплуатации;
-
Средняя нагрузка сервера — не пиковая мощность CPU;
-
Электричество — условные 10 ₽/кВт·ч;
-
PUE — 1,3;
-
Цены серверов — условные для удобства.
Возьмём три конфигурации, чтобы было с чем сравнивать.
| Параметр | А | Б | В |
|---|---|---|---|
| Размер кластера (с N+1) | 18 (17 активных) | 10 (9 активных) | 6 (5 активных) |
| CPU на узел (ядра / потоки) | 32C / 64T | 64C / 128T | 96C / 192T |
| CPU на кластер | 576C / 1152T | 640C / 1280T | 576C / 1152T |
| Полезное CPU на кластер — количество активных узлов × запас 70% | 380C / 760T | 576C / 896T | 336C / 672T |
| ОЗУ на узел | 384 ГБ | 768 ГБ | 1280 ГБ |
| Полезная ОЗУ на узел (75%) | 288 ГБ | 576 ГБ | 960 ГБ |
| ОЗУ кластера | 6912 ГБ | 7680 ГБ | 7680 ГБ |
| ОЗУ кластера после отказа узла | 4896 ГБ | 5184 ГБ | 4800 ГБ |
| ВМ на узел | 24 | 48 | 80 |
| ВМ всего | 408 | 432 | 400 |
Выше в статье я уже говорил, что 64-ядерный CPU может разместить и больше ВМ, чем у него есть ядер и/или потоков, но память нашего кластера Б закончится раньше (с учётом предела в 75% на использование памяти и требований). Зато у него получится приличный запас по CPU.
Ремарка! Технически в виртуализации можно делать и переподписку оперативной памяти (Memory Oversubscription), но работает она совсем иначе и несёт больше рисков. Поскольку эта статья не про память, то этот момент подробно разбирать не будем. Отмечу лишь, что когда в кластере заканчивается реальная память — начинается активное использование подкачки (swap). Если довести до этого состояния, то скорость работы всех ВМ может упасть в десятки раз, а также получите риск падения системы (OOM Killer в Linux): при резкой пиковой нагрузке на большую часть ВМ начнётся аварийное завершение процессов.
Чтобы посчитать коэффициент переподписки CPU для архитектуры А, нужно 1632 vCPU (408 виртуалок требуют по 4 vCPU) поделить на 760 потоков, получаем 2,15:1. В архитектуре Б нужно 1728 vCPU разделить 896 потоков, получим всего 1,92:1. На 96-ядерном сервере В мы уже получаем самую высокую переподписку — 2,4:1.
Но обратите внимание, что переход с 32-ядерного на 64-ядерный CPU не уменьшает количество серверов пропорционально с 18 до 9, хотя рост ВМ и ОЗУ двукратный. А ещё интереснее переход с 64 на 96 ядер — там мы получаем рост ядер в 1,5 раза, а рост ОЗУ и ВМ в 1,66 раза и нелинейное снижение количества серверов.
Почему так? Переход на более мощные серверы/процессоры никогда не дает линейного роста из-за требований к отказоустойчивости (N+1) и округления серверов.
Ремарка! Математические расчёты часто показывают, что вам, например, нужно купить 2,3 сервера. Но на практике вы не можете купить 30% сервера, придётся округлить это число в большую сторону и развернуть 3 сервера.
Это и есть округление серверов — необходимость покупать и развёртывать только целое количество физических серверов, из-за чего часть купленной мощности неизбежно простаивает.
При этом отказоустойчивость крупных узлов обходится дороже в пропорциях. В конфигурации А мы взяли под резерв 5,5% всей инфраструктуры (1 из 18), в конфигурации Б — уже 10% (1 из 10), а в конфигурации В — 16,6% (1 из 6). Когда падает узел, оставшиеся хосты должны одновременно перерегистрировать и запустить ВМ из общего хранилища (SAN/NAS). И да, по законам комбинаторики и теории вероятности, 1 резервный узел на 17 активных — не так надёжно, как 1 на 5 (хоть и дешевле).
Когда падает сервер А, виртуалки безболезненно переезжают на оставшиеся 17 узлов (по 1,4 ВМ на узел). Если же падает сервер В, то 84 ВМ одновременно начинают мигрировать на оставшиеся 5 узлов. Нагрузка на СХД в моменте кратно возрастает. Если дисковая подсистема (особенно не All-Flash, а гибридные массивы) не рассчитана на такие пиковые IOPS, то в момент аварии присядут вообще все виртуалки в кластере.
Давайте посчитаем, что выгоднее по деньгам
Важное уточнение — все проекты уникальны, а потому универсального калькулятора нет. И это не говоря, что серверы у нас абстрактные (хотя я ориентируюсь на примерную стоимость реальных моделей), цены на электроэнергию могут сильно меняться (от десятков факторов), коэффициент PUE у всех разный, закупочные цены на оборудование — тоже. Чтобы получить точные расчёты под вашу конкретную задачу, её нужно подробно описать. Это можно сделать бесплатно — просто напишите нашим менеджерам в чат на сайте.
Итак, я покажу 3 варианта:
-
Бесплатный Proxmox VE (без коммерческой подписки). Для его работы не нужны обязательные платные лицензии (а функции виртуализации не урезаются без них) — только прямые руки, оборудование и админ с релевантным опытом.
Показатель за 3 года А Б В Серверов / CPU 18 10 6 Виртуалок 408 432 400 Железо 11,7 млн ₽ 11,0 млн ₽ 12,0 млн ₽ Электроэнергия + PUE 2,15 млн ₽ 1,88 млн ₽ 1,54 млн ₽ Proxmox VE 0 ₽ 0 ₽ 0 ₽ TCO (без ремонтов, простоев и стоимости обслуживания) 13,85 млн ₽ 12,88 млн ₽ 13,54 млн ₽ TCO на ВМ 33 950 ₽ 29 810 ₽ 33 850 ₽
В этом сценарии стоимость ПО не зависит ни от количества ядер, ни от числа серверов. Поэтому мощный CPU даёт эффект только там, где его дополнительные ядра действительно можно загрузить работой ВМ.
При этом Б (10 CPU) даёт минимальный TCO — 12,88 млн ₽, В (6 CPU) немного дороже — 13,54 млн ₽, А (18 CPU) — самый дорогой вариант за 13,85 млн ₽. Почему? 96-ядерные CPU позволяют сделать плотный кластер, но сами узлы В заметно дороже, а выигрыш по электроэнергии не компенсирует это. В кластере А меньше физической ОЗУ (которая нынче стоит дорого), но количество серверных баз нивелирует эту разницу и увеличивает энергопотребление.
С точки зрения качества виртуализации более плотный узел тоже не всегда лучше. Отказ одного сервера В затрагивает намного больше ВМ, поэтому требования к резерву CPU, СХД и скорости восстановления выше. При нормальной средней загрузке шесть мощных узлов могут работать эффективнее 18 простых, но цена сбоя высока.
Вывод: если гипервизор бесплатный, 64 ядра в нашей модели дают лучший баланс между плотностью, отказоустойчивостью и стоимостью.
-
Платный Proxmox VE. Платные подписки дают поддержку и доступ к Enterprise Repository. Сейчас Standard стоит примерно €550 за физический CPU-сокет в год. Proxmox лицензирует подписку по занятым физическим сокетам, а количество ядер на цену подписки не влияет. Все узлы кластера при этом должны использовать один уровень подписки. Резервные узлы тоже лицензируются, если они в кластере с активной ролью — в N+1 они входят в тот же кластер, поэтому лицензируем весь парк. Для удобства счёта в рублях возьмём условный курс в 100 ₽/€, а считать будем за 3 года.
Показатель за 3 года А Б В Серверов / сокетов 18 10 6 Виртуалок 408 432 400 Железо 11,7 млн ₽ 11,0 млн ₽ 12,0 млн ₽ Электроэнергия + PUE 2,15 млн ₽ 1,88 млн ₽ 1,54 млн ₽ Proxmox Standard 2,97 млн ₽ 1,65 млн ₽ 0,99 млн ₽ TCO 16,82 млн ₽ 14,53 млн ₽ 14,53 млн ₽ TCO на ВМ 41 230 ₽ 33 630 ₽ 36 325 ₽ Что изменилось при платной подписке?
Архитектуру, очевидно, выгоднее консолидировать в плотные узлы: Proxmox Standard оплачивается за физический CPU-сокет, а не за количество ядер. Поэтому один 96-ядерный процессор обходится по подписке ровно столько же, сколько один 32- или 64-ядерный. А более плотный CPU ещё и экономит стойко-места с электричеством.
Но даже здесь 96 ядер только сравняли В с Б по TCO на 3 года. Экономия почти полностью компенсирует более дорогие серверы В, но не перекрывает их, а TCO на виртуалку даже выше, хотя это можно решить переподпиской — и в реальной работе, вероятно, будет незаметно. И учтите, что в моих примерах идеальная утилизация — используется вся память и vCPU за вычетом запасов, что в реальной жизни почти неосуществимо.
Вывод: лицензирование по сокетам делает многоядерные CPU интереснее, но в нашей модели 64 ядра всё ещё дают лучший баланс. Чем выше утилизация CPU и чем больше кластер, тем сильнее преимущество 96-ядерных узлов (и процессоров с большим количеством ядер в целом).
-
Коммерческая виртуализация с лицензированием по физическим ядрам. Например, Microsoft лицензирует Windows Server / Hyper-V по физическим ядрам: учитываются все физические ядра сервера, минимум 16. Даже если у процессора 4 ядра, купить придётся базовый пакет на 16 ядер. Для многоядерных процессоров (как в наших примерах) докупаются дополнительные пакеты (например, по 2 или 4 ядра). В моём примере будет редакция Datacenter, так как на ней можно запускать неограниченное количество ВМ на лицензированном сервере. Но учтите, что дополнительно требуются клиентские лицензии доступа (Windows Server CAL) для каждого пользователя или устройства, обращающегося к хосту (разово, на всю инфраструктуру, поэтому в расчёт сравнения эта сумма не попадёт).
Напомню, что:
Параметр А (18) Б (10) В (6) Ядер на узел / на кластер 32 / 576 64 / 640 96 / 576 И лицензируете вы не используемое (например, 17 из 18 узлов × 70%), а вообще всё, что есть физически.
Мы возьмём среднюю стоимость официальной коммерческой лицензии Windows Server Datacenter (на 16 ядер) на российском рынке по каналам параллельного импорта (ESD/OEM с закрывающими документами для бизнеса). На сегодня это примерно 240 000 рублей за один 16-ядерный пакет. Цены приблизительны и на наглядность примера не влияют.
Показатель А (18) Б (10) В (6) Нужно лицензий на кластер 36 пакетов по 16 ядер 40 пакетов по 16 ядер 36 пакетов по 16 ядер Железо + электроэнергия 13,85 млн ₽ 12,88 млн ₽ 13,54 млн ₽ Ориентировочная стоимость Windows Server ~8,64 млн ₽ ~9,6 млн ₽ ~8,64 млн ₽ Итого TCO (за 3 года) 22,49 млн ₽ 22,48 млн ₽ 22,18 млн ₽ TCO на одну ВМ 55,12 тыс. ₽ 52,04 тыс. ₽ 55,45 тыс. ₽ Здесь дополнительные ядра скорее обуза, чем бесплатный способ увеличить плотность виртуализации, ведь лицензировать приходится все физические ядра CPU, независимо от того, насколько хорошо его ядра загружены.
Поэтому конфигурация Б с 64 ядрами требует лицензировать 640 физических ядер, тогда как А и В — по 576. В результате Б получает самую высокую стоимость Windows Server Datacenter — около 9,6 млн ₽ против 8,64 млн ₽ у А и В. Если бы мы рассматривали не абстрактный пример, а реальный, то 640 физических ядер не были бы загружены полностью, а значит TCO на одну ВМ в Б было бы выше. Аналогично в реальной жизни кластер В выиграл бы у кластера А по TCO за ВМ.
А если взять другой софт, например VMware, который лицензируется и по ядрам, и по подписке одновременно (на деле там всё ещё сложнее), то архитектура Б (с самой дорогой лицензией из-за большого количества ядер) будет всё сильнее проигрывать со временем, так как дорогую подписку придётся оплачивать ежегодно. И учтите, что в перспективе 5–10 лет подписочная Prox может выйти даже дороже, чем Windows Server с «вечной» лицензией (нюансы software assurance тоже не берём в расчёт).
Вывод: при поядерной модели нужно считать стоимость лицензирования каждого физического ядра вместе с плотностью ВМ, которая в реальной жизни не будет совпадать с лабораторными расчётами.
Подытог
Главный вывод такой — какой бы процессор, хранилище, софт вы ни использовали, надо искать золотую середину, а преимущество не всегда очевидно. Мой расчёт хорошо показывает, почему выбирать CPU для виртуализации только по количеству ядер — плохая идея.
Оптимальный CPU для виртуализации определяется не максимальным количеством ядер, а всей экономикой узла: стоимостью процессора и памяти, плотностью ВМ, энергопотреблением, требованиями N+1, стоимостью лицензий и тем, насколько стабильно эти ядра будут загружены.
В идеале сравнить минимум три разных кластера, посчитать и выбрать. В моём сравнении кластер Б, пожалуй, оказался самым сбалансированным вариантом. Но при 600, 800 или 1000 ВМ результат будет меняться.
от 241 500 ₽
8 392 ₽/мес в лизинг
от 197 951 ₽
+ 43 549 НДС
от 402 500 ₽
13 987 ₽/мес в лизинг
от 329 918 ₽
+ 72 582 НДС
от 21 455 164 ₽
745 567 ₽/мес в лизинг
от 17 586 200 ₽
+ 3 868 964 НДС
от 402 500 ₽
13 987 ₽/мес в лизинг
от 329 918 ₽
+ 72 582 НДС
Всё бы хорошо, но хранилище всё равно надо считать отдельно
В моём расчёте TCO я затронул только вычислительную часть, но общую ёмкость СХД (или любого другого хранилища) нужно тоже считать.
Допустим, на каждую ВМ требуется 2 ТБ логического пространства. Тогда 400 машин требуют 800 ТБ.
Если это, например, Ceph с тройной репликацией, потребуется около 2,4 ПБ сырой ёмкости без учёта дополнительных резервов, служебного пространства и требований к заполнению кластера.
Эта цифра не меняется от перехода с 32-ядерного CPU на 96-ядерный. Но количество узлов в архитектурах А, Б и В влияет на способ доставки данных.
При 18 узлах нагрузка на хранилище распределяется широко. При шести — каждый хост должен обслужить значительно больше ВМ. В HCI это, как правило, требует больше NVMe на узел и быструю сеть с широким каналом.
Вывод простой: выбор процессора CPU практически не влияет на стоимость самого хранения данных, но он критически влияет на архитектурную стоимость доставки этих данных до виртуальных машин.
Ваш чек-лист перед закупкой сервера для виртуализации
Правильный расчёт надо начинать не с выбора CPU, сервера, ПО или хранилища, а с существующей нагрузки.
-
Первым делом надо определить профиль ВМ: сколько vCPU и памяти им реально нужно, как меняется нагрузка в течение суток/недели, сколько IOPS, а какие ВМ вообще нельзя объединять на одном NUMA-узле.
ВАЖНО! Крайне не рекомендуется (а в некоторых случаях категорически запрещено) объединять ВМ, которые конкурируют за одни и те же критические ресурсы или требуют гарантированного минимального времени отклика процессора и памяти. Пример — две виртуальные машины с тяжелыми базами данных.
-
Когда провели предварительные тесты, нужно определить допустимый уровень переподписки и резерв под N+1 (или любой другой).
-
После этого можно конфигурировать серверы, выбирать CPU и память. Здесь вы определяете количество хостов.
-
Дальше считайте хранилище, сеть и PCIe. На этом этапе может оказаться, что новый CPU позволяет убрать четыре сервера из кластера, но заодно требует 100 Гбит/c и дорогущие NVMe-накопители.
-
В конце добавляйте лицензии, потребление электричества и считайте TCO. Какая конфигурация даст минимальную стоимость единицы полезной нагрузки при заданных ограничениях по производительности и отказоустойчивости, ту и берите.
Так что важен не сам процессор, а бизнес-задачи и архитектура вокруг него. В одном проекте выгоднее будет взять 32-ядерные CPU и много серверов. В другом — 96-ядерные процессоры в плотном односокетном кластере из серверов на AMD. В третьем окажется, что вычисления почти не влияют, а Ceph, SAN или лицензирование съедят большую часть бюджета.
Спасибо, что дочитали статью! Напомню, что специалисты Сервер Молл могут взять подбор серверного оборудования на себя — просто напишите в чат или позвоните, опишите задачу и оставьте пожелания. У нас выездная гарантия до 5 лет и бесплатная доставка до двери.