


Серверы для машинного обучения (ML)

от 53 156 327 ₽
1 847 182 ₽/мес в лизинг
от 43 570 760 ₽
+ 9 585 567 НДС
- 2x Intel Xeon Platinum 8480C (56C 105M Cache 2.00 GHz)
- 32x 64GB DDR5 4800MHz
- 9560-16iRAID
- 8x3.84T NVMe PCIe/ 2x960Gb NVMe M.2
- NVIDIA DELTA-NEXT Vulcan SXM5 8xNVIDIA H100 640G

от 9 000 000 ₽
312 750 ₽/мес в лизинг
от 7 377 049 ₽
+ 1 622 951 НДС
- 2x Intel Xeon 6 6710E (64C 96M Cache 2.40 GHz)
- 32GB DDR5 RDIMM 6400MHz
- noHDD (up to 8 SFF or 8 EDSFF 1T drives)
- NVIDIA H200 NVL Tensor Core GPUs

от 9 000 000 ₽
312 750 ₽/мес в лизинг
от 7 377 049 ₽
+ 1 622 951 НДС
- 1x NVIDIA GH200 NVL2 Grace Hopper 144GB HBM3e
- 960GB LPDDR5X
- NVIDIA GH200 NVL2


от 904 142 ₽
31 419 ₽/мес в лизинг
от 741 100 ₽
+ 163 042 НДС
- GB10 Grace Superchip
- 128GB (LPDDR5x)
- 1 x NVIDIA GB10

от 2 001 166 ₽
69 540 ₽/мес в лизинг
от 1 640 300 ₽
+ 360 866 НДС
- 2x AMD EPYC 9124 (16c/32t, 3.0GHz-3.6GHz, 200W)
- 128GB (DDR4 ECC REG)
- 2 x GIGABYTE Radeon AI PRO R9700 AI TOP

от 38 625 932 ₽
1 342 251 ₽/мес в лизинг
от 31 660 600 ₽
+ 6 965 332 НДС
- 2× Intel Xeon Scalable 4-го/5-го поколения (LGA-4677)
- 8192GB (DDR5 ECC REG)
- 8 x AMD Instinct MI300X


от 64 416 000 ₽
2 238 456 ₽/мес в лизинг
от 52 800 000 ₽
+ 11 616 000 НДС
- 2× AMD EPYC 9005 серии (SP5 (LGA 6096))
- 6144GB (DDR5 ECC REG)
- 8 x AMD Instinct MI355X

от 562 664 ₽
19 553 ₽/мес в лизинг
от 461 200 ₽
+ 101 464 НДС
- 2x Intel Xeon E5 2680v4 (14c/28t, 2.4GHz-3.3GHz, 120W)
- 128GB (DDR4 ECC REG)
- 4 x AMD Radeon Instinct MI50

от 17 333 272 ₽
602 331 ₽/мес в лизинг
от 14 207 600 ₽
+ 3 125 672 НДС
- 2x AMD EPYC 9575F (64c/128t, 3.3GHz-5GHz, 400W)
- 768GB (DDR5 ECC REG)
- 8 x NVIDIA RTX PRO 6000 Blackwell

от 99 664 484 ₽
3 463 341 ₽/мес в лизинг
от 81 692 200 ₽
+ 17 972 284 НДС
- 2× AMD EPYC 9005/9004 (SP5 (LGA 6096))
- 6144GB (DDR5 ECC REG)
- 8 x NVIDIA B200 SXM
Это больше срока гарантии производителя на новые серверы.
Обычно минут за 20–30. Мы оперативные.
доставка
Быстрая и бесплатная доставка по России. Максимально 4 дня с учётом отгрузки.
Затрудняетесь с выбором?
Мы сэкономим ваше время!
Поможем, расскажем, посоветуем

от 70 068 382 ₽
2 434 876 ₽/мес в лизинг
от 57 433 100 ₽
+ 12 635 282 НДС
- 2x Socket E (LGA-4677) и Intel Xeon Scalable 4/5-го поколения (до 350W TDP при воздушном охлаждении)
- 8192GB (DDR5 ECC REG)
- 8 x NVIDIA H200

от 8 591 118 ₽
298 541 ₽/мес в лизинг
от 7 041 900 ₽
+ 1 549 218 НДС
- 2x AMD EPYC 7513 (32c/64t, 2.6GHz-3.6GHz, 200W)
- 1024GB (DDR4 ECC REG)
- 6 x NVIDIA A100

от 85 480 520 ₽
2 970 448 ₽/мес в лизинг
от 70 066 000 ₽
+ 15 414 520 НДС
- 2× AMD EPYC 9004 (Socket SP5 / LGA6096, до 400W TDP на сокет)
- 6144GB (DDR5 ECC REG)
- 8 x NVIDIA H100

от 25 161 890 ₽
874 376 ₽/мес в лизинг
от 20 624 500 ₽
+ 4 537 390 НДС
- 2x AMD EPYC 7773X (64c/128t, 2.2GHz-3.5GHz, 280W)
- 2048GB (DDR4 ECC REG LR)
- 6 x NVIDIA H100

от 35 860 131 ₽
1 246 140 ₽/мес в лизинг
от 29 393 550 ₽
+ 6 466 581 НДС
- 2× AMD EPYC 9005/9004 (SP5 (LGA 6096))
- 6144GB (DDR5 ECC REG)
- 8 x AMD Instinct MI325X

от 21 478 832 ₽
746 389 ₽/мес в лизинг
от 17 605 600 ₽
+ 3 873 232 НДС
- 2x AMD EPYC 9965 (192c/384t, 2.25GHz-3.7GHz, 500W)
- 1536GB (DDR5 ECC REG)
- 8 x NVIDIA RTX PRO 6000 Blackwell

от 99 401 818 ₽
3 454 213 ₽/мес в лизинг
от 81 476 900 ₽
+ 17 924 918 НДС
- 2× 5th Gen и 4th Gen Intel Xeon Scalable (2× LGA4677, TDP до 350W)
- 8192GB (DDR5 ECC REG)
- 8 x NVIDIA B200 SXM

от 45 785 502 ₽
1 591 046 ₽/мес в лизинг
от 37 529 100 ₽
+ 8 256 402 НДС
- 2x AMD EPYC 9004 Series (до 128C/256T, заявлена поддержка до 400W TDP для air-cooling)
- 6144GB (DDR5 ECC REG)
- 8 x NVIDIA H100

от 86 056 360 ₽
2 990 458 ₽/мес в лизинг
от 70 538 000 ₽
+ 15 518 360 НДС
- 2x Intel Xeon Platinum 8570 (56c/112t, 2.1GHz-4GHz, 350W)
- 2000GB (DDR5 ECC REG)
- 8 x NVIDIA B200 SXM

от 73 169 988 ₽
2 542 657 ₽/мес в лизинг
от 59 975 400 ₽
+ 13 194 588 НДС
- 2× Intel Xeon Scalable 5-го
- 4096GB (DDR5 ECC REG)
- 8 x NVIDIA H200

от 15 946 559 ₽
554 143 ₽/мес в лизинг
от 13 070 950 ₽
+ 2 875 609 НДС
- AMD Instinct MI300A (AMD EPYC Zen 4)
- 512GB (HBM3)
- 4 x AMD Instinct MI300A

от 102 028 478 ₽
3 545 490 ₽/мес в лизинг
от 83 629 900 ₽
+ 18 398 578 НДС
- 2× Intel Xeon 6 (6900-серии) в сокетах LGA7529 с TDP до 500W
- 6144GB (DDR5 ECC REG)
- 8 x NVIDIA B200 SXM
Полезные статьи

Серверы для машинного обучения и анализа данных
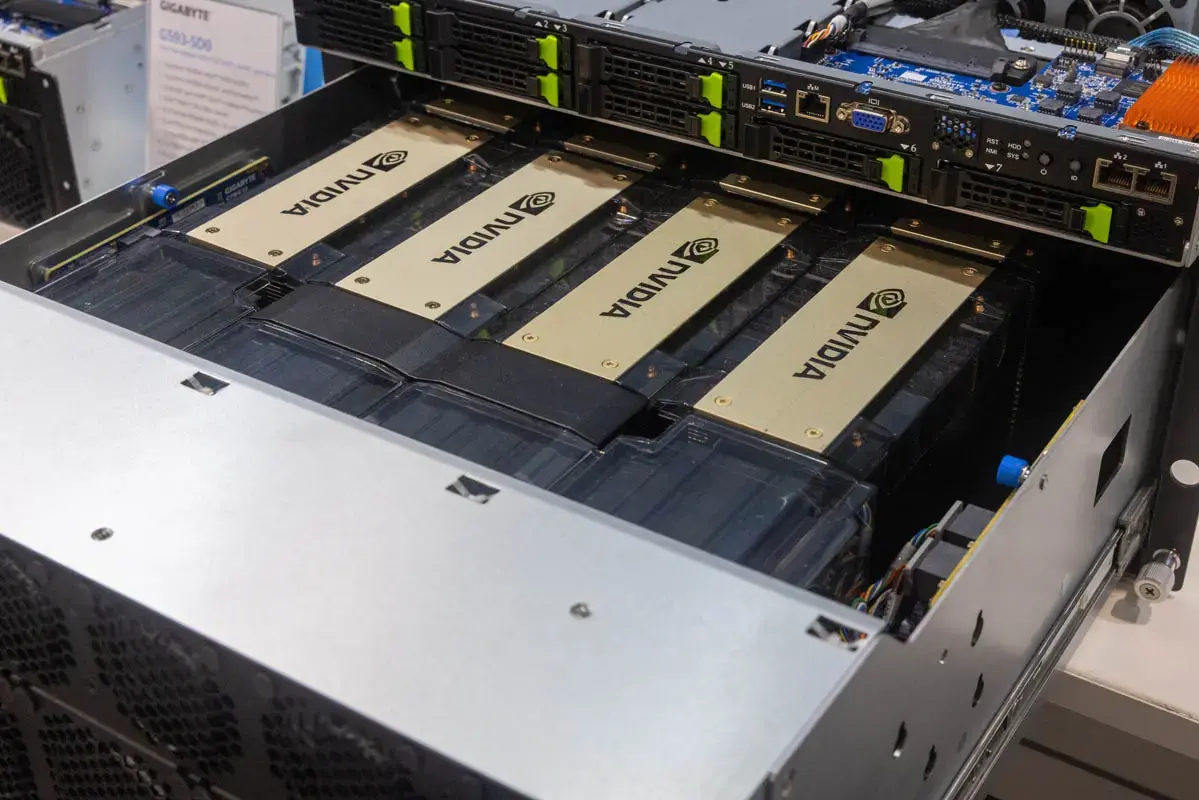
В каталоге Сервер Молл представлены серверы для машинного обучения и анализа данных на платформах Dell, HPE, Supermicro и GIGABYTE, а также системы NVIDIA DGX. В подборке есть решения с ускорителями NVIDIA и AMD. При выборе конфигурации учитывают используемые модели и библиотеки, объём данных, требования к скорости вычислений и условия размещения оборудования.
Какой сервер нужен для вашей задачи
- Подготовка и анализ данных. Для очистки наборов данных, расчёта признаков и статистического анализа важны производительность CPU, объём оперативной памяти и скорость чтения данных. Польза от GPU зависит от того, поддерживают ли ускорение выбранные алгоритмы и библиотеки.
- Обучение и дообучение нейросетей. Конфигурацию выбирают по потреблению памяти моделью и допустимому времени обучения. Учитывают размер обрабатываемых изображений или последовательностей, количество примеров в одном шаге и способ обновления параметров модели.
- Инференс — работа готовой модели. Оборудование подбирают под число одновременных запросов, допустимую задержку и требуемую пропускную способность. Для больших языковых моделей дополнительно задают длину контекста и формат хранения весов.
GPU: видеопамять и работа нескольких ускорителей
При сравнении серверов с GPU оценивают объём памяти каждого ускорителя, её пропускную способность и производительность в используемом формате вычислений. Требования к видеопамяти при обучении включают хранение весов, градиентов, состояний оптимизатора и промежуточных результатов. Для языкового инференса дополнительно учитывают KV-кэш — сохранённые данные обработки контекста, объём которых зависит в том числе от длины последовательностей и числа одновременно обрабатываемых запросов.
Несколько GPU позволяют запускать независимые эксперименты или распределять одну задачу между ускорителями. Во втором случае важны поддержка распределённых вычислений в ПО и скорость обмена данными. Память разных GPU не становится автоматически единым пространством для модели: способ её распределения определяет программная конфигурация.
Для задач с интенсивным обменом между ускорителями можно рассмотреть специализированные системы. Например, NVIDIA DGX H100 объединяет восемь GPU H100 с использованием NVLink и NVSwitch. Целесообразность такой платформы оценивают по масштабу обучения, загрузке оборудования и требованиям к размещению.
Процессоры, RAM и подсистема хранения
Даже при выполнении основных вычислений на GPU серверу нужны ресурсы для загрузки и подготовки данных. Процессоры выбирают с учётом параллельной обработки, декодирования и преобразования входных данных. Оперативную память рассчитывают под рабочие наборы, буферы и одновременно запущенные процессы. Фиксированное соотношение RAM и видеопамяти подходит не для каждого проекта.
При подборе накопителей учитывают скорость подачи данных, характер обращений и необходимую ёмкость. NVMe SSD можно использовать для активных наборов данных, временных файлов и контрольных точек обучения. Если данные находятся на внешнем хранилище, производительность оценивают вместе с сетевым подключением. Для распределённого обучения отдельно проверяют требования к связи между вычислительными узлами.
Совместимость и комплектация перед заказом
Выбор ускорителя связан с программной средой проекта. Для NVIDIA проверяют совместимость GPU, драйвера, CUDA и используемых библиотек; для AMD — поддержку конкретного ускорителя выбранной версией ROCm, операционной системой и фреймворком. Особенно это важно при переносе существующего проекта или выборе оборудования предыдущих поколений.
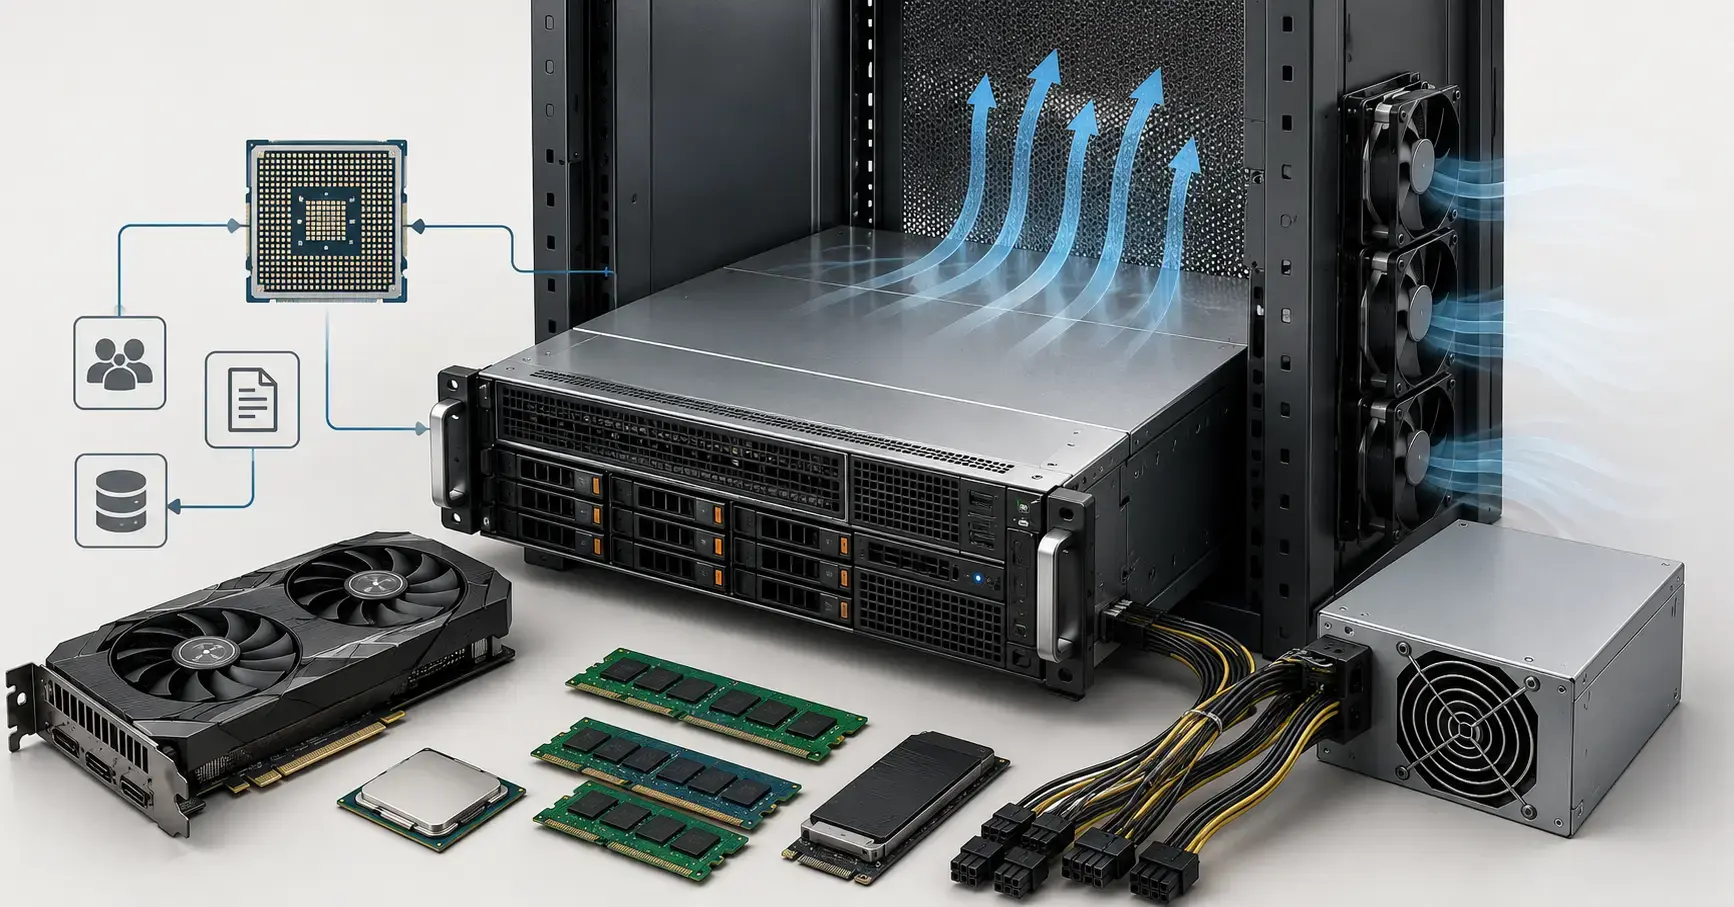
Возможность установки дополнительных GPU зависит от исполнения платформы: слотов и линий PCIe, габаритов ускорителей, питания и охлаждения. Для стоечного сервера также проверяют глубину и допустимую нагрузку стойки, доступную электрическую мощность и отвод тепла. Поддерживаемые платформой компоненты и фактически установленное оборудование сверяют отдельно в спецификации поставки.
Чтобы подобрать и купить сервер для Data Science или Machine Learning, передайте специалистам компании Сервер Молл название модели и используемое ПО, описание данных, режим работы и требования к производительности. На этой основе можно согласовать платформу, состав комплектующих и коммерческое предложение.
Вопросы и ответы
Не нашли нужной информации? Спросите — мы ответим!
Какие условия доставки?
Сроки доставки обычно составляют: 1 рабочий день по Москве и Санкт-Петербургу, по России — 3–5 рабочих дней (в зависимости от региона и перевозчика).
Что входит в гарантию?
Гарантия «Сервер Молл»: 5 лет на серверы и СХД, 1 год на комплектующие, 6 месяцев на Б/У накопители.
8 причин купить Серверы для машинного обучения (ML) в СЕРВЕР МОЛЛ
для людей, а не для галочки: без мелочей вроде платной доставки до транспортной компании
5 лет гарантии
с выездом
Берём все логистические и технические расходы на себя. Быстро реагируем, обрабатываем и закрываем заявки. Собственные сервисные центры, склады и надёжные логистические партнёры — всё, чтобы ваши бизнес-процессы работали 24/365.


СЕРВЕР МОЛЛ — крупнейший поставщик оборудования Dell, HPE и Lenovo в России и СНГ
Мы сэкономим ваше время!
Поможем, расскажем, посоветуем.


