

Серверы с GPU NVIDIA A100

от 8 591 118 ₽
298 541 ₽/мес в лизинг
от 7 041 900 ₽
+ 1 549 218 НДС

от 16 162 926 ₽
561 662 ₽/мес в лизинг
от 13 248 300 ₽
+ 2 914 626 НДС

от 18 628 546 ₽
647 342 ₽/мес в лизинг
от 15 269 300 ₽
+ 3 359 246 НДС

от 20 204 542 ₽
702 108 ₽/мес в лизинг
от 16 561 100 ₽
+ 3 643 442 НДС


от 17 580 469 ₽
610 921 ₽/мес в лизинг
от 14 410 220 ₽
+ 3 170 248 НДС

от 22 575 612 ₽
784 502 ₽/мес в лизинг
от 18 504 600 ₽
+ 4 071 012 НДС

от 19 181 903 ₽
666 571 ₽/мес в лизинг
от 15 722 872 ₽
+ 3 459 032 НДС
Полезные статьи
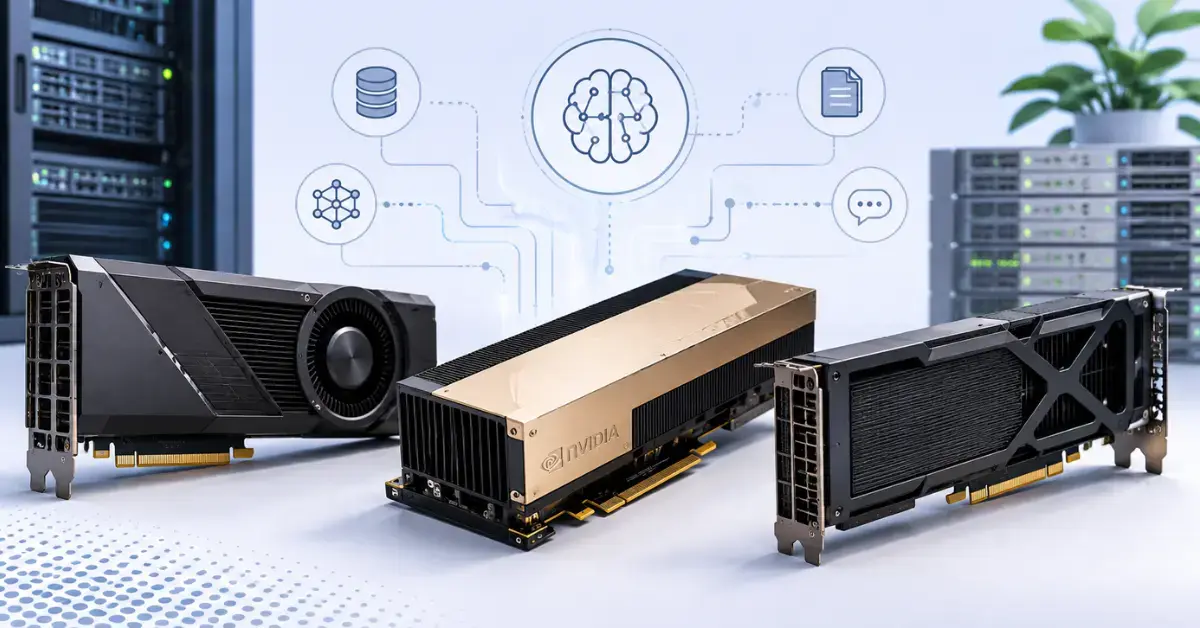
Серверы с GPU NVIDIA A100 для ИИ и высокопроизводительных вычислений
Серверы с GPU NVIDIA A100 используют для обучения нейросетей, инференса, анализа данных и научных расчётов. Ускоритель построен на архитектуре Ampere и поддерживает вычисления FP64, TF32, FP16, BF16 и INT8, поэтому одна платформа может выполнять как задачи машинного обучения, так и традиционные HPC-нагрузки.
NVIDIA A100 уже не относится к последнему поколению ускорителей, но остаётся практичным решением для многих проектов. Такой сервер имеет смысл, если программный стек проверен на Ampere, модели помещаются в доступную GPU-память, а преимущества H100 или H200 не оправдывают увеличение бюджета.
Для каких задач подходит NVIDIA A100
Сервер с NVIDIA A100 может использоваться как самостоятельный вычислительный узел или как часть GPU-кластера. Конкретная конфигурация зависит от размера модели, количества пользователей и требуемого времени выполнения задачи.
-
Обучение нейросетей. A100 ускоряет матричные вычисления и поддерживает форматы данных, применяемые в современных фреймворках машинного обучения.
-
Инференс. Сервер может обслуживать языковые модели, рекомендательные системы, компьютерное зрение и другие ИИ-сервисы.
-
Научные расчёты. Поддержка FP64 позволяет использовать A100 для моделирования, вычислительной физики, биоинформатики и инженерных задач.
-
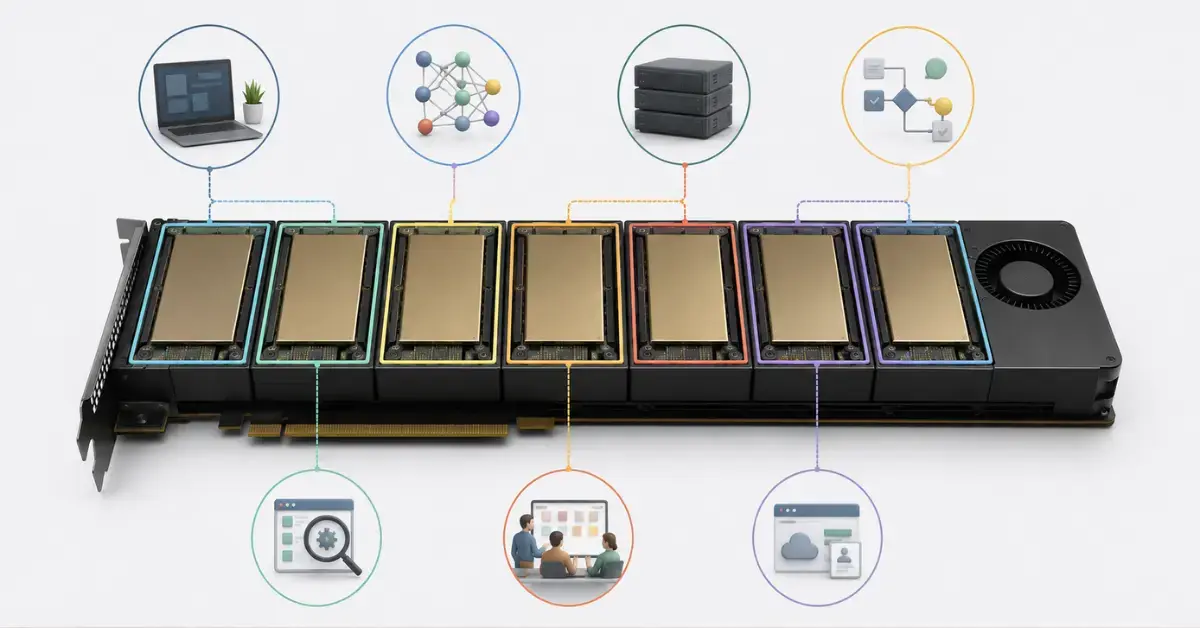
Совместная инфраструктура. Технология MIG разделяет одну A100 на несколько изолированных экземпляров, чтобы разные пользователи или приложения могли работать на общей GPU.
A100 особенно удобна в организациях, где уже используются CUDA, PyTorch, TensorFlow, TensorRT или контейнеры из каталога NVIDIA NGC. Знакомая программная среда упрощает перенос существующих нагрузок и снижает риск проблем с совместимостью.
A100 40 ГБ или 80 ГБ, PCIe или SXM
NVIDIA A100 выпускается с 40 ГБ памяти HBM2 и с 80 ГБ HBM2e. Версия на 80 ГБ позволяет размещать более крупные модели, увеличивать размер пакета и реже распределять задачу между несколькими ускорителями. Для обучения и инференса больших моделей объём памяти часто важнее разницы в пиковой вычислительной производительности.
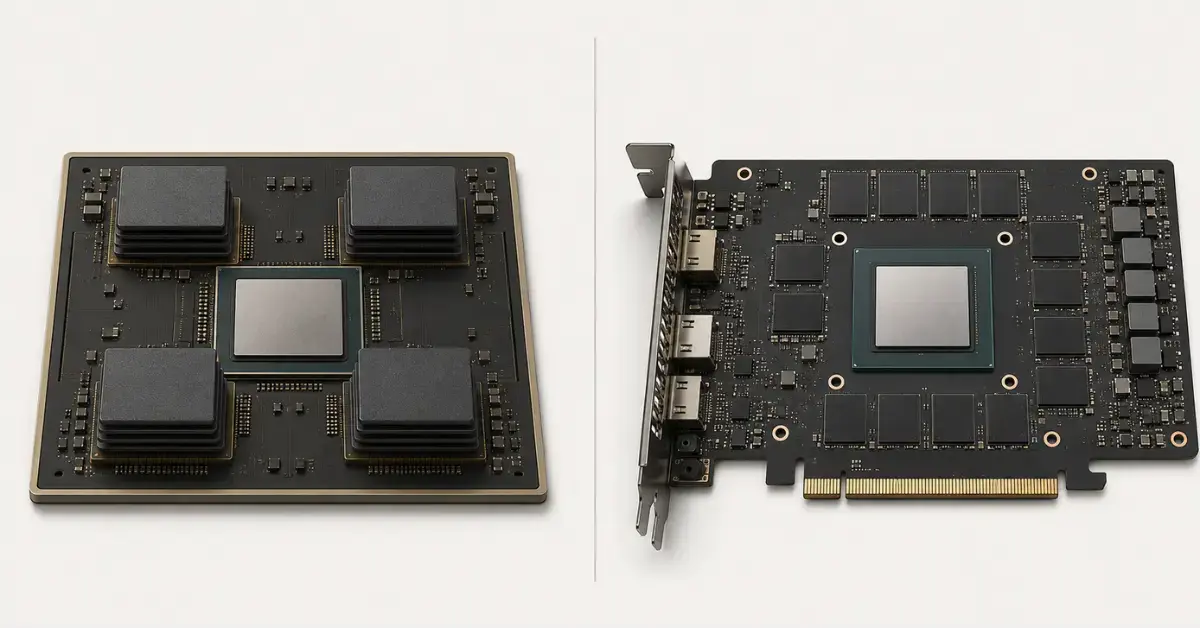
A100 PCIe подходит для более гибких серверных конфигураций. Такие ускорители устанавливаются в стандартные слоты и удобны, когда системе требуется одна, две или несколько GPU без интенсивного обмена между всеми видеокартами.
A100 SXM применяется в плотных вычислительных системах с NVLink и NVSwitch. Этот вариант выбирают, когда одна задача распределяется между несколькими GPU и регулярно передаёт между ними большие объёмы данных. В каталоге представлены готовые серверы NVIDIA HGX, а также стандартизированные системы NVIDIA DGX.
Сколько GPU A100 должно быть в сервере
Количество ускорителей определяют по размеру модели и тому, насколько хорошо программное обеспечение масштабируется на несколько GPU. Для разработки, инференса и отдельных научных расчётов может быть достаточно одной или двух A100. Конфигурации с четырьмя, шестью или восемью ускорителями используют для обучения крупных моделей и выполнения параллельных задач.
Суммарный объём памяти нескольких A100 не становится автоматически единым пулом. Чтобы использовать память и вычислительные ресурсы всех GPU, фреймворк должен поддерживать тензорный, конвейерный или другой вид параллелизма. Если приложение масштабируется плохо, добавление ускорителей не обеспечит пропорционального роста производительности.
Для одновременной работы нескольких команд можно использовать MIG. Одна A100 разделяется на несколько аппаратно изолированных экземпляров с выделенными ресурсами. Это повышает загрузку сервера, но не заменяет объединение GPU при запуске одной крупной модели.
Какие характеристики сервера важны кроме GPU
Процессоры сервера подготавливают данные, выполняют токенизацию и обслуживают прикладную часть системы. Оперативная память хранит датасеты и промежуточные результаты, а NVMe-накопители ускоряют загрузку моделей и сохранение контрольных точек. Недостаточная производительность любого из этих компонентов может привести к простою GPU.
Для систем с несколькими A100 необходимо проверить схему подключения ускорителей, количество линий PCIe и наличие NVLink или NVSwitch. При построении кластера важны пропускная способность сети и производительность общего хранилища. Оборудование также предъявляет повышенные требования к питанию, охлаждению и глубине серверной стойки.
A100 или ускорители нового поколения
NVIDIA A100 стоит сравнивать с более новыми ускорителями на реальной нагрузке. Серверы с NVIDIA H100 обеспечивают более высокую производительность в современных ИИ-задачах, а серверы с NVIDIA H200 дополнительно предоставляют больший объём и пропускную способность памяти.
При этом переход на новое поколение нужен не каждому проекту. Если модель укладывается в память A100, сроки расчёта устраивают заказчика, а программное обеспечение уже настроено, сервер на Ampere может оказаться экономически рациональнее. Другие варианты представлены в общей подборке серверов с GPU NVIDIA.
Цена и покупка сервера с NVIDIA A100
Цена сервера с NVIDIA A100 зависит от количества и версии ускорителей, процессоров, объёма оперативной памяти, накопителей, сетевых адаптеров и типа соединения между GPU. Стоимость плотных конфигураций также следует оценивать вместе с затратами на электропитание, охлаждение и сетевую инфраструктуру.
Специалисты Сервер Молл помогут подобрать сервер с A100 под обучение, инференс или HPC, проверить совместимость компонентов и подготовить спецификацию. Для расчёта достаточно сообщить используемое программное обеспечение, размер модели, объём данных и ожидаемую нагрузку.
Вопросы и ответы
Не нашли нужной информации? Спросите — мы ответим!
Какие условия доставки?
Сроки доставки обычно составляют: 1 рабочий день по Москве и Санкт-Петербургу, по России — 3–5 рабочих дней (в зависимости от региона и перевозчика).
Что входит в гарантию?
Гарантия «Сервер Молл»: 5 лет на серверы и СХД, 1 год на комплектующие, 6 месяцев на Б/У накопители.
Мы сэкономим ваше время!
Поможем, расскажем, посоветуем.


